SQLのLIMIT・OFFSETでページングする方法|計算式・遅くなる理由・キーセット方式
hr
ENG LIFE BLOG
「東京で始まる住所」「名前に田が入る人」のように、文字列の一部で検索したいときに使うのが SQL の LIKE です。% と _ という 2 つの記号(ワイルドカード)を覚えればすぐに使えますが、大文字・小文字の扱い、NULL、記号そのものの検索、インデックスが効くかどうかなど、知らないとはまる点もいくつかあります。
この記事では、Python 標準の SQLite で実行した結果を見ながら、次のことを解説します。SELECT 文の基本は「SQL入門:SELECT文の基本」で解説しています。
% と _ の意味と、前方一致・後方一致・部分一致の書き方% や _ そのものを探す ESCAPE 句と、GLOB との違いLIKE は「列の値が、指定したパターンに当てはまるか」を調べる演算子です。WHERE 列名 LIKE 'パターン' の形で書き、パターンの中では次の 2 つの記号が特別な意味を持ちます。
| 記号 | 意味 | 例 | 当てはまる例 |
|---|---|---|---|
% | 0 文字以上の任意の文字列 | '東京%' | 東京、東京都、東京都港区 |
_(アンダースコア) | ちょうど 1 文字の任意の文字 | '_田%' | 山田 太郎、吉田(田中 は当てはまらない) |
ポイントは、LIKE はいつも文字列の全体がパターンに当てはまるかを調べることです。「含んでいればよい」わけではありません。PostgreSQL の公式ドキュメントにも「LIKE のパターンマッチは常に文字列全体を対象にする。文字列のどこかに一致させたいなら、パターンの最初と最後を % にする必要がある」と書かれています。記号を 1 つも含まないパターンは、= とほぼ同じ働きになります。
次のコードを sql_like_practice.py という名前で保存してください。顧客(customers)テーブルをメモリー上に作り、入力した SQL を実行して結果を表示します。データは終了すると消えるので、何を試しても起動し直せば元に戻ります。
import sqlite3

con = sqlite3.connect(":memory:")
con.executescript("""
CREATE TABLE customers (
  id      INTEGER PRIMARY KEY,
  name    TEXT NOT NULL,
  address TEXT,
  email   TEXT NOT NULL
);
INSERT INTO customers VALUES
  (1, '山田 太郎',   '東京都千代田区',     'yamada@example.com'),
  (2, '田中 花子',   '東京都八王子市',     'hanako_t@example.com'),
  (3, '吉田 一郎',   '大阪府大阪市北区',   'yoshida@example.jp'),
  (4, '太田 恵',     '神奈川県横浜市西区', 'ota.megumi@example.com'),
  (5, '前田 健',     '東京都西東京市',     'maeda_k@example.jp'),
  (6, 'Tanaka Ken',  '東京都港区',         'Ken.Tanaka@Example.COM'),
  (7, 'たなか ゆき', '福岡県福岡市中央区', 'yuki@example.com'),
  (8, '山本 誠',     NULL,                 'yamamoto@example.com');
""")

print("SQL を入力して Enter(終了は exit)")
while True:
    sql = input("sql> ").strip()
    if sql.lower() in ("exit", "quit"):
        break
    if not sql:
        continue
    try:
        cur = con.execute(sql)
    except sqlite3.Error as e:
        print("エラー:", e)
        continue
    if cur.description is None:
        print("(結果の表はありません)")
        continue
    print(" | ".join(d[0] for d in cur.description))
    rows = cur.fetchall()
    for row in rows:
        print(" | ".join("NULL" if v is None else str(v) for v in row))
    print(f"({len(rows)} 行)")
保存したフォルダーで次のコマンドを実行すると「sql>」と表示されるので、この記事の SQL を 1 行で入力して Enter を押します(Windows 11 の Python 3.12・SQLite 3.45.3 で確認しました)。
py sql_like_practice.pyid 8 の山本さんは、住所が未登録という想定で address を NULL(値がない状態)にしています。id 6 のメールアドレスは、大文字・小文字の確認用にわざと大文字を混ぜています。
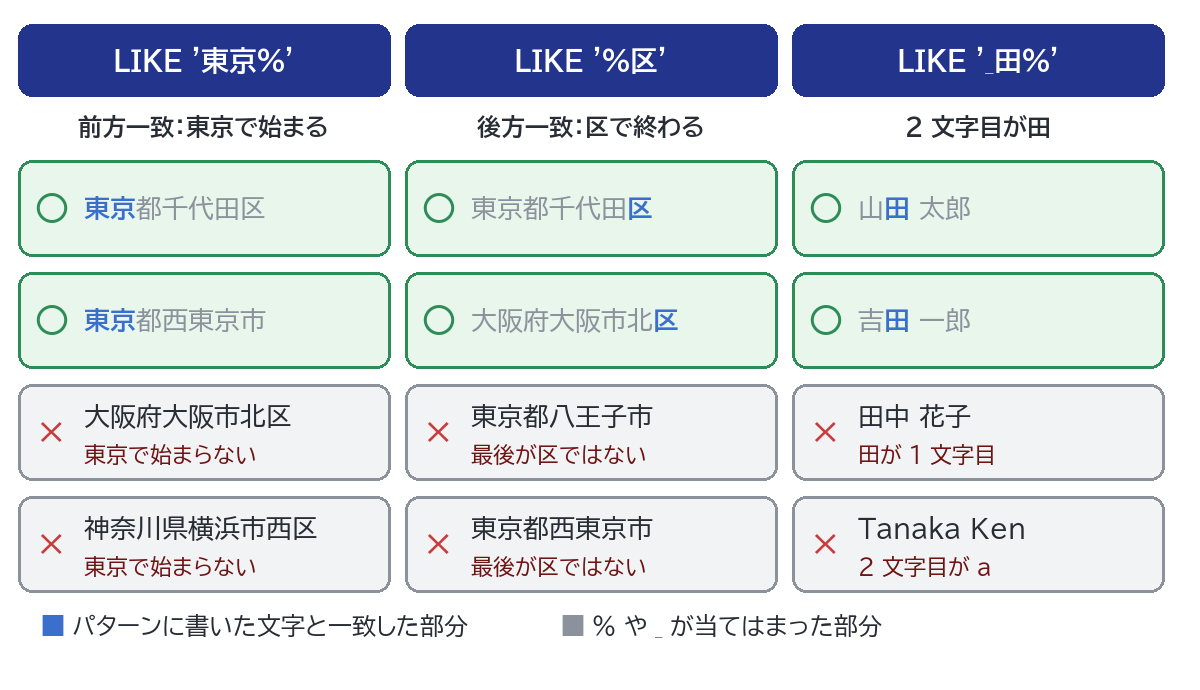
% をどこに置くかで、前方一致('東京%':東京で始まる)、後方一致('%区':区で終わる)、部分一致('%田%':どこかに田を含む)に分かれます。
SELECT name, address FROM customers WHERE address LIKE '東京%';name | address
山田 太郎 | 東京都千代田区
田中 花子 | 東京都八王子市
前田 健 | 東京都西東京市
Tanaka Ken | 東京都港区
(4 行)SELECT name, address FROM customers WHERE address LIKE '%区';name | address
山田 太郎 | 東京都千代田区
吉田 一郎 | 大阪府大阪市北区
太田 恵 | 神奈川県横浜市西区
Tanaka Ken | 東京都港区
たなか ゆき | 福岡県福岡市中央区
(5 行)_ はちょうど 1 文字に当てはまります。'_田%' は「1 文字目は何でもよく、2 文字目が田、その後は何でもよい」という意味です。
SELECT name, address FROM customers WHERE name LIKE '_田%';name | address
山田 太郎 | 東京都千代田区
吉田 一郎 | 大阪府大阪市北区
太田 恵 | 神奈川県横浜市西区
前田 健 | 東京都西東京市
(4 行)田中 花子は「田」が 1 文字目なので当てはまりません。部分一致の '%田%' にすると、田中 花子も含めた 5 件になります。SQLite では _ は日本語の 1 文字(漢字やひらがな)にも 1 つで当てはまりました。たとえば '__ __'(2 文字・空白・2 文字)では、山田 太郎・田中 花子・吉田 一郎の 3 件が返りました。
WHERE name LIKE '田中' は 0 行でした。名前は「田中 花子」なので、全体が「田中」と一致しないからです。「含む」検索のつもりで % を付け忘れると、このように何も見つかりません。
ただし SQLite では、記号がなくても = と完全に同じではありません。SELECT 'Tanaka Ken' = 'tanaka ken', 'Tanaka Ken' LIKE 'tanaka ken'; の結果は 0 | 1 で、LIKE だけが大文字・小文字の違いを無視しました(次の節で詳しく説明します)。
パターンに当てはまらない行を取り出すときは NOT LIKE を使います。「東京以外の住所の顧客」を探してみます。
SELECT name, address FROM customers WHERE address NOT LIKE '東京%';name | address
吉田 一郎 | 大阪府大阪市北区
太田 恵 | 神奈川県横浜市西区
たなか ゆき | 福岡県福岡市中央区
(3 行)全 8 件のうち東京は 4 件なので、残りは 4 件のはずですが、3 件しかありません。住所が NULL の山本さんが、LIKE にも NOT LIKE にも当てはまらないためです。NULL に LIKE をかけると、結果は真でも偽でもない NULL になります。
SELECT NULL LIKE '%'; の結果も NULL で、「何にでも当てはまる」'%' でさえ NULL には当てはまりません。WHERE address LIKE '%' の件数は 7 件でした。NULL の行も残したいときは、IS NULL を OR で足します。
SELECT name, address FROM customers WHERE address NOT LIKE '東京%' OR address IS NULL;name | address
吉田 一郎 | 大阪府大阪市北区
太田 恵 | 神奈川県横浜市西区
たなか ゆき | 福岡県福岡市中央区
山本 誠 | NULL
(4 行)MySQL の公式マニュアルにも「NULL NOT LIKE … は常に NULL」とあり、同じく IS NULL を足す例が載っています。NULL の扱い全般は「SQLのNULLの扱い方」で解説しています。
SQLite の LIKE は、初期設定では英字の大文字・小文字を区別しません。小文字で 'tanaka%' と書いても「Tanaka Ken」が見つかり、WHERE email LIKE '%@example.com' では「Ken.Tanaka@Example.COM」も含めた 6 件が返りました。
ただし、区別しないのは ASCII(半角)の英字だけです。SQLite の公式ドキュメントには「SQLite が理解する大文字・小文字は、初期設定では ASCII の文字だけ。ASCII の範囲を超える Unicode の文字では、LIKE は大文字・小文字を区別する」とあります。
SELECT 'ABC' LIKE 'abc', 'ABC' LIKE 'abc', 'タナカ' LIKE 'たなか', 'É' LIKE 'é';'ABC' LIKE 'abc' | 'ABC' LIKE 'abc' | 'タナカ' LIKE 'たなか' | 'É' LIKE 'é'
1 | 0 | 0 | 0
(1 行)一致したのは半角の ABC と abc だけでした。全角の英字、カタカナとひらがな、アクセント付きの É と é は、どれも別の文字として扱われます。
全角・半角やひらがな・カタカナの違いを無視して検索したいときは、LIKE だけでは足りません。保存するときに表記をそろえておく(たとえば英数字を半角にする)のが確実です。全角・半角をそろえる考え方は「Unicode 正規化」の記事も参考になります。
SQLite には、LIKE で大文字・小文字を区別させる PRAGMA case_sensitive_like = ON; という設定があります。実行すると 'abc' LIKE 'ABC' が 0 になり、'tanaka%' で「Tanaka Ken」が見つからなくなりました。
しかし、SQLite の公式ドキュメント(PRAGMA の説明)では、この PRAGMA は「非推奨(deprecated)で、後方互換のためだけに残されている。新しいアプリケーションは使わないこと」とされています。大文字・小文字を区別して探したいときは、次に紹介する GLOB を使うのが簡単です。
この記事では MySQL と PostgreSQL は実行していないので、公式ドキュメント(MySQL 8.4、PostgreSQL 18)で確認した内容だけを紹介します。MySQL は照合順序(collation)によって決まり、マニュアルの例では 'abc' LIKE 'ABC' が 1、大文字・小文字を区別する照合順序や BINARY を指定すると 0 です。PostgreSQL の LIKE は区別し、区別しないときは PostgreSQL 独自の ILIKE を使います(~~ が LIKE、~~* が ILIKE と同じ意味の演算子)。
「メールアドレスに _(アンダースコア)を含む顧客」を探そうとして、'%_%' と書くとどうなるでしょうか。
SELECT email FROM customers WHERE email LIKE '%_%';結果は 8 件すべてでした。_ が「任意の 1 文字」の意味になり、「1 文字以上ある文字列」という条件になってしまったからです。記号を文字として扱うには、ESCAPE 句で「エスケープ文字」を決め、記号の前に付けます。
SELECT email FROM customers WHERE email LIKE '%!_%' ESCAPE '!';email
hanako_t@example.com
maeda_k@example.jp
(2 行)ESCAPE '!' は「! の直後の % や _ は、記号ではなくただの文字」という指定です。SQLite の公式ドキュメントでは、エスケープ文字の後ろに %・_・エスケープ文字自身を書くと、それぞれ文字としての %・_・エスケープ文字 1 つに当てはまると説明されています。ESCAPE '\' にして '%\_%' と書いても同じ 2 件でした。
% も同じです。'500円OFF' LIKE '50%' は 1(「50 で始まる」の意味になる)ですが、'500円OFF' LIKE '50!%%' ESCAPE '!' は 0、'50%OFF' LIKE '50!%%' ESCAPE '!' は 1 でした。
エスケープ文字は 1 文字でなければならず、ESCAPE '!!' と書くと「ESCAPE expression must be a single character」というエラーになりました。エスケープ文字には、検索する値に出てこなさそうな文字を選びます。値に出てくる場合は、'a!!b' のように 2 つ重ねればその文字自身に当てはまります('a!b' LIKE 'a!!b' ESCAPE '!' は 1)。
SQLite には、LIKE に似た GLOB という演算子もあります。公式ドキュメントでは「GLOB は LIKE に似ているが、ワイルドカードに Unix のファイル名のパターン(グロブ)の書き方を使う。また LIKE と違って大文字・小文字を区別する」と説明されています。
| LIKE | GLOB | |
|---|---|---|
| 0 文字以上の任意の文字列 | % | * |
| 任意の 1 文字 | _ | ? |
| 文字の範囲 | なし | [0-9]、[a-m] など |
| 大文字・小文字 | ASCII の英字は区別しない | 区別する |
| ほかのデータベース | 標準 SQL で、どこでも使える | SQLite 独自 |
実行すると、name GLOB 'tanaka*' は 0 行、'Tanaka*' は Tanaka Ken の 1 行でした(大文字・小文字を区別)。email GLOB '*_*' は _ を含む 2 行で、GLOB では _ が記号ではないのでエスケープは不要です。email GLOB '[a-m]*' は hanako_t と maeda_k の 2 行で、大文字の K で始まる Ken.Tanaka は当てはまりませんでした。
反対に、LIKE で '*田*' と書くと 0 行でした。LIKE では * はただの文字です。ファイル名の指定(*.txt)に慣れていると間違えやすいので注意してください。
インデックス(索引)は、列の値を並べ替えて持っておき、目的の行をすばやく探すしくみです。LIKE でもインデックスが使える場合がありますが、条件があります。EXPLAIN QUERY PLAN を先頭に付けると、SQLite がどう探すつもりかを表示できるので、練習用のプログラムで確かめます。表示が「SEARCH … USING INDEX」ならインデックスを使った検索、「SCAN」なら全行を順に調べる検索です。
CREATE INDEX idx_customers_email ON customers(email);EXPLAIN QUERY PLAN SELECT * FROM customers WHERE email LIKE 'yama%';id | parent | notused | detail
2 | 0 | 0 | SCAN customers
(1 行)前方一致なのに SCAN になりました。SQLite の LIKE は大文字・小文字を区別しないのに、普通のインデックスは区別して並べている(BINARY という並べ方)ため、そのままでは使えないのです。大文字・小文字を区別する GLOB なら、同じインデックスで email GLOB 'yama*' が SEARCH customers USING INDEX idx_customers_email (email>? AND email<?) になりました。
LIKE に合わせて、大文字・小文字を区別しない並べ方(NOCASE)のインデックスを作ります。
CREATE INDEX idx_customers_email_nocase ON customers(email COLLATE NOCASE);パターンを変えて detail を比べた結果です。
| 条件 | 結果 |
|---|---|
email LIKE 'yama%' | SEARCH customers USING INDEX idx_customers_email_nocase (email>? AND email<?) |
email LIKE 'ya_a%'、LIKE 'yama%' ESCAPE '!' | SEARCH(同上) |
address LIKE '東京%'(address に NOCASE のインデックスあり) | SEARCH(日本語でも使われる) |
email LIKE '%example.com' | SCAN customers |
email LIKE '%yama%' | SCAN customers |
email LIKE '_ama%' | SCAN customers |
SEARCH の表示にある (email>? AND email<?) は、LIKE を範囲の条件に置き換えて探していることを表します。公式ドキュメント(クエリオプティマイザーの概要の「The LIKE optimization」)によると、パターンの先頭の記号でない部分を x としたとき、列 >= x AND 列 < y(y は x の最後の文字を 1 つ進めた文字列。’yama’ なら ‘yamb’)という条件を足して、インデックスの一部だけを読みます。先頭が % や _ だと x が決まらないので、全行を調べるしかありません。
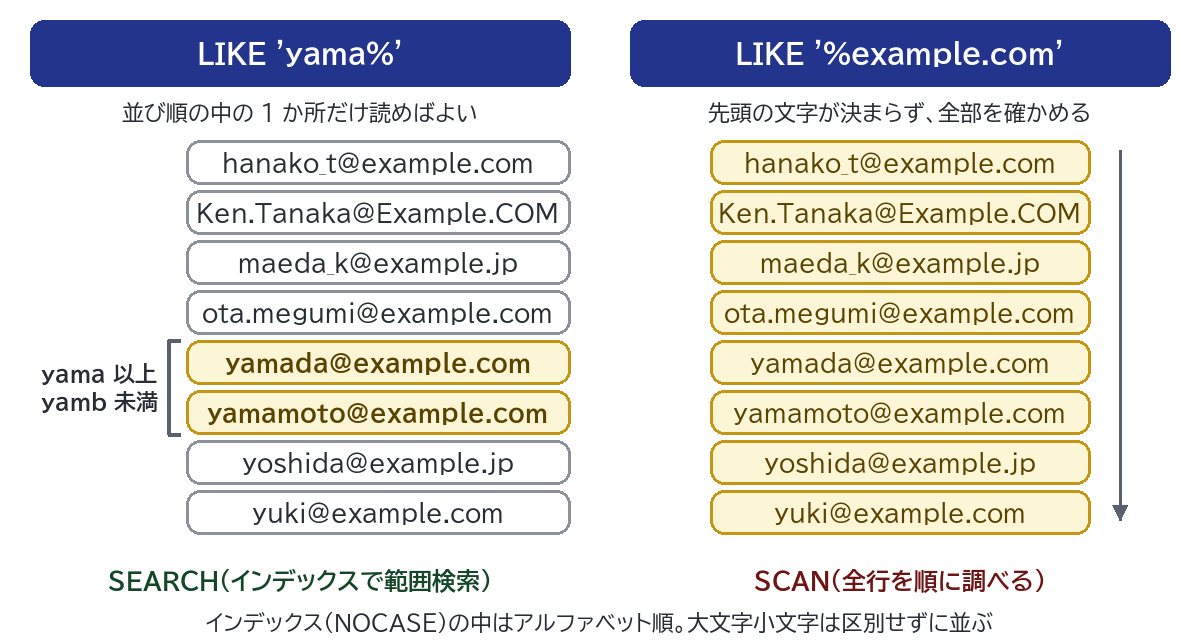
同じページに並んでいる、LIKE(と GLOB)にインデックスが使われる主な条件をかみくだくと次のとおりです。
この条件はデータベースごとに違います。MySQL や PostgreSQL では、それぞれの EXPLAIN で確かめてください。インデックスのしくみと、50 万行での速さの違いは「SQLのインデックスとは?」で実測しています。
検索フォームに入力された言葉で LIKE 検索をするときは、入力を SQL の文字列に直接つなげてはいけません。f 文字列で f"SELECT name FROM customers WHERE name LIKE '%{word}%'" のように組み立てると、入力に ' を含めるだけで SQL の意味を変えられてしまいます(SQL インジェクション)。
たとえば word に x%' OR 1=1 -- を入れると、組み立てられる SQL は SELECT name FROM customers WHERE name LIKE '%x%' OR 1=1 --%' で、-- 以降はコメント扱いになり、全員の名前が返りました。同じ入力をプレースホルダ(?)で渡すと、ただの文字列として扱われ、0 件でした。しくみと対策は「SQLインジェクションとは?」で詳しく解説しています。
プレースホルダを使うとき、'%?%' とは書けません(引用符の中の ? はただの文字になります)。% を付けるには次の 2 つの方法があります。
LIKE '%' || ? || '%'(|| は SQLite・PostgreSQL の文字列連結の演算子)LIKE ? にして、Python で "%" + word + "%" を渡すどちらもプレースホルダなので安全ですが、前方一致でインデックスを使いたいなら値の側で付けるほうが有利でした。NOCASE のインデックスを作ったテーブルで、Python から EXPLAIN QUERY PLAN を実行した結果です。
email LIKE ?           値='yama%'   → SEARCH customers USING INDEX idx_customers_email_nocase (email>? AND email<?)
email LIKE ? || '%'    値='yama'    → SCAN customers
email LIKE ?           値='%yama%'  → SCAN customers
? || '%' は「プレースホルダに渡した文字列そのもの」ではなく計算式なので、先ほどの条件 1 に当てはまらず SCAN になったと考えられます。
プレースホルダで渡しても、値の中の % と _ は LIKE の記号として働きます。利用者が「_」で検索すると全件が返ってしまうので、ESCAPE 句と組み合わせてエスケープします。次のコードを like_search.py として保存して実行しました。
import sqlite3

con = sqlite3.connect(":memory:")
con.executescript("""
CREATE TABLE customers (id INTEGER PRIMARY KEY, name TEXT NOT NULL, email TEXT NOT NULL);
INSERT INTO customers (name, email) VALUES
  ('田中 花子', 'hanako_t@example.com'),
  ('Tanaka Ken', 'Ken.Tanaka@Example.COM');
""")


def escape_like(text, esc="!"):
    """LIKE の記号(% と _)とエスケープ文字を、ただの文字として扱わせる"""
    return text.replace(esc, esc + esc).replace("%", esc + "%").replace("_", esc + "_")


def search(word):
    # 入力は ? で渡し、% は SQL の側で || を使って付ける
    sql = "SELECT email FROM customers WHERE email LIKE '%' || ? || '%' ESCAPE '!'"
    return [row[0] for row in con.execute(sql, (escape_like(word),))]


print("tanaka :", search("tanaka"))
print("_      :", search("_"))
print("%      :", search("%"))
py like_search.pytanaka : ['Ken.Tanaka@Example.COM']
_ : ['hanako_t@example.com']
% : []「_」で検索すると、_ を含む 1 件だけが返りました(% を含むアドレスはないので「%」は 0 件)。escape_like は、エスケープ文字自身(!)を最初に置き換えるのがポイントです。順番を逆にすると、% の前に付けた ! まで二重に置き換えてしまいます。sqlite3 モジュールの基本は「Pythonのsqlite3入門」で解説しています。
「東京か大阪の住所で、メールが .jp の人」を WHERE address LIKE '東京%' OR address LIKE '大阪%' AND email LIKE '%.jp' と書くと、AND が先に計算されるため、東京の 4 人全員と吉田 一郎の 5 行が返りました。OR の部分を (address LIKE '東京%' OR address LIKE '大阪%') のようにかっこで囲むと、吉田 一郎と前田 健の 2 行になります。長い条件は SQL 整形ツールで改行とインデントを付けると、かっこの対応が見やすくなります。
使えません。LIKE の記号は % と _ だけです。SQLite には REGEXP という演算子の書き方がありますが、公式ドキュメントのとおり regexp() 関数は初期状態では定義されておらず、WHERE name REGEXP '^.田' は「no such function: REGEXP」というエラーになりました(Python なら自分で関数を登録すれば使えます)。PostgreSQL は、同じ公式ページで SIMILAR TO や ~ による正規表現のマッチを説明しています。正規表現の書き方は「正規表現の基本」を参考にしてください。
% は 0 文字以上、_ はちょうど 1 文字。LIKE は文字列の全体がパターンに当てはまるかを調べるOR 列 IS NULL参考:SQLite「SQL Language Expressions」(The LIKE, GLOB, REGEXP, MATCH, and extract operators)、SQLite「The SQLite Query Optimizer Overview」(The LIKE Optimization)、SQLite「Pragma statements」(case_sensitive_like)、MySQL 8.4 Reference Manual「String Comparison Functions and Operators」、PostgreSQL 18「Pattern Matching」(2026 年 10 月に確認)