SQLのGROUP BYと集計関数|COUNT・SUM・AVG・HAVINGの使い方
hr
ENG LIFE BLOG
記事一覧や検索結果を「1 ページ 10 件」のように分けて表示することをページング(ページネーション)といいます。SQL では LIMIT と OFFSET を使うのが基本ですが、書き方によっては「同じ記事が 2 ページに出る」「後ろのページほど遅い」といった問題が起きます。
この記事では、Python 標準の SQLite で実行した結果を使って、次のことを解説します。
SELECT・WHERE・ORDER BY と LIMIT の基本は「SQL入門:SELECT文の基本」で解説しています。動作は Python 3.12・SQLite 3.45.3(Windows 11)で確認しました。
LIMIT 件数 は「最大で何行返すか」、OFFSET 件数 は「先頭から何行飛ばすか」を表します。LIMIT 5 OFFSET 10 なら、11〜15 行目の 5 行です。SQLite の公式ドキュメント(SELECT の LIMIT 句)には、OFFSET があると「最初の M 行を結果から除き、次の N 行を返す」(M が OFFSET、N が LIMIT の値)と書かれています。
記事一覧を想定した posts テーブル(13 件)を使います。次のコードを paging_practice.py という名前で保存してください。データはメモリー上だけに作られ、終了すると消えます。投稿日(posted_on)には、わざと同じ日付の記事を混ぜています。
import sqlite3

con = sqlite3.connect(":memory:")
con.execute("""
CREATE TABLE posts (
  id        INTEGER PRIMARY KEY,
  title     TEXT    NOT NULL,
  posted_on TEXT    NOT NULL
)""")
con.executemany(
    "INSERT INTO posts VALUES (?, ?, ?)",
    [
        (1, "Git の基本", "2026-09-01"),
        (2, "SQL 入門", "2026-09-01"),
        (3, "Python の f 文字列", "2026-09-03"),
        (4, "正規表現の基本", "2026-09-05"),
        (5, "JOIN の使い分け", "2026-09-05"),
        (6, "HTTP キャッシュ", "2026-09-05"),
        (7, "UTF-8 とは", "2026-09-08"),
        (8, "CORS とは", "2026-09-10"),
        (9, "Docker 入門", "2026-09-10"),
        (10, "ssh-keygen の使い方", "2026-09-12"),
        (11, "cron の書き方", "2026-09-15"),
        (12, "JSON の基本", "2026-09-15"),
        (13, "LIMIT と OFFSET", "2026-09-18"),
    ],
)

print("SQL を入力して Enter(終了は exit)")
while True:
    sql = input("sql> ").strip()
    if sql == "exit":
        break
    try:
        cur = con.execute(sql)
    except sqlite3.Error as e:
        print("エラー:", e)
        continue
    if cur.description is None:
        print("(結果の表はありません)")
        continue
    print(" | ".join(d[0] for d in cur.description))
    rows = cur.fetchall()
    for row in rows:
        print(" | ".join("NULL" if v is None else str(v) for v in row))
    print(f"({len(rows)} 行)")
保存したフォルダーで次のコマンドを実行すると「sql>」と表示されるので、この記事の SQL を 1 行で入力して Enter を押します。
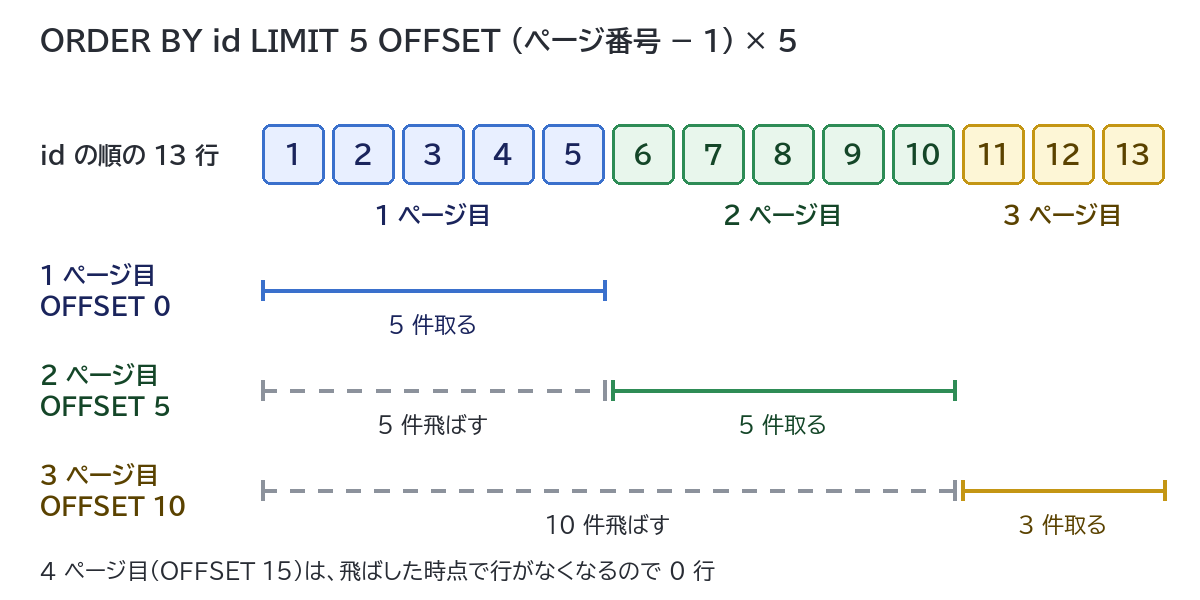
py paging_practice.py1 ページの件数を決めたら、OFFSET は次の式で求めます。ページ番号を 1 から数える場合、1 ページ目は何も飛ばさないので「− 1」が必要です。
OFFSET = (ページ番号 − 1) × 1ページの件数1 ページ 5 件で 2 ページ目を取り出すと、OFFSET は (2 − 1) × 5 = 5 です。
SELECT id, title, posted_on FROM posts ORDER BY id LIMIT 5 OFFSET 5;id | title | posted_on
6 | HTTP キャッシュ | 2026-09-05
7 | UTF-8 とは | 2026-09-08
8 | CORS とは | 2026-09-10
9 | Docker 入門 | 2026-09-10
10 | ssh-keygen の使い方 | 2026-09-12
(5 行)OFFSET を 0・10・15 にすると、1 ページ目は id 1〜5、3 ページ目は件数が足りない分だけ少ない id 11〜13 の 3 行、4 ページ目(OFFSET 15)は行がなくなってエラーにはならず 0 行でした(図 1)。
「全 3 ページ」のようなページ番号のリンクを作るには、総件数を COUNT(*) で数え、1 ページの件数で割って切り上げます。整数どうしの割り算は小数点以下が切り捨てられるので、「件数 − 1」を足してから割るのが定番の書き方です。
SELECT COUNT(*) AS total, (COUNT(*) + 5 - 1) / 5 AS pages FROM posts;total | pages
13 | 3
(1 行)単に COUNT(*) / 5 とすると、13 ÷ 5 が 2 になり、最後の 3 件(3 ページ目)へのリンクが作られません。
一覧と総件数を 1 回で取りたいときは、ウィンドウ関数(SQLite は 3.25.0 から対応)を使った SELECT id, title, COUNT(*) OVER () AS total FROM posts ORDER BY id LIMIT 5 OFFSET 10; のような書き方もあり、id 11〜13 の各行に total = 13 が付きました。ただし範囲外のページで 0 行になると、総件数も取れません。詳しくは「SQLのウィンドウ関数入門」で解説しています。
ページングで最も大事なのが ORDER BY です。SQLite の公式ドキュメントには「複数の行を返す SELECT に ORDER BY がない場合、行が返る順番は未定義(undefined)」「ORDER BY の式がすべて同じ値になる 2 つの行が、どちらの順で返るかも未定義」と書かれています。
PostgreSQL の公式ドキュメントも「LIMIT を使うときは、結果の行を一意な順番に決める ORDER BY を使うことが大切。そうしないと、予測できない一部の行が返る」と説明しています。LIMIT・OFFSET の値で実行計画が変わり、取り出した結果どうしが食い違うこともある、とも書かれています。
SQLite には、ORDER BY のない SELECT の順番を逆にする PRAGMA reverse_unordered_selects という設定があります。順番に頼ったコードを見つけるための設定です。SELECT id, title FROM posts LIMIT 3; は、普段は id 1・2・3 を返しましたが、PRAGMA reverse_unordered_selects = ON; を実行した後は次の結果になりました。SQL は同じでも、「最初の 3 件」がまったく別の行になります(確認後は PRAGMA reverse_unordered_selects = OFF; で戻します)。
id | title
13 | LIMIT と OFFSET
12 | JSON の基本
11 | cron の書き方
(3 行)ORDER BY を書いていても、並べ替えの列に同じ値があると順番は決まりません。投稿日の新しい順で 1 ページ目を取り出します。
SELECT id, posted_on FROM posts ORDER BY posted_on DESC LIMIT 5;id | posted_on
13 | 2026-09-18
11 | 2026-09-15
12 | 2026-09-15
10 | 2026-09-12
8 | 2026-09-10
(5 行)ここで、検索を速くするために posted_on へインデックスを作ったとします。
CREATE INDEX idx_posts_posted_on ON posts(posted_on);そのあと 2 ページ目(ORDER BY posted_on DESC LIMIT 5 OFFSET 5)を取り出すと、結果は次のとおりでした。
id | posted_on
8 | 2026-09-10
7 | 2026-09-08
6 | 2026-09-05
5 | 2026-09-05
4 | 2026-09-05
(5 行)
インデックスを使う実行計画に変わり、同じ日付の行(id 8 と 9、11 と 12 など)の並びが入れ替わったためです。その結果、1 ページ目にあった id 8 が 2 ページ目にもう一度出て、id 9 はどちらのページにも出ません。データ量の変化などでも実行計画は変わりえます。インデックスについては「SQLのインデックスとは?」で解説しています。
直し方は、ORDER BY の最後に重複しない列(主キーの id など)を加えることです。ORDER BY posted_on DESC, id DESC LIMIT 5 OFFSET 5 は、インデックスがあってもなくても、2 ページ目が同じ「8, 7, 6, 5, 4」になりました。
SQLite と MySQL では、LIMIT の後ろにカンマで 2 つの数字を書けます。このとき、前の数字が飛ばす件数(OFFSET)、後ろの数字が取り出す件数(LIMIT)です。
SELECT id, title FROM posts ORDER BY id LIMIT 5, 3;id | title
6 | HTTP キャッシュ
7 | UTF-8 とは
8 | CORS とは
(3 行)5 件飛ばして 3 件、つまり LIMIT 3 OFFSET 5 と同じ結果です。OFFSET を使う書き方とは数字の並びが逆なので、取り違えやすい書き方です。SQLite の公式ドキュメントも「直感に反する」が互換性のための意図的な仕様だと説明し、OFFSET キーワードを使う書き方を強くすすめています。
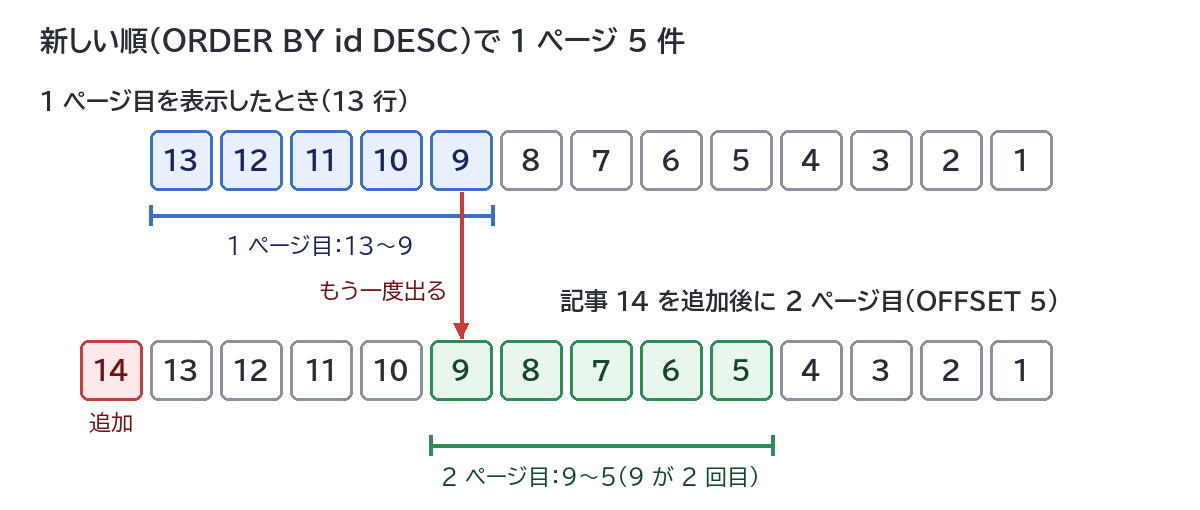
ORDER BY を一意にしても、OFFSET 方式には別の弱点があります。1 ページ目を見てから 2 ページ目を開くまでの間に記事が追加・削除されると、「何件飛ばすか」の基準がずれるのです。練習用スクリプトで、新しい順(id の大きい順)の 1 ページ目を取り出します。
SELECT id FROM posts ORDER BY id DESC LIMIT 5;結果は id 13・12・11・10・9 でした。ここで新しい記事を 1 件追加してから、2 ページ目を取り出します。
INSERT INTO posts VALUES (14, '新しい記事', '2026-09-20');SELECT id FROM posts ORDER BY id DESC LIMIT 5 OFFSET 5;id
9
8
7
6
5
(5 行)記事 14 が先頭に入ってすべての行が 1 つ後ろへずれたので、1 ページ目で見た記事 9 がもう一度出ました。逆に、DELETE FROM posts WHERE id IN (12, 14); で 2 件消してから同じ 2 ページ目を取り出すと「7, 6, 5, 4, 3」になり、記事 8 がどちらのページにも出ません。
もう 1 つの弱点は速度です。SQLite の公式ドキュメント(Row Values)によると、「LIMIT x OFFSET y」は実際には「LIMIT x+y」として計算し、最初の y 行を捨てています。PostgreSQL の公式ドキュメントにも「OFFSET で飛ばす行もサーバー内で計算する必要があるので、大きな OFFSET は非効率になりうる」とあります。100 万行の posts テーブルで測ってみます。
import random
import sqlite3
import statistics
import time

random.seed(1)
con = sqlite3.connect(":memory:")
con.execute("CREATE TABLE posts (id INTEGER PRIMARY KEY, "
            "title TEXT NOT NULL, posted_on TEXT NOT NULL)")
con.executemany(
    "INSERT INTO posts VALUES (?, ?, ?)",
    ((i, f"記事{i}", f"2026-{random.randint(1, 9):02d}-{random.randint(1, 28):02d}")
     for i in range(1, 1_000_001)),
)


def run(name, sql, params_list):
    print("■", name)
    for row in con.execute("EXPLAIN QUERY PLAN " + sql, params_list[0]):
        print("  計画:", row[3])
    for params in params_list:
        times = []
        for _ in range(5):
            start = time.perf_counter()
            rows = con.execute(sql, params).fetchall()
            times.append(time.perf_counter() - start)
        ms = statistics.median(times) * 1000
        print(f"  {ms:9.3f} ミリ秒  {params} → 先頭の行 {rows[0]}")


N = (0, 10_000, 100_000, 500_000, 999_990)
SELECT = "SELECT id, title, posted_on FROM posts "
run("id の順・OFFSET", SELECT + "ORDER BY id LIMIT 10 OFFSET ?",
    [(n,) for n in N])
run("id の順・キーセット", SELECT + "WHERE id > ? ORDER BY id LIMIT 10",
    [(n,) for n in N])

ORDER = "ORDER BY posted_on DESC, id DESC LIMIT 10"
run("新しい順・インデックスなし", SELECT + ORDER + " OFFSET ?", [(0,), (999_990,)])
con.execute("CREATE INDEX idx_posts_posted_on ON posts(posted_on, id)")
run("新しい順・OFFSET", SELECT + ORDER + " OFFSET ?", [(n,) for n in N])

# 前のページの最後の行(n 件目)を求めて、その続きを読む
lasts = [con.execute(SELECT + ORDER + " OFFSET ?", (n - 1,)).fetchone()
         for n in N[1:]]
run("新しい順・キーセット(行値)",
    SELECT + "WHERE (posted_on, id) < (?, ?) " + ORDER,
    [(r[2], r[0]) for r in lasts])
run("新しい順・キーセット(OR)",
    SELECT + "WHERE posted_on < ? OR (posted_on = ? AND id < ?) " + ORDER,
    [(r[2], r[2], r[0]) for r in lasts])
py offset_bench.pyこの PC で実行した結果(5 回の中央値)を表にまとめました。データはメモリー上にあるので、ディスクから読むデータベースの数字とは違いますが、増え方の傾向は分かります。
| 飛ばす件数 | id の順・OFFSET | 新しい順・インデックスあり・OFFSET |
|---|---|---|
| 0 | 0.006 ミリ秒 | 0.007 ミリ秒 |
| 10,000 | 0.057 ミリ秒 | 0.144 ミリ秒 |
| 100,000 | 0.520 ミリ秒 | 1.239 ミリ秒 |
| 500,000 | 2.781 ミリ秒 | 6.615 ミリ秒 |
| 999,990 | 5.669 ミリ秒 | 13.184 ミリ秒 |
どちらも、飛ばす件数にほぼ比例して時間が増え、最後のページは 1 ページ目の約 1,000〜2,000 倍かかりました。実行計画は、id の順が「SCAN posts」、インデックスありの新しい順が「SCAN posts USING INDEX idx_posts_posted_on」で、どちらも先頭から順に読んでいく SCAN です。
インデックスがない列で並べ替えると、さらに遅くなります。新しい順・インデックスなしでは計画に「USE TEMP B-TREE FOR ORDER BY」(並べ替え用の一時データを作る)が加わり、OFFSET 0 で 43.147 ミリ秒、OFFSET 999,990 では 2632.430 ミリ秒(約 2.6 秒)でした。
OFFSET の代わりに、前のページの最後の行の値を覚えておき、WHERE で「その続き」から読む方法をキーセット方式(シーク法、カーソル方式とも)と呼びます。id の小さい順なら次のように書きます。
SELECT id, title FROM posts WHERE id > 前のページの最後の id ORDER BY id LIMIT 5;練習用のテーブルで SELECT id, title FROM posts WHERE id > 5 ORDER BY id LIMIT 5; を実行すると、OFFSET 5 と同じ id 6〜10 が返りました。
offset_bench.py の結果では、実行計画が「SEARCH posts USING INTEGER PRIMARY KEY (rowid>?)」になり、主キーで続きの位置へ直接飛ぶので、id > 0 でも id > 999,990 でも 0.006 ミリ秒でした。OFFSET 999,990 の 5.669 ミリ秒と比べて約 1,000 倍速く、取り出した行も同じです。
投稿日の新しい順のように 2 つの列で並べるときは、(posted_on, id) < (?, ?) のように列をかっこでまとめて比べます。これを行値(row value)といい、SQLite の公式ドキュメントでもスクロールする一覧の例として、この書き方が OFFSET よりずっと効率的だと紹介されています(SQLite 3.15.0 から使えます)。並べ替えの列(posted_on, id)の複合インデックスが必要です。
| 何件目から読むか | OFFSET 方式 | キーセット(行値) | キーセット(OR で記述) |
|---|---|---|---|
| 10,000 | 0.144 ミリ秒 | 0.102 ミリ秒 | 0.464 ミリ秒 |
| 100,000 | 1.239 ミリ秒 | 0.023 ミリ秒 | 4.214 ミリ秒 |
| 500,000 | 6.615 ミリ秒 | 0.018 ミリ秒 | 20.284 ミリ秒 |
| 999,990 | 13.184 ミリ秒 | 0.188 ミリ秒 | 40.652 ミリ秒 |
行値の書き方は実行計画が「SEARCH posts USING INDEX idx_posts_posted_on (posted_on<?)」になり、どの位置でも 0.2 ミリ秒以下でした(同じ日付の行が約 4,000 行あるので、日付の中のどこから読むかで少し差が出ていると考えられます)。一方、同じ意味を posted_on < ? OR (posted_on = ? AND id < ?) と書くと、SQLite 3.45 では計画が「SCAN」になり、OFFSET 方式より遅くなりました。EXPLAIN QUERY PLAN で SEARCH になっているかを必ず確かめましょう。条件が長くなった SQL は、「SQL整形ツール」で WHERE・ORDER BY ごとに改行すると読みやすくなります。
キーセット方式は「何件飛ばすか」ではなく「どの行の続きか」で決めるので、途中で記事が追加・削除されてもずれません。1 ページ目の最後が記事 9 だったので、2 ページ目は次のように取り出します。
SELECT id FROM posts WHERE id < 9 ORDER BY id DESC LIMIT 5;前の節で記事 14 を追加し、記事 12・14 を削除したあとでも、結果は記事 9 の続きの「8, 7, 6, 5, 4」になりました。
| 項目 | OFFSET 方式 | キーセット方式 |
|---|---|---|
| 「5 ページ目」へ直接飛ぶ | できる | できない(前のページの最後の値が必要) |
| 後ろのページの速さ | 飛ばす件数に比例して遅くなる | ほぼ一定(インデックスが必要) |
| 途中で行が増減したとき | 重複・抜けが起きる | 起きない |
| 向いている画面 | ページ番号が並ぶ一覧、件数の少ない管理画面 | 「次へ」「もっと見る」、無限スクロール、全件を順に処理するバッチ |
Web アプリでは、ページ番号は URL の ?page=2 のように利用者から届きます。届いた文字列を SQL に直接つなげると SQL インジェクションの原因になるので、数値に変換し、範囲を決め、プレースホルダ(?)で渡します。SQLite では LIMIT と OFFSET にもプレースホルダを使えます。
import sqlite3

MAX_PER_PAGE = 50  # 1 ページの件数の上限


def to_int(text, default, low, high):
    """利用者の入力を整数にし、low〜high の範囲に収める"""
    try:
        value = int(text)
    except (TypeError, ValueError):
        return default
    return min(max(value, low), high)


def fetch_page(con, page_text, per_page_text="10"):
    per_page = to_int(per_page_text, 10, 1, MAX_PER_PAGE)
    total = con.execute("SELECT COUNT(*) FROM posts").fetchone()[0]
    total_pages = max(1, (total + per_page - 1) // per_page)  # 切り上げ
    page = to_int(page_text, 1, 1, total_pages)
    rows = con.execute(
        "SELECT id, title FROM posts "
        "ORDER BY posted_on DESC, id DESC "
        "LIMIT ? OFFSET ?",
        (per_page, (page - 1) * per_page),
    ).fetchall()
    return page, total_pages, rows


con = sqlite3.connect(":memory:")
con.execute("CREATE TABLE posts (id INTEGER PRIMARY KEY, title TEXT NOT NULL, posted_on TEXT NOT NULL)")
con.executemany("INSERT INTO posts VALUES (?, ?, ?)",
                [(i, f"記事{i}", f"2026-09-{i:02d}") for i in range(1, 14)])

for page_text, per_page_text in [("2", "5"), ("abc", "5"), ("-1", "5"),
                                 ("99", "5"), ("1", "100000")]:
    page, total_pages, rows = fetch_page(con, page_text, per_page_text)
    print(f"page={page_text!r} per_page={per_page_text!r} → {page}/{total_pages} ページ "
          f"id={[r[0] for r in rows]}")
py fetch_page.pypage='2' per_page='5' → 2/3 ページ id=[8, 7, 6, 5, 4]
page='abc' per_page='5' → 1/3 ページ id=[13, 12, 11, 10, 9]
page='-1' per_page='5' → 1/3 ページ id=[13, 12, 11, 10, 9]
page='99' per_page='5' → 3/3 ページ id=[3, 2, 1]
page='1' per_page='100000' → 1/1 ページ id=[13, 12, 11, 10, 9, 8, 7, 6, 5, 4, 3, 2, 1]数字でない「abc」や「-1」は 1 ページ目に、最後より後ろの「99」は最終ページに収まりました。1 ページの件数も上限(50 件)で止めているので、「100000」を渡されても一度に大量の行を返しません。範囲を決めておく理由は、ほかにもあります。
LIMIT -1 OFFSET 10 は 11 件目以降の 3 件をすべて返した)。件数をそのまま渡すと、全件を取り出されてしまうOverflowError: Python int too large to convert to SQLite INTEGER を出して止まるプレースホルダの使い方は「Pythonのsqlite3入門」、SQL インジェクションの仕組みは「SQLインジェクションとは?」で解説しています。
MySQL と PostgreSQL は手元で実行していません。以下は公式マニュアル(MySQL 8.4 の SELECT、PostgreSQL 18 の SELECT・LIMIT と OFFSET)で確認した内容です。
| 項目 | SQLite(実行して確認) | MySQL | PostgreSQL |
|---|---|---|---|
LIMIT 5 OFFSET 10 | 使える | 使える(PostgreSQL との互換のため) | 使える |
LIMIT 10, 5 | 使える | 使える(前が飛ばす件数) | 記載なし |
OFFSET 10 ROWS FETCH FIRST 5 ROWS ONLY | 構文エラー | SELECT のマニュアルに記載なし | 使える(SQL:2008 の標準の書き方) |
| 上限なしの指定 | LIMIT に負の数 | 大きな数を書く(マニュアルの例は 18446744073709551615) | LIMIT ALL または LIMIT に NULL(SQLite で NULL はエラー) |
| プレースホルダ | 使える | プリペアドステートメントで ? が使える | FETCH の構文ではパラメーターを使えると記載 |
PostgreSQL の FETCH FIRST は、件数を省略すると 1 件になり、WITH TIES を付けると最後の行と同じ順位の行もまとめて返します(ORDER BY が必須)。
1 から数えるページ番号で OFFSET page * 5 とすると、1 ページ目で 5 件飛ばしてしまい、最初の 5 件がどこにも表示されません。ページ番号を 0 から数えるのか 1 から数えるのかを決め、1 からなら「(page − 1) × 件数」にします。
決まった境目はなく、飛ばす件数に比例して少しずつ遅くなります。この記事の測定では、インデックスで並べられる場合は 100 万行目でも十数ミリ秒でしたが、インデックスのない列での並べ替えは約 2.6 秒かかりました。まずは並べ替えの列にインデックスがあるかを EXPLAIN QUERY PLAN で確かめ、後ろのページまでよく見られる一覧ならキーセット方式を検討します。
LIMIT 5, 3 は「5 件飛ばして 3 件」。OFFSET キーワードを使う書き方がおすすめ