SQLのビュー(VIEW)とは?CREATE VIEWの使い方と注意点を実行結果で解説
hr
ENG LIFE BLOG
SQL のサブクエリ(副問い合わせ)は、SELECT 文の中に、かっこで囲んだ別の SELECT 文を書く方法です。「平均より高い商品」「一度も注文していない顧客」のように、別の SQL で求めた結果を条件や表として使いたいときに使います。サブクエリが入れ子になって読みにくくなったら、WITH 句(CTE:共通テーブル式)で途中の結果に名前を付けると、上から順に読める SQL になります。
この記事では、練習用の商品・顧客・注文・社員テーブルで実際に実行した結果を見ながら、サブクエリの 3 つの使い方(WHERE・FROM・SELECT の中)、相関サブクエリ、NOT IN の中に NULL があると結果が 0 行になる落とし穴、WITH 句と再帰 CTE、JOIN への書き換えを解説します。SELECT 文の基本は「SQL入門:SELECT文の基本」、JOIN は「SQLのJOINの種類と使い分け」、GROUP BY は「SQLのGROUP BYと集計関数」で解説しています。
サブクエリは「SQL の中の SQL」です。まず内側の SELECT が結果を出し、外側の SQL がその結果を値や表として使う、と考えると分かりやすくなります。返す結果の形で、書ける場所が変わります。
| 書く場所 | サブクエリが返すもの | 例 |
|---|---|---|
| WHERE の中(比較) | 1 行 1 列の値 | price > (SELECT AVG(price) FROM products) |
| WHERE の中(IN) | 1 列の値の一覧 | id IN (SELECT product_id FROM orders) |
| WHERE の中(EXISTS) | 行があるかどうか | EXISTS (SELECT 1 FROM orders WHERE …) |
| FROM の中(派生テーブル) | 表(何行・何列でもよい) | FROM (SELECT … GROUP BY …) AS t |
| SELECT の中(スカラーサブクエリ) | 1 行 1 列の値 | SELECT name, (SELECT COUNT(*) FROM …) |
「スカラー」は「1 つの値」という意味で、数値や文字列と同じように式の中で使えます。
Python に標準で入っている SQLite(エスキューライト)を使います。次のコードを sql_subquery_practice.py という名前で保存してください。商品(products)・顧客(customers)・注文(orders)に加えて、上司と部下の関係を表す社員(employees)テーブルをメモリー上に作ります。データは終了すると消えます。
import sqlite3

con = sqlite3.connect(":memory:")
con.executescript("""
CREATE TABLE products (
  id       INTEGER PRIMARY KEY,
  name     TEXT    NOT NULL,
  category TEXT    NOT NULL,
  price    INTEGER
);
INSERT INTO products VALUES
  (1, 'ノートPC A',     'PC',         98000),
  (2, 'ノートPC B',     'PC',        128000),
  (3, 'マウス',         '周辺機器',    2980),
  (4, 'キーボード',     '周辺機器',    6480),
  (5, 'USBメモリ 32GB', '記録メディア', 1280),
  (6, '外付けSSD 1TB',  '記録メディア', 12800),
  (7, 'モニター 24型',  '周辺機器',   21800),
  (8, 'USBケーブル',    '周辺機器',    NULL);

CREATE TABLE customers (
  id   INTEGER PRIMARY KEY,
  name TEXT    NOT NULL
);
INSERT INTO customers VALUES
  (1, '佐藤'),
  (2, '鈴木'),
  (3, '高橋'),
  (4, '田中');

CREATE TABLE orders (
  id          INTEGER PRIMARY KEY,
  customer_id INTEGER NOT NULL,
  product_id  INTEGER NOT NULL,
  qty         INTEGER NOT NULL,
  ordered_on  TEXT    NOT NULL
);
INSERT INTO orders VALUES
  ( 1, 1, 3, 2, '2026-09-03'),
  ( 2, 2, 1, 1, '2026-09-10'),
  ( 3, 1, 4, 1, '2026-09-18'),
  ( 4, 3, 3, 1, '2026-09-25'),
  ( 5, 2, 5, 5, '2026-10-01'),
  ( 6, 1, 6, 1, '2026-10-02'),
  ( 7, 3, 7, 2, '2026-10-05'),
  ( 8, 2, 3, 3, '2026-10-08'),
  ( 9, 1, 2, 1, '2026-10-10'),
  (10, 3, 5, 2, '2026-10-12');

CREATE TABLE employees (
  id         INTEGER PRIMARY KEY,
  name       TEXT    NOT NULL,
  manager_id INTEGER
);
INSERT INTO employees VALUES
  (1, '山本', NULL),
  (2, '中村', 1),
  (3, '小林', 1),
  (4, '加藤', 2),
  (5, '吉田', 2),
  (6, '山田', 4),
  (7, '松本', 3);
""")

print("SQL を入力して Enter(終了は exit)")
while True:
    sql = input("sql> ").strip()
    if sql.lower() in ("exit", "quit"):
        break
    if not sql:
        continue
    try:
        cur = con.execute(sql)
    except sqlite3.Error as e:
        print("エラー:", e)
        continue
    if cur.description is None:
        print("(結果の表はありません)")
        continue
    print(" | ".join(d[0] for d in cur.description))
    rows = cur.fetchall()
    for row in rows:
        print(" | ".join("NULL" if v is None else str(v) for v in row))
    print(f"({len(rows)} 行)")
保存したフォルダーで次のコマンドを実行すると「sql>」と表示されるので、この記事の SQL を 1 行で入力して Enter を押します(Python 3.12・SQLite 3.45 で確認しました)。
py sql_subquery_practice.py商品・顧客・注文のデータは GROUP BY の記事と同じです。USBケーブル(id 8)は価格が NULL で一度も注文されておらず、田中さん(id 4)は注文が 0 件です。社員テーブルの manager_id は上司の id で、社長の山本さんだけ上司がいないので NULL です。
山本(社長)
├─ 中村
│   ├─ 加藤
│   │   └─ 山田
│   └─ 吉田
└─ 小林
└─ 松本平均を先に調べて数値を書き写すと、データが変わるたびに SQL を直す必要があります。サブクエリなら、平均の計算ごと条件に入れられます。
SELECT name, price FROM products WHERE price > (SELECT AVG(price) FROM products);name | price
ノートPC A | 98000
ノートPC B | 128000
(2 行)かっこの中は単独で実行すると 38762.857142857145 を返し、外側はそれを price > 38762.857… という条件として使います。WHERE price > AVG(price) は WHERE に集計関数を書いたことになりエラーになるので、サブクエリにします。
IN の右にサブクエリを書くと、「サブクエリが返した値の一覧のどれかと一致する行」を取り出せます。一度でも注文されたことがある商品を出してみます。
SELECT name FROM products WHERE id IN (SELECT product_id FROM orders) ORDER BY id;name
ノートPC A
ノートPC B
マウス
キーボード
USBメモリ 32GB
外付けSSD 1TB
モニター 24型
(7 行)マウスは 3 回注文されていますが、結果には 1 回しか出ません。IN は「一覧に含まれるかどうか」だけを調べるからです(JOIN との違いは後の章で説明します)。NOT IN にすると、注文されていない USBケーブルだけが返りました。ただし NOT IN には NULL の落とし穴があるので、後の章を必ず読んでください。
EXISTS(イグジスツ)は、サブクエリが 1 行でも返せば真、1 行も返さなければ偽になります。マウス(product_id 3)を買ったことがある顧客を出します。
SELECT name FROM customers AS c WHERE EXISTS (SELECT 1 FROM orders AS o WHERE o.customer_id = c.id AND o.product_id = 3);name
佐藤
鈴木
高橋
(3 行)サブクエリの中に外側の顧客を表す c.id があり、顧客 1 人ずつ「この人のマウスの注文はあるか」を調べています(相関サブクエリ。後の章で扱います)。PostgreSQL の公式ドキュメントには「EXISTS の結果は行が返るかどうかだけで決まるので、EXISTS(SELECT 1 WHERE ...) と書くのが一般的な慣習」とあり、「1」に意味はありません。
NOT EXISTS にすると「1 件もない」を調べられます。注文が 1 件もない顧客を出すと、田中さんが返ります。
SELECT name FROM customers AS c WHERE NOT EXISTS (SELECT 1 FROM orders AS o WHERE o.customer_id = c.id);name
田中
(1 行)FROM の中にサブクエリを書くと、その結果を 1 つのテーブル(派生テーブル)として扱えます。「集計した結果を、さらに集計したい」ときに使います。顧客ごとの購入金額の平均を求めてみます。
SELECT AVG(total) AS 平均購入金額 FROM (SELECT o.customer_id, SUM(p.price * o.qty) AS total FROM orders AS o JOIN products AS p ON o.product_id = p.id GROUP BY o.customer_id) AS t;平均購入金額
105240.0
(1 行)内側のサブクエリが「佐藤 153,240・鈴木 113,340・高橋 49,140」という 3 行の表を作り、外側の AVG がその 3 つを平均しています。AVG(SUM(...)) のように集計関数を重ねることはできないので、このように 2 段階に分けます。
末尾の AS t は派生テーブルの別名です。SQLite では省略しても同じ結果が返りましたが、MySQL の公式マニュアルには「FROM 句のテーブルにはすべて名前が必要なので、[AS] 別名は必須」とあります。PostgreSQL で省略できるようになったのも 16 からです(リリースノートで確認)。派生テーブルには必ず別名を付けると覚えておきましょう。
SELECT の列の位置に 1 行 1 列を返すサブクエリを書くと、行ごとに計算した値を列として追加できます。顧客ごとの注文数と最終注文日を出してみます。
SELECT c.name, (SELECT MAX(o.ordered_on) FROM orders AS o WHERE o.customer_id = c.id) AS 最終注文日 FROM customers AS c;name | 最終注文日
佐藤 | 2026-10-10
鈴木 | 2026-10-08
高橋 | 2026-10-12
田中 | NULL
(4 行)注文のない田中さんは NULL です。PostgreSQL の公式ドキュメントにも「スカラーサブクエリが 1 行も返さないときはエラーにならず NULL になる」とあります。MAX を COUNT(*) に変えると、田中さんは 0 になりました(COUNT は 0 件でも 0 を返すため)。
スカラーサブクエリは必ず 1 行 1 列を返すように書きます(2 列だと SQLite では「sub-select returns 2 columns – expected 1」のエラー。2 行以上の場合は「よくある間違い」で説明します)。
サブクエリには 2 種類あります。最初の「平均より高い商品」のように内側だけで実行できるものと、EXISTS やスカラーサブクエリの例のように外側の列(c.id など)を使うものです。後者を相関サブクエリといい、外側の 1 行ごとに、その行の値を入れてサブクエリを計算する、と考えると分かりやすくなります。
「自分のカテゴリの中で平均より高い商品」は、相関サブクエリでも書けます。
SELECT p.name, p.category, p.price FROM products AS p WHERE p.price > (SELECT AVG(p2.price) FROM products AS p2 WHERE p2.category = p.category);name | category | price
ノートPC B | PC | 128000
外付けSSD 1TB | 記録メディア | 12800
モニター 24型 | 周辺機器 | 21800
(3 行)外側で「マウス(周辺機器)」の行を見ているときは、サブクエリが周辺機器の平均 10,420 を計算し、2,980 > 10,420 かを判定します。同じテーブルを内と外で使うので、p と p2 のように別の別名を付けて、どちらの列かを区別するのがポイントです。条件の > を =、AVG を MAX に変えると「カテゴリごとの最高値の商品」を出せます。
サブクエリで最も気を付けたいのがこれです。社員テーブルから「部下がいない社員(だれの上司にもなっていない社員)」を出すつもりで、次のように書いたとします。
SELECT name FROM employees WHERE id NOT IN (SELECT manager_id FROM employees);name
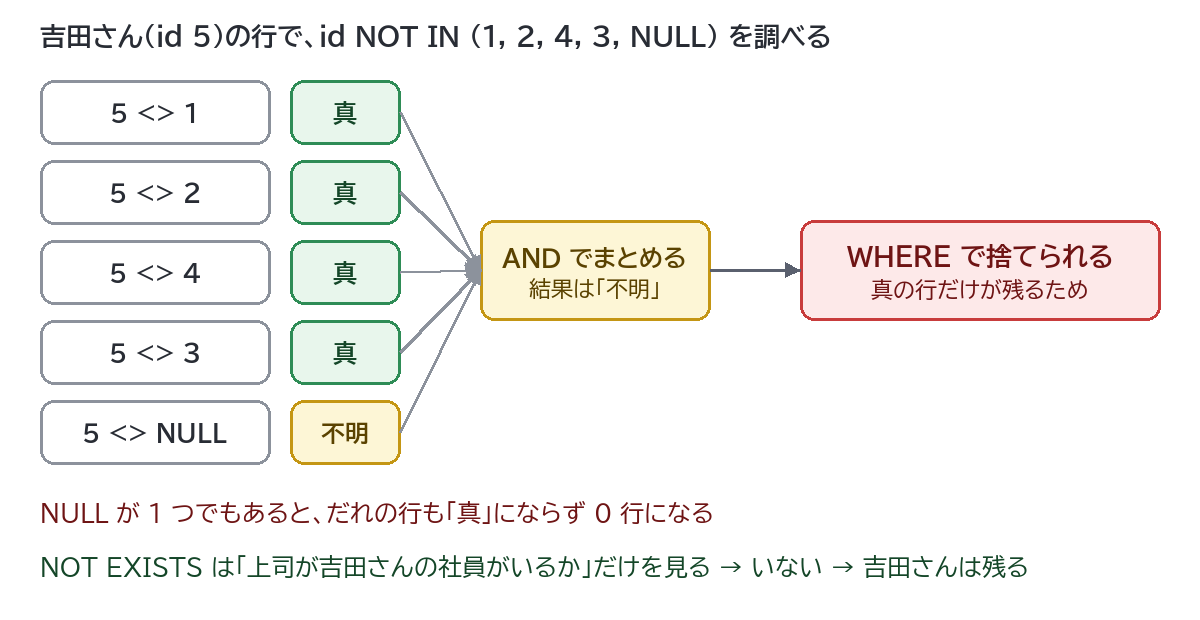
(0 行)吉田・山田・松本の 3 人が出るはずなのに、エラーにもならず 0 行です。原因は、サブクエリの結果に社長の manager_id の NULL が含まれていることです。
id NOT IN (1, 2, 4, 3, NULL) は、「id が 1 でも 2 でも 4 でも 3 でも NULL でもない」という意味です。NULL は「分からない値」なので、「id が NULL と等しくない」かどうかは「分からない(NULL)」になります。値を直接書いて確かめると、次のようになりました。
SELECT 7 NOT IN (1, 2, NULL), 1 NOT IN (1, 2, NULL);7 NOT IN (1, 2, NULL) | 1 NOT IN (1, 2, NULL)
NULL | 0
(1 行)一覧に NULL があると、NOT IN は「偽(0)」か「NULL」にしかならず、決して「真」になりません。WHERE は真の行だけを残すので、結果は必ず 0 行です。これは SQL の決まりで、PostgreSQL の公式ドキュメントにも「等しい値がなく、右側の行に 1 つでも NULL があると、NOT IN の結果は真ではなく NULL になる」とあります。テストデータでは動き、本番で NULL が 1 件入った途端に 0 行になるのが怖いところです。NOT IN のサブクエリは NOT EXISTS で書き直すのが安全です。
SELECT e.name FROM employees AS e WHERE NOT EXISTS (SELECT 1 FROM employees AS s WHERE s.manager_id = e.id);name
吉田
山田
松本
(3 行)NOT EXISTS は「条件に合う行が 1 行もない」かどうかだけを見るので、NULL の行があっても影響を受けません(s.manager_id = e.id が NULL になる行は「合う行」に数えられないだけです)。NOT IN を使い続けるなら、WHERE manager_id IS NOT NULL をサブクエリに付けて NULL を除く方法もあり、同じ 3 人が返りました。ただし付け忘れが起きやすいので、NOT EXISTS に統一しておくほうが間違いを防げます。
WITH 句を使うと、サブクエリに名前を付けて SQL の先頭に書き出せます。これを CTE(共通テーブル式)といいます。「平均購入金額より多く買っている顧客」を、WITH で書いてみます。
WITH customer_totals AS (
  SELECT o.customer_id, SUM(p.price * o.qty) AS total
  FROM orders AS o
  JOIN products AS p ON o.product_id = p.id
  GROUP BY o.customer_id
)
SELECT c.name, t.total
FROM customer_totals AS t
JOIN customers AS c ON c.id = t.customer_id
WHERE t.total > (SELECT AVG(total) FROM customer_totals)
ORDER BY t.total DESC;
「① 顧客ごとの合計を作る → ② 平均より多い顧客を出す」と上から順に読めます。練習用のスクリプトでは、改行をスペースに置き換えて 1 行で入力してください(SQL 整形ツールでモード「圧縮」を選ぶと 1 行にできます)。結果は次のとおりです。
name | total
佐藤 | 153240
鈴木 | 113340
(2 行)
同じ処理を派生テーブルで書くと、顧客ごとの合計を出すサブクエリを FROM と WHERE の 2 か所に書く必要があります。WITH なら 1 回定義した名前を何度でも参照できるのが大きな利点です。
CTE は WITH a AS (...), b AS (...) のようにカンマで区切って複数書け、後ろの CTE から前の CTE を参照できます。段階ごとに名前を付ければ、CTE を 1 つずつ確かめられます。
WITH 句は SQLite・PostgreSQL のほか、MySQL では 8.0 から使えます(公式マニュアル「What Is New in MySQL 8.0」で確認)。
WITH RECURSIVE を使うと、CTE の中で自分自身を参照できます。これを再帰 CTE といい、「最初の行」と「前の結果から次の行を作る SELECT」を UNION ALL でつなげて書きます。次の行が 1 行もできなくなったところで止まります。
WITH RECURSIVE nums(n) AS (SELECT 1 UNION ALL SELECT n + 1 FROM nums WHERE n < 5) SELECT n FROM nums;n
1
2
3
4
5
(5 行)SELECT 1 で最初の行(n = 1)を作り、直前に作った行に SELECT n + 1 FROM nums WHERE n < 5 を当てはめて 2・3・4・5 と作ります。n = 5 の行は WHERE n < 5 に合わないので、新しい行ができずに終わります。
連番は、データのない日も含めた日別の集計に役立ちます。10 月 1 日〜7 日の日付を作り、注文を LEFT JOIN すると、orders を GROUP BY するだけでは出てこない「注文がない日」も 0 件として出せます(date(d, '+1 day') は SQLite の日付関数です。PostgreSQL・MySQL では日付の足し算の書き方が違います)。
WITH RECURSIVE days(d) AS (SELECT '2026-10-01' UNION ALL SELECT date(d, '+1 day') FROM days WHERE d < '2026-10-07') SELECT days.d AS 日付, COUNT(o.id) AS 注文数 FROM days LEFT JOIN orders AS o ON o.ordered_on = days.d GROUP BY days.d ORDER BY days.d;日付 | 注文数
2026-10-01 | 1
2026-10-02 | 1
2026-10-03 | 0
2026-10-04 | 0
2026-10-05 | 1
2026-10-06 | 0
2026-10-07 | 0
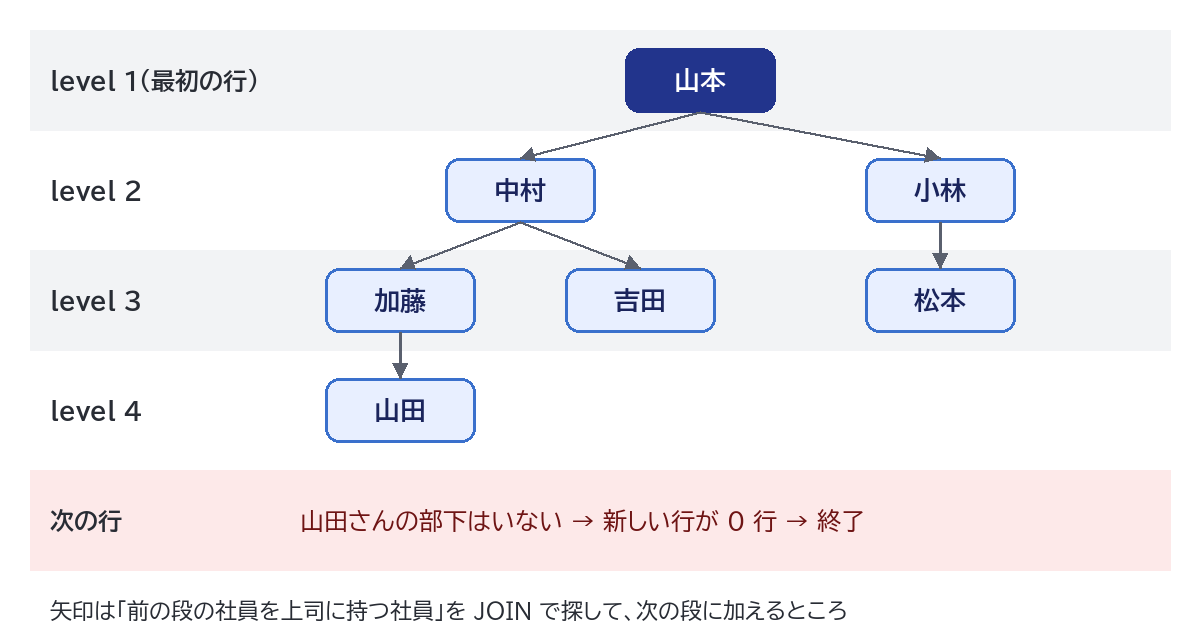
(7 行)社員テーブルのように、同じテーブルの中で「親」を指す列がある構造(組織図・カテゴリの親子・フォルダーなど)は、再帰 CTE でたどれます。社長から順に、階層の深さ(level)と経路(path)を出してみます。
WITH RECURSIVE org(id, name, level, path) AS (SELECT id, name, 1, name FROM employees WHERE manager_id IS NULL UNION ALL SELECT e.id, e.name, org.level + 1, org.path || ' > ' || e.name FROM employees AS e JOIN org ON e.manager_id = org.id) SELECT level, path FROM org ORDER BY path;level | path
1 | 山本
2 | 山本 > 中村
3 | 山本 > 中村 > 加藤
4 | 山本 > 中村 > 加藤 > 山田
3 | 山本 > 中村 > 吉田
2 | 山本 > 小林
3 | 山本 > 小林 > 松本
(7 行)最初の行は上司のいない山本さん(level 1)です。次に「上司が山本さんの社員」(中村・小林)が level 2 として加わり、その部下、さらにその部下……と、部下がいなくなるまで続きます。|| は文字列をつなぐ演算子です(MySQL では既定では OR の意味になるので、CONCAT() 関数を使います)。
開始する社員と JOIN の向きを変えると、「中村さんの配下の全員」や「山田さんの上司を社長までさかのぼる」こともできます。
WITH RECURSIVE bosses(id, name, manager_id) AS (SELECT id, name, manager_id FROM employees WHERE id = 6 UNION ALL SELECT e.id, e.name, e.manager_id FROM employees AS e JOIN bosses AS b ON e.id = b.manager_id) SELECT name FROM bosses;結果は山田・加藤・中村・山本の 4 行です。逆に開始を id = 2、JOIN を e.manager_id = s.id(部下の方向)にすると、中村さんの配下の加藤・吉田・山田が返りました。
| データベース | RECURSIVE の省略 | 止まらない再帰への備え |
|---|---|---|
| SQLite | 省略しても動く(互換のため強制しないと公式に説明) | CTE の中の LIMIT で再帰が止まる |
| PostgreSQL | 必要 | テスト時に外側へ LIMIT を付ける方法が紹介されている(本番では非推奨) |
| MySQL 8.0 | 必要(忘れると「Table ‘cte_name’ doesn’t exist」になりやすい) | cte_max_recursion_depth(既定 1000)を超えると止まる |
SQLite では RECURSIVE を省いても連番が出ましたが、再帰するときは必ず WITH RECURSIVE と書くのが安全です。
終了条件(WHERE n < 5 など)を書き忘れたり、親子関係が輪になっていたり(A の上司が B、B の上司が A)すると、再帰が止まりません。PostgreSQL の公式ドキュメントにも「再帰部分がいずれ 1 行も返さなくなることを確かめないと、無限にループする」とあります。
サブクエリの多くは JOIN でも書けます。ただし、そのまま置き換えると結果が変わることがあります。佐藤さん・鈴木さん(customer_id 1・2)が買った商品を、IN と JOIN で比べます。
SELECT name FROM products WHERE id IN (SELECT product_id FROM orders WHERE customer_id IN (1, 2));IN では、ノートPC A・ノートPC B・マウス・キーボード・USBメモリ 32GB・外付けSSD 1TB の 6 行が返りました。同じことを JOIN で書くと次のようになります。
SELECT p.name FROM products AS p JOIN orders AS o ON o.product_id = p.id WHERE o.customer_id IN (1, 2);name
マウス
ノートPC A
キーボード
USBメモリ 32GB
外付けSSD 1TB
マウス
ノートPC B
(7 行)JOIN では、2 人ともが買ったマウスが 2 回出ています。JOIN は「注文 1 件ごと」に行を作るからです。SELECT DISTINCT p.name にすると 6 行になりました。「含まれるかどうか」だけを知りたいなら IN や EXISTS、注文の数量や日付も一緒に出したいなら JOIN、と使い分けます。
| サブクエリ | JOIN での書き方 | 注意点 |
|---|---|---|
| WHERE id IN (SELECT …) | INNER JOIN + DISTINCT | DISTINCT を忘れると重複する |
| WHERE NOT EXISTS (SELECT …) | LEFT JOIN … WHERE 右の主キー IS NULL | IS NULL を調べる列は NOT NULL の列(主キーなど)にする |
| SELECT の中の (SELECT COUNT(*) …) | LEFT JOIN + GROUP BY + COUNT(右の列) | COUNT(*) にすると 0 件が 1 になる |
「周辺機器より高い商品」のつもりで、比較の右に複数行を返すサブクエリを書いてしまう間違いです。SQLite ではエラーにならずに結果が返りました。
SELECT name, price FROM products WHERE price > (SELECT price FROM products WHERE category = '周辺機器');name | price
ノートPC A | 98000
ノートPC B | 128000
キーボード | 6480
外付けSSD 1TB | 12800
モニター 24型 | 21800
(5 行)周辺機器の価格は 4 つあるのに、キーボード(6,480 円)や周辺機器のモニターまで出ています。SQLite の公式ドキュメントには「サブクエリ式の値は、SELECT の結果の最初の行」とあり、ここでは最初の行のマウスの 2,980 円とだけ比べていました。同じ SQL を MySQL で実行すると「ERROR 1242: Subquery returns more than 1 row」、PostgreSQL でも「1 行より多くを返すクエリをスカラーサブクエリに使うとエラー」と公式ドキュメントにあります(MySQL・PostgreSQL の実機では確認していません)。
「どの値と比べたいのか」をはっきりさせ、(SELECT MAX(price) FROM products WHERE category = '周辺機器') のように集計関数で 1 つの値にするか、一覧と比べたいなら IN や EXISTS を使います。
注文されたカテゴリの商品を出すつもりで、orders にない category 列をサブクエリに書いてしまった例です。エラーにならず、注文されていない USBケーブルまで含む全 8 商品が返りました。
SELECT name FROM products WHERE category IN (SELECT category FROM orders);サブクエリの中で見つからない列名は、外側のテーブルの列として扱われます(相関サブクエリと同じ仕組みです)。そのため SELECT category FROM orders は「外側の商品の category を、注文の件数ぶん並べたもの」になり、条件は常に真になりました。サブクエリの中の列には o.product_id のようにテーブルの別名を付けると、列名を間違えたときに「no such column」のエラーで気付けます。
一概には言えません。実行方法はデータベースのオプティマイザー(実行方法を決める仕組み)が決め、サブクエリを結合に書き換えて実行することもあります。遅いと感じたら EXPLAIN(実行計画の表示)で確かめてから書き換えましょう。まずは読みやすさと結果の正しさ(重複・NULL)で選びます。
データベースによって違います。PostgreSQL の公式ドキュメントでは、再帰でなく副作用のない WITH は、1 回だけ参照されるなら外側の SQL に組み込んで最適化され、2 回以上なら別に計算される、と説明されています。AS MATERIALIZED(別に計算する)・AS NOT MATERIALIZED(組み込む)で指定もでき、SQLite でも 3.35.0 以降で使えます。ふだんは指定しなくて構いません。