SQLのインデックスとは?仕組みとEXPLAINでの確認方法を50万行の実測で解説
hr
ENG LIFE BLOG
データベースにデータを入れる前に、まず入れ物になるテーブルを作ります。そのための命令が CREATE TABLE です。この記事では、練習用の社員テーブルを実際に作りながら、列のデータ型と、入れてよい値のルールである制約(PRIMARY KEY・NOT NULL・UNIQUE・DEFAULT・CHECK・FOREIGN KEY)を解説します。
SQLite では INTEGER の列に文字列が入ってしまうこと、外部キーは設定しないと効かないことも実演します。結果とエラー文は、すべて Python 3.12・SQLite 3.45.3 で実際に実行したものです。
CREATE TABLE は、テーブルの名前と、どんな列(項目)を持つかを決める命令です。基本の形は次のとおりで、かっこの中に「列名・データ型・制約」をカンマ区切りで並べます。
CREATE TABLE テーブル名 (
  列名1 データ型 制約,
  列名2 データ型 制約,
  ...
);データ型はその列に入れる値の種類(整数・文字列など)、制約は入れてよい値のルール(空欄は禁止、重複は禁止など)です。制約に違反する INSERT・UPDATE はエラーになり、データは書き込まれません。
CREATE TABLE・ALTER TABLE・DROP TABLE のようにテーブルの形を決める命令は DDL(データ定義言語)と呼ばれます。
Python に標準で入っている SQLite(エスキューライト)を使います。次のコードを sql_table_practice.py という名前で保存してください。CREATE TABLE は複数行で書くことが多いので、「;」で終わるまで何行でも入力できるようにしています。データベースはメモリー上に作られ、終了すると消えるので、何度でもやり直せます。
import sqlite3

con = sqlite3.connect(":memory:", isolation_level=None)

print("SQL を入力して Enter(; で終わるまで複数行で入力できます。終了は exit)")
buf = ""
while True:
    line = input("sql> " if not buf else "...> ")
    if not buf and line.strip().lower() in ("exit", "quit"):
        break
    buf += line + "\n"
    if not sqlite3.complete_statement(buf):
        continue
    sql, buf = buf, ""
    try:
        cur = con.execute(sql)
    except sqlite3.Error as e:
        print("エラー:", e)
        continue
    if cur.description is None:
        print("OK")
        continue
    print(" | ".join(d[0] for d in cur.description))
    rows = cur.fetchall()
    for row in rows:
        print(" | ".join("NULL" if v is None else str(v) for v in row))
    print(f"({len(rows)} 行)")
保存したフォルダーで次のコマンドを実行すると「sql>」と表示されます。この記事の SQL を入力して Enter を押してください(「;」がまだなら「…>」と表示されて続きを待ちます)。
py sql_table_practice.py結果の表がない命令が成功すると「OK」、失敗すると「エラー:」の後ろに SQLite のエラー文が表示されます。
部署(departments)と社員(employees)の 2 つのテーブルを作ります。制約の意味は後で 1 つずつ説明するので、まずはこのまま入力してください。
CREATE TABLE departments (
  id   INTEGER PRIMARY KEY,
  name TEXT    NOT NULL UNIQUE
);
CREATE TABLE employees (
id INTEGER PRIMARY KEY,
email TEXT NOT NULL UNIQUE,
name TEXT NOT NULL,
age INTEGER CHECK (age >= 18),
status TEXT NOT NULL DEFAULT '在籍',
dept_id INTEGER REFERENCES departments (id)
);どちらも「OK」と表示されれば成功です。続けて部署を 2 件、社員を 2 件追加して中身を確認します。
INSERT INTO departments (id, name) VALUES (1, '開発部'), (2, '営業部');
INSERT INTO employees (email, name, age, dept_id) VALUES ('sato@example.com', '佐藤', 28, 1);
INSERT INTO employees (email, name, age, dept_id) VALUES ('suzuki@example.com', '鈴木', 35, 2);
SELECT * FROM employees;
id | email | name | age | status | dept_id
1 | sato@example.com | 佐藤 | 28 | 在籍 | 1
2 | suzuki@example.com | 鈴木 | 35 | 在籍 | 2
(2 行)INSERT で id と status を指定していないのに、id には 1・2 が、status には「在籍」が入っています。id は INTEGER PRIMARY KEY の自動採番、status は DEFAULT '在籍' の働きです。
SQLite では PRAGMA table_info(employees); で列の一覧(列名・型・NOT NULL の有無・DEFAULT の値・主キーかどうか)を、SELECT sql FROM sqlite_schema WHERE name = 'employees'; で CREATE TABLE の文そのものを確認できます。
SQLite は、ほかの多くのデータベースと型の考え方が違います。公式ドキュメント(Datatypes In SQLite)によると、SQLite では型は列ではなく値そのものに付き、列の型は「なるべくこの型にそろえる」という希望(型アフィニティ)にすぎません。保存される値の型は NULL・INTEGER・REAL・TEXT・BLOB の 5 つで、CREATE TABLE に書いた型名は次のルールで振り分けられます(上から順に判定)。
| 型名に含まれる文字 | アフィニティ | 型名の例 |
|---|---|---|
| INT | INTEGER | INT、INTEGER、BIGINT、TINYINT |
| CHAR、CLOB、TEXT | TEXT | TEXT、VARCHAR(255)、NCHAR(55) |
| BLOB、または型名なし | BLOB | BLOB、(型を書かない列) |
| REAL、FLOA、DOUB | REAL | REAL、DOUBLE、FLOAT |
| 上のどれでもない | NUMERIC | NUMERIC、DECIMAL(10,5)、BOOLEAN、DATE、DATETIME |
SQLite には独立した日付型や真偽値型はなく、DATE や BOOLEAN と書いても NUMERIC アフィニティです。公式ドキュメントでは、真偽値は 0 と 1、日付は「YYYY-MM-DD HH:MM:SS.SSS」の形の TEXT などで保存する方法が紹介されています。
実際に試してみます。数量(qty)を INTEGER、コード(code)を VARCHAR(5)、価格(price)を REAL にし、memo は型を書かずに作ります。typeof() は、値が実際にどの型で保存されたかを返す関数です。
CREATE TABLE items (
  qty   INTEGER,
  code  VARCHAR(5),
  price REAL,
  memo
);
INSERT INTO items VALUES ('100', 'ABCDEFGHIJ', '980', '007');
INSERT INTO items VALUES ('たくさん', 12345, 'free', 3.5);
INSERT INTO items VALUES ('12.0', '00123', 1, NULL);
SELECT qty, typeof(qty), code, typeof(code), price, typeof(price), memo, typeof(memo) FROM items;
qty | typeof(qty) | code | typeof(code) | price | typeof(price) | memo | typeof(memo)
100 | integer | ABCDEFGHIJ | text | 980.0 | real | 007 | text
たくさん | text | 12345 | text | free | text | 3.5 | real
12 | integer | 00123 | text | 1.0 | real | NULL | null
(3 行)3 つの INSERT はすべて成功しました。数値に変換できる文字列は変換され(’100′ は整数の 100、’12.0′ は 12)、変換できない文字列はそのまま入ります(INTEGER の qty に「たくさん」、REAL の price に「free」)。さらに VARCHAR(5) の長さは無視され、10 文字がそのまま入りました。公式ドキュメントにも「かっこ内の数字は無視される」とあります。
文字列が混ざると、検索や集計の結果がおかしくなります。数量が 50 より大きい商品を探すと、「たくさん」の行まで出てきます。SQLite では、比べたときに文字列は常に数値より大きいと扱われるためです。
SELECT * FROM items WHERE qty > 50;qty | code | price | memo
100 | ABCDEFGHIJ | 980.0 | 007
たくさん | 12345 | free | 3.5
(2 行)SELECT sum(qty) FROM items; もエラーにならず 112.0 を返しました(「たくさん」は 0 扱い)。間違ったデータが静かに混ざる、いちばん怖いパターンです。
SQLite 3.37.0(2021 年 11 月)からは、CREATE TABLE の最後に STRICT を付けると、型の違う値をエラーにできます。Python に入っている SQLite のバージョンは、次のコマンドで確認できます(筆者の環境では 3.45.3 でした)。
py -c "import sqlite3; print(sqlite3.sqlite_version)"CREATE TABLE items_strict (
qty INTEGER,
code TEXT,
price REAL,
memo ANY
) STRICT;
INSERT INTO items_strict VALUES ('100', 'ABCDEFGHIJ', '980', '007');
INSERT INTO items_strict VALUES ('たくさん', 'X', 1, NULL);
INSERT INTO items_strict VALUES (1.5, 'X', 1, NULL);
INSERT INTO items_strict VALUES (3, 12345, 'free', NULL);OK
OK
エラー: cannot store TEXT value in INTEGER column items_strict.qty
エラー: cannot store REAL value in INTEGER column items_strict.qty
エラー: cannot store TEXT value in REAL column items_strict.price‘100’ のように値を失わずに変換できるものは変換して保存され、「たくさん」や 1.5 のように値が変わってしまうものはエラーになりました(整数を TEXT 列に入れると、文字列に変換されて保存されます)。
STRICT テーブルで使える型名は INT・INTEGER・REAL・TEXT・BLOB・ANY の 6 つだけです(ANY は受け取った値をそのまま保存する型)。CREATE TABLE t_date (d DATE) STRICT; は unknown datatype for t_date.d: "DATE" というエラーになったので、日付は TEXT 列に「2026-10-23」の形で入れます。
よく使う型を、公式ドキュメント(MySQL 8.4 リファレンスマニュアル、PostgreSQL 18 ドキュメント)で確認した範囲でまとめます。MySQL・PostgreSQL の部分は、筆者は実行して確かめていません。
| 入れるもの | MySQL | PostgreSQL | SQLite(STRICT) |
|---|---|---|---|
| 整数 | INT(-2147483648〜2147483647)、BIGINT | integer(4 バイト)、bigint(8 バイト) | INTEGER |
| 金額など誤差を出したくない小数 | DECIMAL(M, D) | numeric(p, s)(別名 decimal) | 専用の型はない(整数で円単位にするなど) |
| 浮動小数点数 | DOUBLE | double precision | REAL |
| 文字列(長さの上限あり) | VARCHAR(n) | varchar(n) | TEXT(長さの上限なし) |
| 長い文字列 | TEXT | text | TEXT |
| 真偽値 | BOOLEAN(TINYINT(1) の別名) | boolean | INTEGER の 0・1 |
| 日付・日時 | DATE、DATETIME、TIMESTAMP | date、timestamp、timestamptz(タイムゾーン付き) | TEXT(’2026-10-23′ など) |
VARCHAR(n) の長さを超えたときは、PostgreSQL ではエラー、MySQL では strict SQL モードならエラー(そうでなければ切り詰めて警告)と公式ドキュメントに書かれています。
制約を付けておくと、間違ったデータをデータベース側ではじけます。プログラムで確認を忘れても、データが壊れません。主な制約は次の 6 つです。
| 制約 | 意味 | employees での例 |
|---|---|---|
| PRIMARY KEY | 行を 1 つに特定する列(主キー)。重複できない | id INTEGER PRIMARY KEY |
| NOT NULL | NULL(値なし)を禁止する | name TEXT NOT NULL |
| UNIQUE | 同じ値の重複を禁止する | email TEXT NOT NULL UNIQUE |
| DEFAULT | 値を指定しなかったときに入る値 | status TEXT NOT NULL DEFAULT '在籍' |
| CHECK | 条件を満たす値だけを許す | age INTEGER CHECK (age >= 18) |
| FOREIGN KEY | ほかのテーブルにある値だけを許す(外部キー) | dept_id INTEGER REFERENCES departments (id) |
1 つの列に複数の制約を並べて書けます(email は NOT NULL と UNIQUE の 2 つ)。
練習用のテーブルで 1 つずつ違反させたときに、実際に出たエラー文です。どれも行は追加されませんでした。
| 制約 | 実行した SQL | エラー文 |
|---|---|---|
| PRIMARY KEY | INSERT INTO employees (id, email, name, age, dept_id) VALUES (1, 'kato@example.com', '加藤', 30, 1); | UNIQUE constraint failed: employees.id |
| NOT NULL | INSERT INTO employees (email, age, dept_id) VALUES ('tanaka@example.com', 30, 1); | NOT NULL constraint failed: employees.name |
| UNIQUE | INSERT INTO employees (email, name, age, dept_id) VALUES ('sato@example.com', '佐藤 一郎', 41, 2); | UNIQUE constraint failed: employees.email |
| CHECK | INSERT INTO employees (email, name, age, dept_id) VALUES ('ito@example.com', '伊藤', 16, 1); | CHECK constraint failed: age >= 18 |
| NOT NULL(DEFAULT のある列に NULL を指定) | INSERT INTO employees (email, name, age, status, dept_id) VALUES ('ueda@example.com', '上田', 26, NULL, 1); | NOT NULL constraint failed: employees.status |
エラー文の「テーブル名.列名」を見れば、どの列が原因か分かります。
主キーは、社員番号のように行を 1 つに決められる列です。SQLite では、型名がちょうど INTEGER の主キーは、値を指定しないと自動で番号が振られます(公式ドキュメントでは「ふつうは今ある最大の値より 1 大きい数」)。削除した番号の再利用を防ぐ AUTOINCREMENT は、公式ドキュメントで「必要なければ避けるべき」とされています。
表の最後の例のように、NULL を明示的に書くと DEFAULT は使われません。status は NOT NULL なのでエラーになりました。作成日時を自動で入れたいときは created_at TEXT NOT NULL DEFAULT CURRENT_TIMESTAMP と書きます。公式ドキュメントのとおり入るのはUTC(協定世界時)で、日本時間の 10 月 23 日 0 時 43 分に試すと「2026-10-22 15:43:14」と、9 時間前の時刻が入りました。
SQLite の公式ドキュメントでは、UNIQUE 制約では NULL どうしは別の値として扱われる(NULL は何行でも入る)と説明されています。CHECK も「式が NULL になるときは違反ではない」とされていて、実際に次の INSERT は成功しました。
INSERT INTO employees (email, name, age, dept_id) VALUES ('ito@example.com', '伊藤', NULL, 1);値を必ず入れさせたいなら、age INTEGER NOT NULL CHECK (age >= 18) のように NOT NULL も付けます(NULL については「SQLのNULLの扱い方」を参照)。また、CONSTRAINT age_adult CHECK (age >= 18) のように制約に名前を付けると、エラー文が CHECK constraint failed: age_adult と名前で表示されます。
employees の dept_id に書いた REFERENCES departments (id) が外部キーで、「dept_id には departments の id にある値しか入れられない」というルールです。参照される departments を親テーブル、REFERENCES を書いた employees を子テーブルと呼びます。親の列は主キーか UNIQUE の列である必要があります。
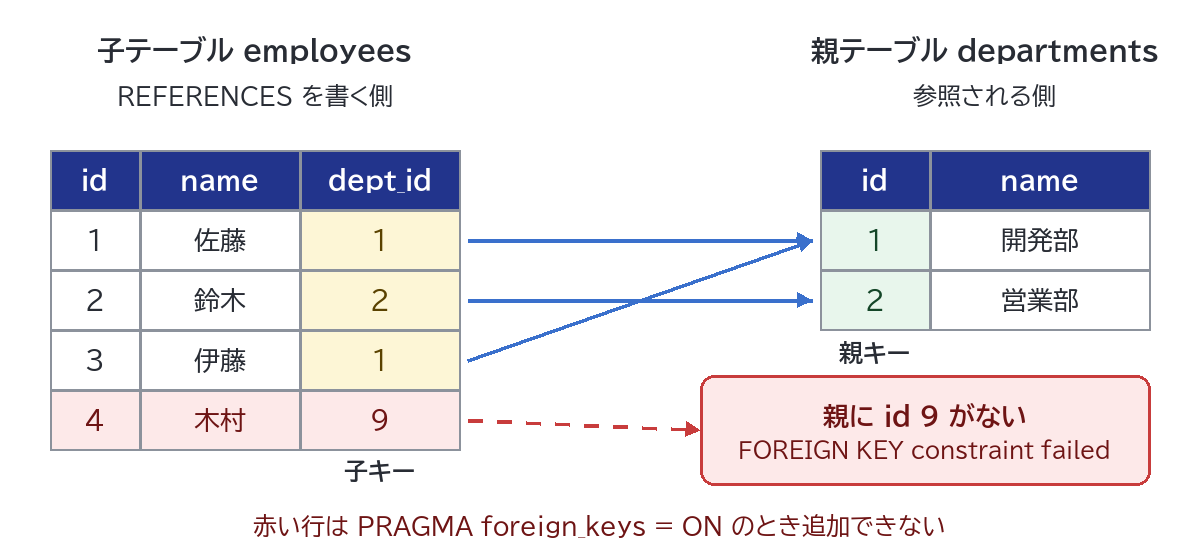
ここが SQLite の大きな落とし穴です。存在しない部署 9 を指定して追加してみます。
INSERT INTO employees (email, name, age, dept_id) VALUES ('kimura@example.com', '木村', 24, 9);
SELECT * FROM employees;
SELECT の結果の 4 行目に「4 | kimura@example.com | 木村 | 24 | 在籍 | 9」が表示されました。
エラーにならず、存在しない部署の社員ができてしまいました。SQLite の公式ドキュメントによると、外部キーの制約は互換性のために初期状態では無効で、接続ごとに PRAGMA foreign_keys = ON; を実行して有効にする必要があります。今の状態は PRAGMA foreign_keys; で確認でき、練習用のスクリプトでは 0(無効)でした。
木村さんの行を消してから、外部キーを有効にしてもう一度試します。
DELETE FROM employees WHERE id = 4;
PRAGMA foreign_keys = ON;
INSERT INTO employees (email, name, age, dept_id) VALUES ('kimura@example.com', '木村', 24, 9);
OK
OK
エラー: FOREIGN KEY constraint failed今度はエラーになりました。外部キーのエラー文には列名が出ないので、外部キーが複数あるときは INSERT した値を見比べて原因を探します。なお、dept_id を NULL にした追加(部署が未定の社員)は成功します。
外部キーが有効だと、子から参照されている親の行は削除できません。DELETE FROM departments WHERE id = 1; も、子の値を存在しない部署に変える UPDATE employees SET dept_id = 5 WHERE id = 1; も、FOREIGN KEY constraint failed になりました。
親を削除したときに子をどうするかは、REFERENCES の後ろの ON DELETE で変えられます。公式ドキュメントにある動きは次のとおりです(何も書かないと NO ACTION)。
| 書き方 | 親の行を削除したときの動き |
|---|---|
| NO ACTION(既定) | 特別なことはしない。子が残っていればエラーになる(上の例) |
| RESTRICT | 子がある親の削除を禁止する |
| CASCADE | 子の行もいっしょに削除する |
| SET NULL | 子の外部キーの列を NULL にする |
| SET DEFAULT | 子の外部キーの列を DEFAULT の値にする |
dept_id INTEGER REFERENCES departments (id) ON DELETE CASCADE にして(外部キーは有効)開発部を削除すると、佐藤さんと伊藤さんの行もいっしょに消え、鈴木さんだけが残りました。ON DELETE SET NULL では、子の dept_id が NULL に変わりました。CASCADE は親を 1 行消しただけで子が大量に消えることがあるので、注文履歴のように残すべきデータには使わないのが安全です。
同じ名前のテーブルをもう一度作ろうとすると、CREATE TABLE employees (id INTEGER PRIMARY KEY); は table employees already exists のエラーになります。CREATE TABLE IF NOT EXISTS employees (id INTEGER PRIMARY KEY); のように IF NOT EXISTS を付けると、テーブルがすでにあれば何もせず、エラーも出ません(結果は「OK」)。
ただし、employees が作り直されるわけではなく、既存のテーブルの列は CREATE TABLE の内容と違っていてもそのままです。「テーブルがなければ作る」処理には向いていますが、列を変えたいときは次の ALTER TABLE を使います。
作ったテーブルに列を足すときは ALTER TABLE テーブル名 ADD COLUMN 列の定義; を使います。既存の行には、新しい列の DEFAULT(なければ NULL)が入ります。
ALTER TABLE employees ADD COLUMN phone TEXT;
ALTER TABLE employees ADD COLUMN level INTEGER NOT NULL;
ALTER TABLE employees ADD COLUMN level INTEGER NOT NULL DEFAULT 1;
ALTER TABLE employees ADD COLUMN code TEXT UNIQUE;
OK
エラー: Cannot add a NOT NULL column with default value NULL
OK
エラー: Cannot add a UNIQUE column既存の行に入れる値がないので、NOT NULL の列は DEFAULT がないと追加できません。公式ドキュメントには、ほかにも「PRIMARY KEY・UNIQUE の列は追加できない」「DEFAULT に CURRENT_TIMESTAMP は使えない」などの制限が書かれています。
テーブルを丸ごと削除するのは DROP TABLE テーブル名; です。中のデータもすべて消え、元に戻せません。必ず練習用のデータベースで試し、本番ではバックアップを取ってからテーブル名をよく確認して実行してください。ないテーブルを DROP すると no such table: memo のエラーになり、DROP TABLE IF EXISTS memo; ならエラーになりません。また外部キーが有効な状態で、社員から参照されている DROP TABLE departments; は FOREIGN KEY constraint failed で失敗しました。
列の間のカンマを忘れても、SQLite ではエラーにならないことがあります。
CREATE TABLE e (id INTEGER name TEXT);
PRAGMA table_info(e);
cid | name | type | notnull | dflt_value | pk
0 | id | INTEGER name TEXT | 0 | NULL | 0
(1 行)「INTEGER name TEXT」全体が id 列の型名として扱われ、name 列は作られていません。テーブルを作ったら PRAGMA table_info で列を確認しましょう。最後の列の後ろに余分なカンマを付けた CREATE TABLE d (id INTEGER, name TEXT,); は near ")": syntax error になります。長い CREATE TABLE は、SQL 整形ツールで改行とインデントをそろえると、カンマの抜けを見つけやすくなります。
自動採番されるのは、型名がちょうど INTEGER のときだけです(公式ドキュメントでも、INT や BIGINT では「ふつうの列+一意のインデックス」として動くと説明)。CREATE TABLE a (id INT PRIMARY KEY, name TEXT); に name だけを 2 回 INSERT すると、SELECT rowid, id, name FROM a; の結果は「1 | NULL | x」「2 | NULL | y」で、id は NULL のままでした(理由は次の項目)。
標準 SQL では主キーは NULL を許しません。しかし SQLite の公式ドキュメントによると、古いバージョンの不具合との互換性のため、INTEGER PRIMARY KEY・STRICT テーブル・WITHOUT ROWID テーブル・NOT NULL 付きの列以外では、主キーに NULL が入ります。CREATE TABLE b (code TEXT PRIMARY KEY, name TEXT); に INSERT INTO b VALUES (NULL, 'x'); と (NULL, 'y') を続けて実行すると、どちらも成功し、主キーが NULL の行が 2 つできました。
SQLite で INTEGER 以外の主キーを使うときは、code TEXT NOT NULL PRIMARY KEY のように NOT NULL も書いておきます。
Python の sqlite3 でも、接続を開くたびに PRAGMA foreign_keys = ON を実行します(新しい接続では 0 に戻っていました)。また公式ドキュメントによると、トランザクションの途中では設定を変えられず、エラーも出ずに無視されます。実際に con.execute("BEGIN") の後に実行すると 0 のままで、commit の後に実行し直すと 1 になりました。
接続を開いた直後、ほかの SQL より先に実行すると覚えておきましょう。Python からの操作の基本は「Pythonのsqlite3入門」で解説しています。
基本的には付けます。主キーがないと、同じ内容の行が 2 つあるときに片方だけを UPDATE・DELETE しにくくなります。迷ったら id INTEGER PRIMARY KEY を用意し、メールアドレスのように重複してはいけない列には別に UNIQUE を付けます。主キーでの検索の速さは「SQLのインデックスとは?」で解説しています。