head・tail・wcコマンドの使い方|先頭・末尾の表示とtail -f、行数の数え方
hr
ENG LIFE BLOG
「ログに出てくる IP アドレスを、アクセスの多い順に並べたい」「リストから重複を消したい」「CSV を点数の高い順に並べたい」。こうした作業で毎日のように使われるのが sort(ソート)と uniq(ユニーク)の 2 つのコマンドです。sort は行を並べ替え、uniq は重複した行をまとめたり数えたりします。
この記事では、sort の基本と -r・-n・-h・-t・-k・-u、uniq の -c・-d・-u と「隣り合った重複しか消さない」という大事な性質、定番の sort | uniq -c | sort -rn でのログ集計を、実行結果つきで解説します。実行結果は Windows の Git Bash で確かめたものです(sort --version の表示は「sort (GNU coreutils) 8.32」。uniq も同じ 8.32 です)。| (パイプ)や > (リダイレクト)の意味は「標準出力・標準エラーとリダイレクト」で解説しています。
| コマンド | すること | よく使う場面 |
|---|---|---|
| sort | 行を並べ替える(文字の順・数値の順・列を指定して) | 名前順・点数順・サイズ順に並べる、重複を除く(-u) |
| uniq | 隣り合った同じ行を 1 行にまとめる。件数も数えられる(-c) | sort の後に置いて、種類ごとの件数を数える |
どちらも元のファイルは書き換えず、結果を画面に出すだけです。GNU coreutils(Linux や Git Bash に入っている基本コマンドのセット)のコマンドで、Linux でも同じ書き方で使えます。
この記事では次の 3 つのファイルを使います。fruits.txt(果物の名前が 6 行)、nums.txt(数字が 5 行)、scores.csv(名前・部署・点数の CSV)です。
fruits.txt   nums.txt   scores.csv
apple        10         name,dept,score
apple        9          tanaka,dev,82
banana       100        suzuki,sales,65
apple        2          sato,dev,91
cherry       25         ito,sales,74
banana                  kato,hr,58
後半では、awk の記事と同じアクセスログ風のファイル access.log(8 行。1 列目が IP アドレス、9 列目がステータスコード)も使います。中身は「awkコマンドの使い方」の「基本の形と練習用ファイル」にあります(練習用に作ったもので、実在のログではありません)。
ファイル名を付けて実行すると、行を文字の順(辞書の順)に並べて表示します。
sort fruits.txtapple
apple
apple
banana
banana
cherry-r(reverse)を付けると逆順になります。sort -r fruits.txt の結果は cherry、banana、banana、apple、apple、apple でした。ファイル名を書かずに cat fruits.txt | sort のようにパイプで渡しても同じ結果になります。
sort は何も指定しないと、数字も文字として 1 文字目から比べます。nums.txt をそのまま並べてみます。
sort nums.txt10
100
2
25
9「10」と「100」は 1 文字目が「1」なので先に来て、「9」は 1 文字目が一番大きいので最後になりました。辞書で「あ」で始まる言葉が先に来るのと同じ考え方です。数の大きさで並べるには -n(numeric)を付けます。
sort -n nums.txt2
9
10
25
100大きい順にするなら -r と組み合わせて sort -nr nums.txt(100、25、10、9、2 の順)です。オプションは -n -r と分けても、-nr とまとめても同じです。
du -h などが出す「1.5G」「12M」「200K」のような単位付きの数は、-n では単位を無視して数字部分だけで比べてしまいます。1.5G・200K・12M・3K・800M の 5 行のファイル sizes.txt で比べました。
| コマンド | 結果(上から順に) |
|---|---|
| sort -n sizes.txt | 1.5G、3K、12M、200K、800M(数字の部分だけで比べている) |
| sort -h sizes.txt | 3K、200K、12M、800M、1.5G(単位まで見て比べる) |
| sort -hr sizes.txt | 1.5G、800M、12M、200K、3K(大きい順) |
GNU coreutils のマニュアルによると、-h はまず単位(なし・K・M・G・T…の順)で比べ、同じ単位どうしを数値で比べます。そのため「1023M」は「1G」より前に来ます。du や ls の -h の出力のように、単位がそろえて付けられた値を並べるためのオプションです。
なお、-n は「1e3」のような指数表記を数として読みません(マニュアルにも明記されています)。printf '1e3\n-5\n3.14\n20\n' | sort -n は -5、1e3、3.14、20 の順になり、-g(general numeric)に変えると -5、3.14、20、1e3 の順になりました。
CSV のように区切られたデータは、-t で区切り文字、-k で並べる基準の列を指定します。-k は「-k 開始の列,終わりの列」の形で、1 つの列だけで比べるときは -k3,3 のように同じ番号を 2 回書きます。列の番号の後ろに n や r を付けると、その列だけに数値・逆順が効きます。scores.csv を点数(3 列目)の高い順に並べます。
sort -t, -k3,3nr scores.csvsato,dev,91
tanaka,dev,82
ito,sales,74
suzuki,sales,65
kato,hr,58
name,dept,score点数順に並びましたが、見出しの「name,dept,score」が一番下に来てしまいました。-n では数字で始まらない値は 0 として扱われるため、大きい順では最後、小さい順(sort -t, -k3,3n scores.csv)では先頭になります。見出しを先頭に残したまま並べるには、1 行目だけ先に出し、2 行目以降を並べます。
(head -n 1 scores.csv; tail -n +2 scores.csv | sort -t, -k3,3nr)結果は「name,dept,score」の下に sato,dev,91、tanaka,dev,82…と並びました。tail -n +2 は「2 行目から最後まで」という意味です。
-k は何個でも並べて書けます。「部署(2 列目)の文字順、同じ部署の中では点数の高い順」にするには次のようにします。
sort -t, -k2,2 -k3,3nr scores.csvname,dept,score
sato,dev,91
tanaka,dev,82
kato,hr,58
ito,sales,74
suzuki,sales,65今度は見出しが先頭に来ました。2 列目の「dept」が dev・hr・sales より文字の順で前だからで、たまたまです。
-k2 のように終わりの列を書かないと、「2 列目から行の最後まで」が比べる対象になります(マニュアルの -k の説明どおり)。また、指定した列がすべて同じ行どうしは、最後に行全体で比べ直して順番を決めます(マニュアルでは last-resort comparison と呼んでいます)。同じ dev の tanaka と sato で違いが出ました。
| コマンド | dev の 2 行の順番 | 理由 |
|---|---|---|
| sort -t, -k2 scores.csv | tanaka,dev,82 → sato,dev,91 | 「dev,82」と「dev,91」を比べた |
| sort -t, -k2,2 scores.csv | sato,dev,91 → tanaka,dev,82 | 「dev」が同じなので行全体で比べ直した(s が t より前) |
| sort -t, -k2,2 -s scores.csv | tanaka,dev,82 → sato,dev,91 | -s(stable)は比べ直しをせず、元の順番のまま |
「指定した列で並べ、同じ値なら元の順番のまま」にしたいときは -s を付けます。どの部分で比べているか分からなくなったら、--debug を付けると比べている部分に下線を引いて表示してくれます。
-u(unique)を付けると、並べ替えたうえで同じ行を 1 行にまとめます。
sort -u fruits.txt結果は apple、banana、cherry の 3 行でした。種類の数だけ知りたいなら sort -u fruits.txt | wc -l(結果は 3)のように行数を数えます。
ただし -u は「並べる基準で同じ」行を 1 つにします。-k や -n と組み合わせると、行全体が違っても消えることがあります。sort -t, -k2,2 -u で部署ごとに 1 行だけ残る(tanaka,dev,82 と sato,dev,91 のどちらかが消える)、sort -n -u で「1」「01」「1.0」が同じ数として 1 行になる、という具合です。実際に 1・01・1.0・2 の 4 行で試すと、sort -n -u は 1 と 2 の 2 行だけを表示しました。マニュアルにも「sort -u と sort | uniq は同じだが、ほかのオプションを付けた場合は同じとは限らない」と書かれています。
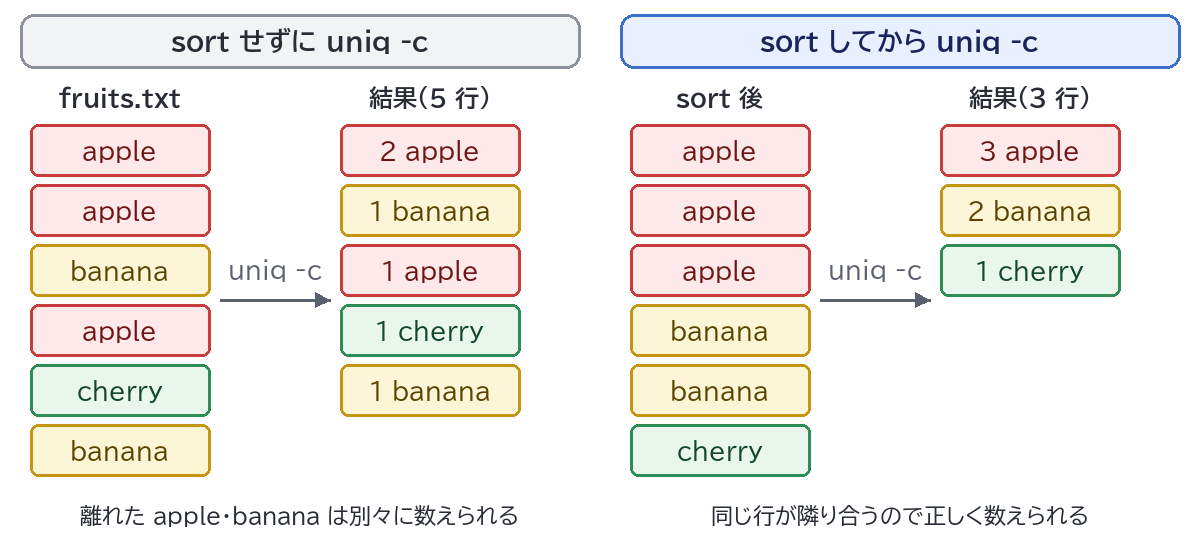
uniq でいちばん大事なのがこの点です。uniq はすぐ上の行と同じなら消すだけで、離れた場所にある同じ行には気づきません。fruits.txt に直接 uniq を使ってみます。
uniq fruits.txtapple
banana
apple
cherry
banana1・2 行目の apple は 1 つになりましたが、4 行目の apple と 6 行目の banana は残りました。GNU coreutils のマニュアルにも「入力は並べ替えてある必要はないが、重複は隣り合っている場合だけ見つかる」と書かれています。そのため uniq は、先に sort で同じ行を隣に集めてから使うのが基本です。件数を数える -c で比べると、違いがはっきりします。
sort fruits.txt | uniq -c 3 apple
2 banana
1 cherrysort せずに uniq -c fruits.txt とすると、図 1 の左のように「2 apple」「1 banana」「1 apple」…と同じ果物が何度も出てきてしまいます。
どれも sort した fruits.txt(sort fruits.txt | uniq -オプション)で試した結果です。
| オプション | 意味 | 結果 |
|---|---|---|
| (なし) | 同じ行を 1 行にまとめる | apple、banana、cherry |
| -c | 行の前に件数を付ける(count) | 3 apple、2 banana、1 cherry |
| -d | 2 回以上出てきた行だけを 1 行ずつ表示(duplicated) | apple、banana |
| -u | 1 回しか出てこない行だけを表示(unique) | cherry |
| -D | 2 回以上出てきた行を、重複分もすべて表示 | apple×3、banana×2 の 5 行 |
| -i | 大文字と小文字を区別しない | Apple と apple を同じ行として扱う |
uniq の -u(1 回だけの行)と sort の -u(重複を除く)は、同じ文字でも意味がまったく違うので注意してください。-d と -u は「2 つのリストの両方にある行・片方にしかない行」を探すのにも使えます。a・b・c の l1.txt と b・c・d の l2.txt で cat l1.txt l2.txt | sort | uniq -d は b と c、uniq -u にすると a と d を表示しました(それぞれのファイルの中に重複がないことが前提です)。
「何が何回出てきたか」を多い順に並べる、ログ調査の定番の組み合わせです。access.log から 1 列目(IP アドレス)を取り出し、アクセスの多い順に並べます。
awk '{print $1}' access.log | sort | uniq -c | sort -rn 3 192.168.0.10
2 192.168.0.12
2 192.168.0.11
1 192.168.0.134 つのコマンドがそれぞれ次の仕事をしています。
awk '{print $1}':各行の 1 列目(IP アドレス)だけを取り出す(cut -d' ' -f1 でも同じ結果でした)sort:同じ IP を隣に集めるuniq -c:IP ごとの件数を行の前に付けるsort -rn:先頭の件数を数値として大きい順に並べる(uniq -c が付ける行頭の空白は、-n が無視してくれます)ログが長いときは最後に | head -n 3 を付けると、上位 3 件だけを表示できます。列を 9 列目に変えて awk '{print $9}' access.log | sort | uniq -c | sort -rn とすると、「4 200」「2 404」「1 500」「1 302」とステータスコードごとの件数になりました。
上の結果では、同じ 2 件の .12 が .11 より先に来ています。-r は最後の「行全体での比べ直し」まで逆順にするためです。件数は大きい順、同じ件数なら IP の文字順にしたいときは、列ごとに指定します。
awk '{print $1}' access.log | sort | uniq -c | sort -k1,1nr -k2,2結果は 3 192.168.0.10、2 192.168.0.11、2 192.168.0.12、1 192.168.0.13 の順になりました。
tr で空白を改行に変えて「1 行 1 単語」にすれば、単語の出現回数も数えられます。「the cat sat on the mat」「The dog sat on the log」の 2 行の words.txt で試しました。
tr -s ' ' '\n' < words.txt | tr 'A-Z' 'a-z' | sort | uniq -c | sort -k1,1nr -k2,2 | head -n 3 4 the
2 on
2 sat2 つ目の tr で大文字を小文字にそろえています。これを外すと「The」が別の単語として数えられ、the は 3 件になりました。
IP アドレスを普通に sort すると文字の順なので、10.0.0.10 が 10.0.0.2 より前に来ます。sort -V(バージョン番号の順)か、マニュアルの例にある sort -t. -k1,1n -k2,2n -k3,3n -k4,4n を使うと、10.0.0.2、10.0.0.10、192.168.0.9、192.168.0.10 の順に並びました。
並べ替えた結果で元のファイルを置き換えようとして sort -n n2.txt > n2.txt と書くと、n2.txt は 0 バイト(空)になりました。シェルが sort を動かす前に、> の出力先を空にしてしまうためです。同じファイルに書き戻すときは -o を使います。
sort -n -o n3.txt n3.txtこの形では n3.txt が 2、9、10、25、100 の順に並べ替えられました。マニュアルには「sort は入力をすべて読んでから出力先を開くので、sort -o F F のように同じファイルに書き戻せる」とあります。ただし同じマニュアルに「途中でエラーなどが起きるとデータを失うおそれがあるので、別のファイルに出力するほうが安全」とも書かれています。大事なファイルは、別名で保存して中身を確かめてから置き換えましょう。
sort の文字の順はロケール(言語の設定)で変わります。この PC の Git Bash では echo $LANG が ja_JP.UTF-8 でした。banana・Apple・apple・Banana・_tmp・cherry の 6 行の case.txt で比べた結果です。
| コマンド | 結果(上から順に) |
|---|---|
| sort case.txt | _tmp、apple、Apple、banana、Banana、cherry |
| LC_ALL=C sort case.txt | Apple、Banana、_tmp、apple、banana、cherry |
ja_JP.UTF-8 では大文字・小文字が近くに並びましたが、LC_ALL=C(C ロケール)にすると文字コードの番号の順になり、大文字(A〜Z)→ _ → 小文字(a〜z)の順になりました。日本語も同じで、りんご・アップル・あんず・林檎・イチゴ・いちご の 6 行は、ja_JP.UTF-8 ではアップル、あんず、イチゴ、いちご、りんご、林檎、LC_ALL=C ではあんず、いちご、りんご、アップル、イチゴ、林檎(ひらがな → カタカナ → 漢字。UTF-8 の番号の順)になりました。
サーバーとパソコンで結果が違う、スクリプトの結果が人によって違う、というときは、ロケールが違う可能性があります。GNU coreutils のマニュアルも、並び順が思ったとおりでないときは環境変数 LC_ALL を C にするよう案内しています。スクリプトで順番を固定したいときは LC_ALL=C sort と書いておくと安心です。なお、大文字と小文字を区別せずに並べるだけなら -f を使います。
Windows で作った行(改行が CR+LF)と Linux で作った行(LF だけ)が混ざっていると、見た目は同じ「apple」でも行末に見えない CR があるかないかで別の行になります。CRLF の apple・LF の apple・CRLF の banana の 3 行のファイルを sort crlf.txt | uniq -c に渡すと、「1 apple」が 2 行表示されました。tr -d '\r' < crlf.txt | sort | uniq -c のように先に CR を消すと、「2 apple」「1 banana」と正しく数えられました。改行コードの調べ方は「改行コードCRLFとLFの違いと確認・変換方法」で解説しています。
Windows には同じ名前の sort.exe(C:\Windows\System32\sort.exe)があります。この記事の sort は GNU の sort なので、Git Bash で実行してください。この PC の Git Bash で type -a sort を実行すると /usr/bin/sort が先に、/c/WINDOWS/system32/sort が後に表示され、Git Bash では GNU の sort が使われることを確かめました。
一方、コマンドプロンプトで sort -n nums.txt を実行すると、この PC では「Input file specified two times.」と表示されて止まりました。Windows の sort.exe は /r(逆順)などスラッシュで始まるオプションを使うため、-n をファイル名と受け取ったと考えられます。PowerShell 5.1 では sort は Sort-Object の別名(エイリアス)になっていて、Get-Content nums.txt | sort -n は「A parameter cannot be found that matches parameter name ‘n’.」というエラーになりました。Microsoft のドキュメントによると、sort.exe は大文字と小文字を区別せず、Sort-Object も既定では区別しません。
PowerShell 5.1 で、この記事のファイルを使って確かめた対応です。PowerShell では Get-Content で読んだ行は文字列なので、数値で並べるには { [int]$_ } で数に変換します。
| やりたいこと | Git Bash | PowerShell |
|---|---|---|
| 並べ替え | sort fruits.txt | Get-Content fruits.txt | Sort-Object |
| 数値で大きい順 | sort -nr nums.txt | Get-Content nums.txt | Sort-Object { [int]$_ } -Descending |
| 重複を除く | sort -u fruits.txt | Get-Content fruits.txt | Sort-Object -Unique |
| 件数を数えて多い順 | sort fruits.txt | uniq -c | sort -rn | Get-Content fruits.txt | Group-Object | Sort-Object Count -Descending |
| CSV を点数の高い順 | sort -t, -k3,3nr scores.csv | Import-Csv scores.csv | Sort-Object { [int]$_.score } -Descending |
Group-Object の結果は Count(件数)と Name(値)の列で表示され、3 apple、2 banana、1 cherry の順でした。違いとして、Sort-Object の -Unique は大文字・小文字を区別しない点に注意してください(Microsoft のドキュメントにも明記されています)。case.txt を Sort-Object -Unique に渡すと、Apple と apple、Banana と banana がそれぞれ 1 行にまとまり 4 行になりました。区別したいときは -CaseSensitive を付けます(6 行のままでした)。PowerShell のほかのコマンドは「PowerShellの基本コマンド一覧」で紹介しています。
重複を除くだけなら、どちらも同じ結果です(オプションを付けない場合)。件数を数える(-c)、重複しているものだけ見る(-d)など uniq のオプションが必要なら sort | uniq を使います。
sort すると順番が変わってしまいます。最初に出てきた順を保ったまま重複を除くなら、awk の awk '!seen[$0]++' fruits.txt が使えます。結果は apple、banana、cherry と、最初に出てきた順でした。仕組みは「awkコマンドの使い方」の連想配列の節で解説しています。
行の順番が違うだけのリストを diff で比べると、差分がたくさん出てしまいます。tanaka・suzuki・sato の members_old.txt と sato・ito・tanaka の members_new.txt を、Git Bash で diff <(sort members_old.txt) <(sort members_new.txt) と両方を並べ替えてから比べると、「ito が増えた」「suzuki が減った」の 2 か所だけが表示されました。結果を色分けして見たいときは、それぞれを sort した結果を「テキスト差分比較ツール」の左右に貼ると、増えた行・減った行が一目で分かります。
sort -c を使います。並んでいなければ最初の乱れた行を表示します。sort -c nums.txt は「sort: nums.txt:3: disorder: 100」と表示し、終了ステータスは 1 でした。並んでいれば何も表示せず、終了ステータスは 0 です。終了ステータスの使い方は「シェルスクリプト入門」で解説しています。