ビット演算の基本と実用例|AND・OR・XOR・シフトとフラグ・マスクの使い方
hr
ENG LIFE BLOG
ログから日付だけを探したい、入力された郵便番号の形をチェックしたい、たくさんの行をまとめて置換したい。こうした場面で使うのが正規表現です。「^[0-9]{3}-[0-9]{4}$」のような記号の並びは最初は暗号のように見えますが、記号の数はそれほど多くありません。
この記事では、特定の言語に偏らずに、記号の意味と考え方、郵便番号・電話番号・メールアドレス・日付・IPv4 アドレス・全角カタカナなどのよく使うパターン集、そして JavaScript・Python・grep での書き方の違いを解説します。パターンはすべて、JavaScript(Microsoft Edge)、Python 3.12 の re モジュール、Git Bash の grep -E(GNU grep 3.0)の 3 つで実際に試し、一致する例・しない例を載せています。
正規表現(Regular Expression、略して regex)は、「数字が 3 けた、ハイフン、数字が 4 けた」のような文字の並び方のルールを記号で書く方法です。決まった文字列ではなく「形」で探せるので、次のような場面で使われます。
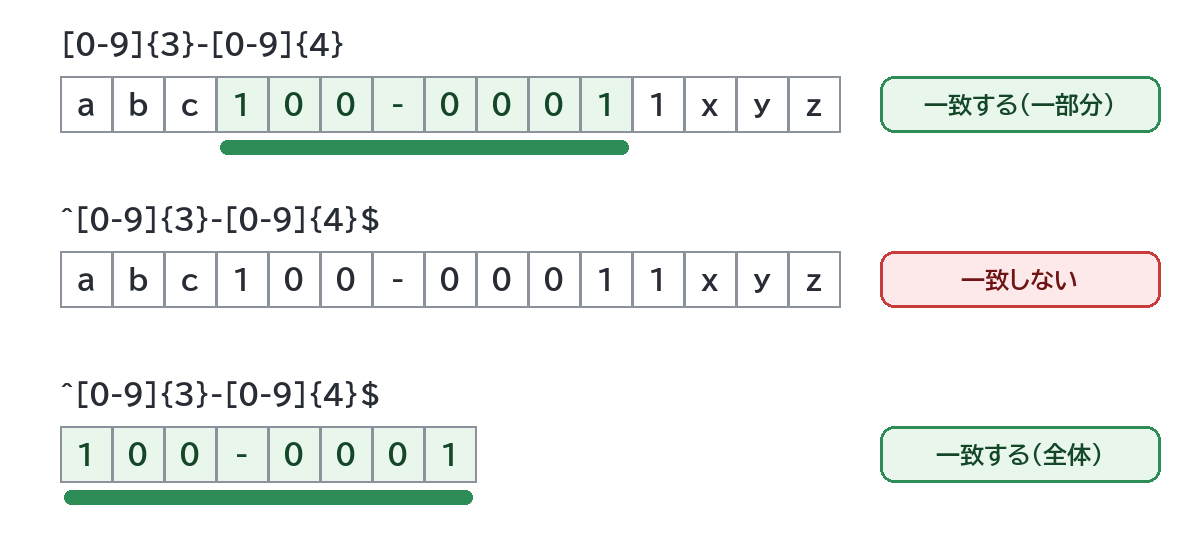
まず押さえたい考え方は、正規表現は基本的に「文字列の中に、その形の部分が 1 か所でもあれば一致」という点です。たとえば「[0-9]{3}-[0-9]{4}」は、「abc100-00011xyz」の中の「100-0001」の部分に一致してしまいます。文字列全体がその形かどうかを調べたいときは、先頭と末尾を表す ^ と $ で囲みます。この違いは後のパターン集でも何度も出てきます。
記号は大きく「どんな 1 文字か」「何回くり返すか」「どこにあるか」「まとめる・選ぶ」の 4 種類に分けると覚えやすくなります。
| 種類 | 記号 | 意味 | 例 → 一致するもの |
|---|---|---|---|
| 1 文字 | . | 任意の 1 文字(改行を除く) | a.c → abc、a-c、a c |
| 1 文字 | [abc] | 中のどれか 1 文字 | gr[ae]y → gray、grey |
| 1 文字 | [0-9] | 範囲の中の 1 文字 | [A-Za-z0-9_] → 英数字とアンダーバー |
| 1 文字 | [^0-9] | 中にない 1 文字 | [^0-9] → 数字以外の 1 文字 |
| 1 文字 | \d \w \s | 数字・単語の文字・空白(範囲は方言で違う) | \d → 0〜9 など |
| 回数 | * | 直前の 0 回以上 | ab*c → ac、abc、abbbc |
| 回数 | + | 直前の 1 回以上 | ab+c → abc、abbbc(ac は×) |
| 回数 | ? | 直前の 0 回か 1 回(省略可) | colou?r → color、colour |
| 回数 | {n} {n,m} {n,} | n 回、n〜m 回、n 回以上 | [0-9]{2,4} → 12、1234 |
| 位置 | ^ $ | 先頭、末尾 | ^ERROR → ERROR で始まる |
| まとめる | ( ) | ひとまとまりにする | (ab)+ → ab、abab |
| 選ぶ | | | または | log(in|out) → login、logout |
| そのまま | \ | 次の記号をただの文字にする | 1\.5 → 1.5 だけ |
「.」はどんな文字でも 1 文字に一致します。「a.c」は「abc」「a-c」「a c」に一致し、「ac」(間の文字がない)や「abbc」(間が 2 文字)には一致しません。「.」は 1 文字ちょうどという点が大切です。
[ ] は「この中のどれか 1 文字」です。「gr[ae]y」は「gray」「grey」に一致しますが、「graey」には一致しません([ ] 全体で 1 文字だからです)。[ ] の中では「.」や「+」はただの文字になり、「[.]」は「.」だけに一致しました。「-」を文字として入れたいときは「[-+]」のように先頭か末尾に置きます。先頭の「^」は否定で、「^[^0-9]+$」は「abc」や「あいう」に一致し、「a1c」には一致しません。
回数の記号は、すぐ前の 1 文字(または ( ) のまとまり)にかかります。「ab+c」の + は b だけにかかるので、「b が 1 回以上」という意味になり、「abbbc」には一致します。「ab」というまとまりをくり返したいときは「(ab)+」と書き、「^(ab)+$」は「ab」「abab」に一致し、「aba」には一致しませんでした。
「*」は 0 回でもよいので、思わぬものに一致します。「[0-9]*」で「ab12」から取り出すと、Python の re.findall と JavaScript の match(g フラグ付き)はどちらも ['', '', '12', ''] と、空の文字列を 3 つも返しました。数字が 1 つ以上ほしいなら「[0-9]+」を使います。
「^ERROR」は「ERROR: disk full」に一致し、「[app] ERROR: x」には一致しません。「\.log$」は「app.log」に一致し、「app.log.1」には一致しません。入力チェックでは、^ と $ で全体を囲むのが基本です。
なお、複数行の文字列では、JavaScript と Python の $ は初期状態だと文字列全体の末尾だけを指します。「line1 ok(改行)line2 ok」から「ok$」を探すと 1 件だけで、JavaScript の m フラグ、Python の re.M を付けると 2 件になりました。grep は 1 行ずつ調べるので、^ $ は各行の先頭・末尾です。
| は優先順位が最も低く、左右の全体を区切ります。「^cat|dog$」は「^cat」または「dog$」という意味になり、「catfish」や「hotdog」にも一致しました。「cat か dog のどちらかだけ」にしたいときは「^(cat|dog)$」と ( ) で囲みます。こちらは「catfish」「catdog」には一致しません。
( ) で囲んだ部分は「グループ」として後から取り出せます。置換で「2026/10/18」の年・月・日を並べ替えるときなどに使います(書き方の違いは後の表で紹介します)。
「.」「*」「+」「?」「(」「)」「[」「{」「|」「^」「$」「\」は記号として働くので、その文字自体を探したいときは前に \ を付けます(エスケープ)。「1.5」は「1.5」「105」「1×5」の 3 つすべてに一致しましたが、「1\.5」にすると「1.5」だけになりました。バージョン番号・IP アドレス・ファイルの拡張子で忘れやすいので注意しましょう。
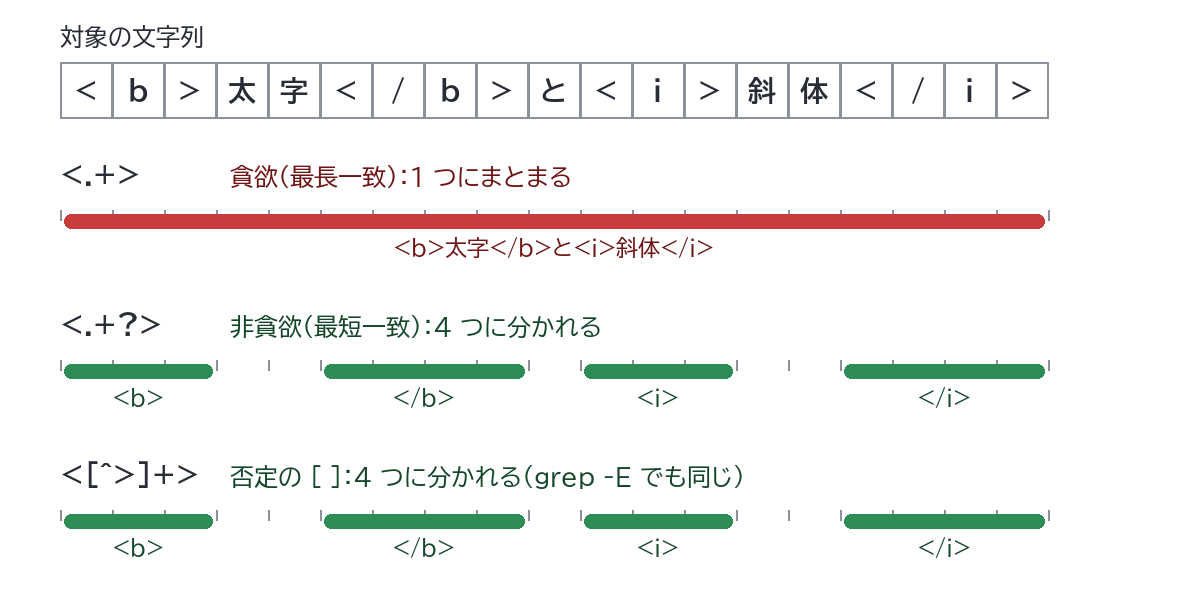
* や + は、できるだけ長く一致しようとします(貪欲、最長一致)。HTML のタグを取り出すつもりで「<.+>」と書くと、最初の < から最後の > までが 1 つにまとまってしまいます。次の Python のコードで確かめました。
import re

text = "<b>太字</b>と<i>斜体</i>"
print(re.findall(r"<.+>", text))
print(re.findall(r"<.+?>", text))
print(re.findall(r"<[^>]+>", text))
実行結果は次のとおりです。
['<b>太字</b>と<i>斜体</i>']
['<b>', '</b>', '<i>', '</i>']
['<b>', '</b>', '<i>', '</i>']
「+?」「*?」のように ? を後ろに付けると、できるだけ短く一致します(非貪欲、最短一致)。JavaScript でも同じ結果でした。ただし grep -E には最短一致がなく、「<.+?>」でも全体が 1 つにまとまりました。3 行目の「<[^>]+>」(> 以外の文字が続く)は最短一致を使わずに同じ結果になり、grep -E でも 4 つに分かれたので、どこでも使える書き方として覚えておくと便利です。
覚えるには、実際に動かしてみるのがいちばんです。同じパターン(郵便番号の形)を 3 つの方法で試してみましょう。
JavaScript:ブラウザで F12 キーを押して開発者ツールを開き、「コンソール」に入力します。true と表示されれば一致、false なら不一致です(コンソールの開き方は「JavaScriptとは?」で紹介しています)。
/^[0-9]{3}-[0-9]{4}$/.test("100-0001")Python:次のコードをファイルに保存して実行します。パターンは r”…”(raw 文字列)で書きます。
import re

pattern = r"^[0-9]{3}-[0-9]{4}$"
for s in ["100-0001", "1000001", "100-00011"]:
    print(s, bool(re.search(pattern, s)))
「100-0001 True」「1000001 False」「100-00011 False」と表示されました。
grep:Linux や Git Bash では grep -E で試せます。一致すればその行が表示され、一致しなければ何も表示されません。
echo '100-0001' | grep -E '^[0-9]{3}-[0-9]{4}$'パターンは必ずシングルクォート(’)で囲みます。囲まないと、シェルが * や { } を先に解釈してしまいます。grep の使い方は「grepコマンドの使い方」で詳しく解説しています。
ここからのパターンは、JavaScript・Python・grep -E のどれでも同じ結果になることを確かめたものです(\d を使わず [0-9] で書いているのはそのためです)。表の「○」は一致、「×」は不一致です。
^[0-9]{3}-[0-9]{4}$| 文字列 | 結果 | 理由 |
|---|---|---|
| 100-0001 | ○ | |
| 1000001 | × | ハイフンがない |
| 100-00011 | × | 後ろが 5 けた |
| 100-0001 | × | 全角数字は [0-9] に入らない |
ハイフンを省略してもよいなら「^[0-9]{3}-?[0-9]{4}$」とし、「1000001」も○になりました。^ と $ を外した「[0-9]{3}-[0-9]{4}」は「abc100-00011xyz」にも一致したので、入力チェックでは外さないようにします。
^0[0-9]{1,4}-[0-9]{1,4}-[0-9]{3,4}$| 文字列 | 結果 | 理由 |
|---|---|---|
| 03-1234-5678 | ○ | |
| 090-1234-5678 | ○ | |
| 0120-123-456 | ○ | |
| 3-1234-5678 | × | 0 で始まらない |
| 03-1234-56789 | × | 最後が 5 けた |
| 0312345678 | × | ハイフンがない |
| 01-1-234 | ○ | けた数が足りないのに通ってしまう |
最後の例のように、このパターンは「形」しか見ておらず、全体のけた数までは確かめていません。携帯電話番号だけに絞るなら「^0[789]0-[0-9]{4}-[0-9]{4}$」とすると、「090-1234-5678」「070-1234-5678」は○、「060-1234-5678」「090-123-5678」は×になりました。実際の番号の割り当ては変わることがあるので、厳しくしすぎないことも大切です。
^[A-Za-z0-9._%+-]+@[A-Za-z0-9-]+(\.[A-Za-z0-9-]+)+$| 文字列 | 結果 | 理由 |
|---|---|---|
| user@example.com | ○ | |
| taro.yamada+news@mail.example.co.jp | ○ | |
| user@example | × | @ の後ろに「.」がない |
| user@@example.com | × | @ が 2 つ |
| user name@example.com | × | 空白がある |
| a..b@example.com | ○ | RFC の形式では不正なのに通る |
| “a b”@example.com | × | RFC では書ける形式なのに通らない |
メールアドレスの書き方を定めた RFC 5322 では、@ の前は「1 文字以上の文字を . でつないだもの」(dot-atom)か、”…” で囲んだ文字列(quoted-string)と定められています。そのため「a..b」のように . が続くものは dot-atom としては不正で、逆に “a b” のような引用符付きは書き方としては認められています。正規表現でこれを完全に再現するのは難しく、HTML の仕様(WHATWG)でも、フォームの type=”email” の判定は RFC 5322 に「意図的に従わない」簡略化した定義になっています。
実務では、正規表現は「明らかな入力ミスを防ぐ」程度にとどめ、本当に届くかは確認メールで確かめるのが一般的です。
^[0-9]{4}-(0[1-9]|1[0-2])-(0[1-9]|[12][0-9]|3[01])$月は「01〜09」か「10〜12」、日は「01〜09」「10〜29」「30〜31」と、| で場合分けして範囲を表しています。正規表現は数値の大小を比べられないので、範囲は文字の組み合わせで書くのがコツです。
| 文字列 | 結果 | 理由 |
|---|---|---|
| 2026-10-18 | ○ | |
| 2026-1-5 | × | 月・日が 1 けた |
| 2026-13-01 | × | 13 月はない |
| 2026-10-32 | × | 32 日はない |
| 2026/10/18 | × | 区切りが「/」 |
| 2026-02-30 | ○ | 存在しない日付なのに通る |
2 月 30 日やうるう年まで正規表現で判定しようとすると、とても読みにくくなります。形だけを正規表現で確かめ、実在する日付かどうかはプログラムの日付の機能で確かめるのが確実です。「-」と「/」の両方と 1 けたの月日を許すなら「^[0-9]{4}[-/](0?[1-9]|1[0-2])[-/](0?[1-9]|[12][0-9]|3[01])$」です。ただしこれは「2026-1/5」のように区切りが混ざったものも○になりました。
24 時間制の時刻は「^([01][0-9]|2[0-3]):[0-5][0-9]$」で、「09:30」「23:59」は○、「24:00」「9:30」「12:60」は×でした。
簡単に書くと「^([0-9]{1,3}\.){3}[0-9]{1,3}$」です。「数字 1〜3 けたと . のまとまりを 3 回、最後に数字 1〜3 けた」という意味です。ただしこれは「999.1.1.1」も○になります。0〜255 の範囲まで確かめるなら、次のように場合分けします。
^((25[0-5]|2[0-4][0-9]|1[0-9]{2}|[1-9]?[0-9])\.){3}(25[0-5]|2[0-4][0-9]|1[0-9]{2}|[1-9]?[0-9])$| 文字列 | 簡単な版 | 範囲を確かめる版 |
|---|---|---|
| 192.168.1.10 | ○ | ○ |
| 255.255.255.0 | ○ | ○ |
| 999.1.1.1 | ○ | × |
| 256.1.1.1 | ○ | × |
| 192.168.01.1 | ○ | ×(先頭の 0 を許さない) |
| 1.2.3 | × | × |
「25[0-5]」が 250〜255、「2[0-4][0-9]」が 200〜249、「1[0-9]{2}」が 100〜199、「[1-9]?[0-9]」が 0〜99 です。長いログから取り出すときは ^ $ を外しますが、その場合「version 1.2.3.4.5」から「1.2.3.4」も取り出されたので、結果は目で確かめましょう。
| パターン | ○の例 | ×の例 |
|---|---|---|
| ^[ァ-ヶー]+$(全角カタカナ) | カタカナ、コーヒー、ヴァイオリン | かたかな、カタカナ(半角)、カタカナ1、カタカナ・テスト |
| ^[ぁ-んー]+$(ひらがな) | ひらがな、らーめん | カタカナ、ゔ |
| ^[A-Za-z0-9]+$(半角英数字) | abc123、ABC | abc(全角)、abc 123(空白) |
[ァ-ヶ] は文字の番号(Unicode のコードポイント)で U+30A1〜U+30F6 の範囲という意味です。長音「ー」(U+30FC)や中黒「・」(U+30FB)はこの範囲の外なので、ーは別に加えています。ひらがなの「ゔ」(U+3094)も「ん」(U+3093)より後ろなので×になりました。必要な文字は [ ] に足していきます。文字の番号については「文字コードとは?」も参考にしてください。
ただし \t(タブ)は grep -E では使えません。下の「方言の違い」を参照してください。置換したあとは、「テキスト差分比較ツール」で置換前と比べると、意図しない行まで変わっていないかを確かめられます。
正規表現には共通の部分が多い一方で、ツールごとに少しずつ違う「方言」があります。次の表は、JavaScript(Edge 155)、Python 3.12 の re、Git Bash の grep -E(GNU grep 3.0、ロケールは C.UTF-8)で実際に試した結果です。
| 試したこと | JavaScript | Python(re) | grep -E |
|---|---|---|---|
| \d が全角数字「123」に一致 | しない | する | \d は「d」という文字扱い(「123」にも一致せず、「ddd」に一致) |
| \w が「日本語」に一致 | しない | する | する |
| \s が全角スペースに一致 | する | する | する |
| \t でタブを表す | できる | できる | できない([ \t] にタブは一致しない) |
| [[:digit:]](POSIX の書き方) | 一致しない | 一致しない(FutureWarning が出る) | 使える |
| 最短一致 +? *? | 使える | 使える | 使えない(最長一致のまま) |
| 先読み (?=…) | 使える | 使える | 使えない(エラーにならず一致もしない) |
| + ? | ( ) { } を記号として使う | そのまま | そのまま | そのまま(-E なしの grep ではただの文字になる) |
| 大文字・小文字を区別しない | /error/i | re.I または (?i) | -i オプション |
| 置換でグループを使う | “$1-$2-$3” | r”\1-\2-\3″ | (置換は sed -E で \1-\2-\3) |
特に注意したいのが \d です。Python の \d は Unicode の数字すべてが対象で、全角数字やアラビア文字の数字「١٢٣」にも一致しました。re.ASCII(re.A)を付けると 0〜9 だけになります。サクラエディタの \d も全角数字に一致します(「サクラエディタの正規表現の使い方」で解説しています)。半角数字だけを確実に表したいときは [0-9] と書くのが、どの環境でも同じ結果になる書き方です。
grep の「-E なし」は基本正規表現(BRE)と呼ばれ、「ab+c」は「abc」に一致せず「ab+c」という文字列に一致しました。grep では -E を付ける、と覚えておくと迷いません。
JavaScript の test() や Python の re.search() は「どこか一部に一致すれば true」です。入力チェックで ^ $ を忘れると、「abc100-00011xyz」のような文字列が郵便番号として通ってしまいます。
前に見たとおり「^cat|dog$」は「catfish」にも一致します。| を使うときは「^(cat|dog)$」のように ( ) で範囲を決めましょう。
プログラムの文字列の中では、\ 自体が特別な意味を持ちます。Python 3.12 で r を付けずに “\d+” と書くと、動きはしたものの「SyntaxWarning: invalid escape sequence ‘\d’」という警告が出ました。パターンは r”\d+” のように raw 文字列で書きます。
JavaScript で new RegExp(“\d+”) と文字列から作ると、\ が消えてパターンは「d+」になり、”123″ に一致しませんでした。文字列で書くときは new RegExp(“\\d+”) と \ を 2 つにするか、/\d+/ のように / で囲む書き方を使います。
「2026-02-30」や「01-1-234」が通ったように、正規表現が確かめるのは文字の並び方だけです。日付・数値の範囲・実在するかどうかは、プログラム側でも確かめましょう。
なりません。ブラウザ側(JavaScript)のチェックは利用者が簡単に外せるため、サーバー側でも同じチェックを行います。また、画面に表示するときのエスケープや、SQL のプレースホルダーなどの対策は、入力チェックとは別に必要です。
IPv4 の例のように、部分ごとに分けて読みます。「(…)」の 1 つずつが何を表すかを書き出し、一致する例・しない例を表にして試すと、理解も修正もしやすくなります。1 つの正規表現で全部を判定しようとせず、形のチェックと値のチェックを分けるのも有効です。
この記事の記号([0-9]、+、?、{ }、( )、|、^、$)は、JavaScript・Python・grep -E のどれでも同じように動きました。まずは手元で試しやすいブラウザのコンソールか grep -E で練習し、\d や最短一致のような方言のある機能は、使う環境で確かめてから使うのがおすすめです。