UnicodeとUTF-16・サロゲートペアとは?絵文字の文字数がずれる理由と正しい数え方
hr
ENG LIFE BLOG
画面では同じ「が」に見えるのに、プログラムで比べると「違う文字列」と判定される。全角の「ABC」で検索すると半角の「ABC」が見つからない。こうした問題の多くは、Unicode 正規化(せいきか)で解決できます。
この記事では、見た目が同じでも違う文字列になる理由、NFC・NFD・NFKC・NFKD の 4 つの違い、全角半角をそろえるときの注意点を、Python・JavaScript・PowerShell で実際に動かした結果とあわせて解説します。
文字コードそのものの仕組みは「文字コードとは?」、UTF-8 のバイト数は「UTF-8とは?」で解説しています。
Unicode では、文字 1 つ 1 つに「U+304C」のような番号(コードポイント)が付いています。ところが、濁点の付いた「が」には、次の 2 通りの表し方があります。
| 表し方 | コードポイント | 文字の数(コードポイント数) |
|---|---|---|
| 「が」1 文字(合成済みの文字) | U+304C | 1 |
| 「か」+結合用の濁点 | U+304B U+3099 | 2 |
U+3099 は「COMBINING KATAKANA-HIRAGANA VOICED SOUND MARK(結合用の濁点)」という文字で、単独では表示されず、直前の文字に重なって表示されます。そのため、どちらも画面では同じ「が」に見えます。しかし、コンピューターは番号の並びで文字列を比べるので、この 2 つは「違う文字列」になります。
Python で確かめてみます。次のコードをファイルに保存して実行します。
import unicodedata

a = "が"          # 「が」1 文字(U+304C)
b = "が"    # 「か」+結合用の濁点(U+304B U+3099)

print(a == b)
print(len(a), len(b))
print([hex(ord(c)) for c in b])
print(unicodedata.normalize("NFC", b) == a)
Python 3.12 での実行結果です。
False
1 2
['0x304b', '0x3099']
True
そのまま比べると False、文字数も 1 と 2 で違います。最後の行のように、NFC という形に「正規化」してから比べると True になります。このように、見た目が同じ文字列を、決まった 1 つの表し方にそろえる処理が Unicode 正規化です。
よく話題になるのはファイル名です。Apple の技術資料「Technical Note TN1150: HFS Plus Volume Format」には、以前の Mac の標準ファイルシステムだった HFS Plus は、ファイル名を「fully decomposed and in canonical order(完全に分解し、決まった順に並べた形)」で保存すると書かれています。つまり「が」は「か+濁点」の形で保存されていました。
現在の Mac で使われている APFS について、Apple の「Apple File System Guide」の FAQ には、ファイル名の正規化の形を変えずにそのまま保存し(normalization-preserving)、macOS High Sierra では正規化の違いを区別せずにファイルを探せる(normalization-insensitive)と書かれています。同じ資料には、ある正規化の形で作ったファイルを別の形の名前で開こうとすると「File Not Found」になることがある、という注意もあります。
一方、Windows では事情が違います。この PC(Windows 11、NTFS)で、Python から「が.txt」と「か+濁点.txt」の 2 つのファイルを同じフォルダーに作ったところ、見た目が同じ名前のファイルが 2 つできました。
2
b'\\u304b\\u3099.txt' False
b'\\u304c.txt' True
(1 行目がフォルダー内のファイル数、2 行目以降が各ファイル名のコードポイントと、NFC になっているかどうかです。)ファイル名をプログラムで比べたり、一覧と照らし合わせたりするときに「あるはずのファイルが見つからない」原因になります。
ファイル名のほかにも、PDF やほかのアプリからコピーした文章、外部システムから受け取ったデータに「か+濁点」の形が混ざっていることがあります。どこから来たデータでも、比べる前に正規化しておけば安心です。
Unicode 正規化の方法は、Unicode の仕様書「Unicode Standard Annex #15(UAX #15)Unicode Normalization Forms」で決められています(2026 年 10 月時点の最新は Revision 58)。まず、文字どうしの「同じ」には 2 つの強さがあることを押さえます。
| 種類 | 意味 | 例 |
|---|---|---|
| 正準等価(canonical equivalence) | 表し方が違うだけで、まったく同じ文字。UAX #15 では「基本的な同等性」とされている | 「が」と「か+濁点」、「é」と「e+アクセント記号」 |
| 互換等価(compatibility equivalence) | 見た目や幅は違うが、同じ文字とみなせるもの。UAX #15 では「より弱い同等性」とされている | 「A」と「A」、「カ」と「カ」、「①」と「1」 |
これを組み合わせて、正規化には次の 4 つの形(正規化形式)があります。表の「定義」は UAX #15 の Table 1 の記述を訳したものです。
| 形式 | 定義(UAX #15) | ひとことで言うと |
|---|---|---|
| NFD | 正準分解 | 「が」を「か+濁点」に分ける |
| NFC | 正準分解のあと、正準合成 | 分けたあと、くっつけられるものは「が」1 文字にまとめる |
| NFKD | 互換分解 | 全角・半角などの違いもそろえたうえで、分ける |
| NFKC | 互換分解のあと、正準合成 | 全角・半角などの違いもそろえたうえで、まとめる |
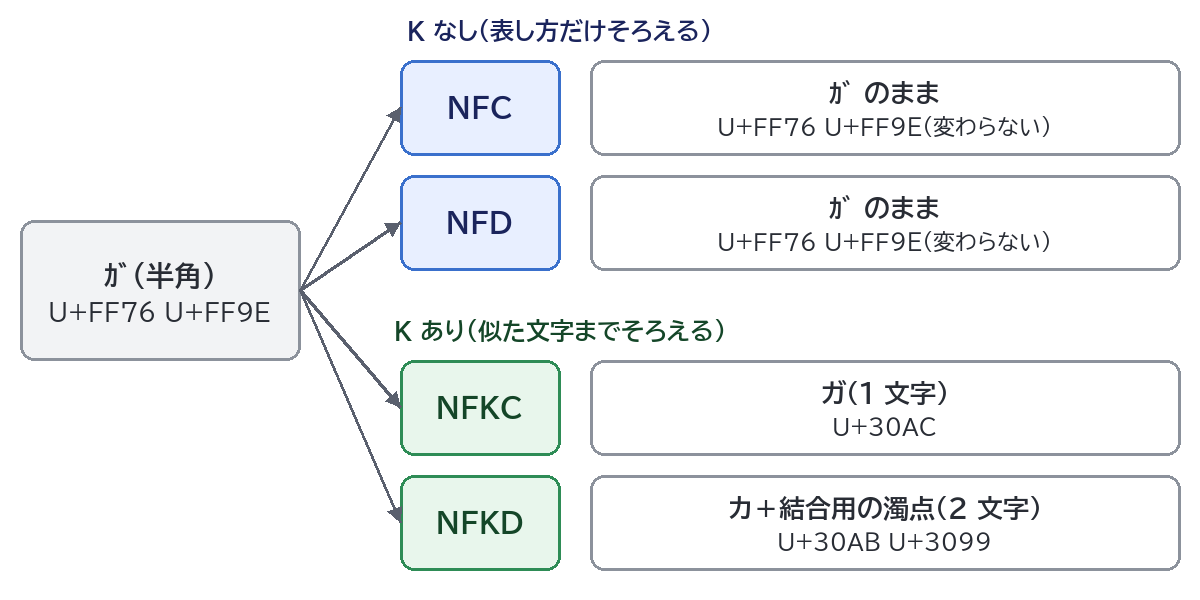
名前の「C」は Composition(合成)、「D」は Decomposition(分解)、「K」は Compatibility(互換)の意味です。K が付かない NFC・NFD は「同じ文字の表し方」だけをそろえ、K が付く NFKC・NFKD は「似た文字」までそろえる、と覚えておくと分かりやすいです。
半角カタカナの「ガ」(U+FF76 と半角濁点 U+FF9E の 2 文字)を 4 つの形で正規化すると、違いがよく分かります。
import unicodedata

for form in ["NFC", "NFD", "NFKC", "NFKD"]:
    s = unicodedata.normalize(form, "ガ")
    print(form, s, len(s), [hex(ord(c)) for c in s])
NFC ガ 2 ['0xff76', '0xff9e']
NFD ガ 2 ['0xff76', '0xff9e']
NFKC ガ 1 ['0x30ac']
NFKD ガ 2 ['0x30ab', '0x3099']NFC と NFD では半角カナのままで、何も変わりません。半角の「カ」と全角の「カ」は「表し方が違うだけの同じ文字」ではなく「似た文字」の扱いだからです。NFKC では全角の「ガ」1 文字に、NFKD では全角の「カ」+結合用の濁点の 2 文字になりました。
ほかの例もまとめます(Python 3.12 の unicodedata.normalize で確認。Python 3.12 が使う Unicode のデータは 15.0.0 です)。
| 元の文字 | NFC | NFD | NFKC | NFKD |
|---|---|---|---|---|
| が(U+304C) | が(1 文字) | か+濁点(2 文字) | が(1 文字) | か+濁点(2 文字) |
| か+濁点 | が(1 文字) | か+濁点 | が(1 文字) | か+濁点 |
| Abc123(全角) | 変わらない | 変わらない | Abc123(半角) | Abc123(半角) |
| ① | 変わらない | 変わらない | 1 | 1 |
| ㈱ | 変わらない | 変わらない | (株)(3 文字) | (株)(3 文字) |
日本語のデータでよく使うのは NFKC です。全角英数字と半角カナを一度にそろえられるからです。次のコードで、よく出てくる文字をまとめて変換してみます。
import unicodedata

s = "ABC123 パソコン①㈱"
print(unicodedata.normalize("NFKC", s))
print(unicodedata.is_normalized("NFKC", s))
ABC123 パソコン1(株)
False全角英数字は半角に、全角スペースは半角スペースに、半角カナは全角カナに、①は 1 に、㈱は (株) になりました。is_normalized は、文字列がすでにその形になっているかを調べる関数です(Python 3.8 以降)。
ほかの文字も含めて、NFKC での変わり方を表にまとめます。
| 種類 | 元の文字 | NFKC 後 |
|---|---|---|
| 全角英数字 | Abc123 | Abc123 |
| 全角記号 | !@_:/<> | !@_:/<> |
| 全角スペース | (U+3000) | 半角スペース(U+0020) |
| 半角カタカナ | アイウ・パソコン・ヴ | アイウ・パソコン・ヴ |
| 半角の長音 | ー | ー |
| 丸数字 | ①・⑩ | 1・10 |
| ローマ数字 | Ⅳ | IV(2 文字) |
| 囲み文字 | ㈱・Ⓐ | (株)・A |
| 組文字 | ㍿・㌔・㍻ | 株式会社・キロ・平成 |
| 単位・記号 | №・℡・™ | No・TEL・TM |
| 上付き・下付き | x²・H₂O | x2・H2O |
| 分数 | ½ | 1⁄2(「/」ではなく分数用の斜線 U+2044) |
| 三点リーダー | … | …(ピリオド 3 つ) |
| 合字 | fi | fi(2 文字) |
①や㈱は、Shift_JIS では「機種依存文字」と呼ばれ、文字化けの原因になりやすい文字です(「Shift_JISとは?」参照)。NFKC をかけると普通の文字に置き換わります。
NFKC は「何でも同じにしてくれる」わけではありません。次の文字は NFKC をかけてもそろいません(Python 3.12 で確認)。
| 文字 | NFKC 後 | 説明 |
|---|---|---|
| 〜(U+301C 波ダッシュ)と ~(U+FF5E 全角チルダ) | 〜 はそのまま、~ は ~(半角チルダ) | 見た目が似ていても別の文字のまま |
| ー(長音)・-(全角ハイフンマイナス)・−(マイナス記号)・‐(ハイフン) | - だけが – になり、ほかはそのまま | 横棒の仲間はそろわない |
| ¥(U+00A5)と \(U+005C) | そのまま | 全角の ¥ は ¥(U+00A5)に、全角の \ は \ になる |
| 髙 と 高 | そのまま | 異体字は別の文字 |
| ひらがな と カタカナ | そのまま | 「あ」と「ア」は別の文字 |
| 大文字 と 小文字 | そのまま | 「A」と「a」は別の文字 |
大文字・小文字をそろえたいときは、Python なら casefold()、JavaScript なら toLowerCase() を正規化と組み合わせます。ひらがな・カタカナをそろえたいときは、正規化とは別に変換の処理が必要です。
ここまでの例のとおり、標準ライブラリの unicodedata を使います。インストールは要りません。
unicodedata.normalize("NFC", 文字列):正規化した文字列を返す。第 1 引数は “NFC”・”NFD”・”NFKC”・”NFKD” のどれかunicodedata.is_normalized("NFC", 文字列):すでにその形になっていれば Trueunicodedata.unidata_version:使っている Unicode のデータのバージョン(Python 3.12 では “15.0.0”)JavaScript では、文字列の normalize() メソッドを使います。MDN によると、引数は “NFC”・”NFD”・”NFKC”・”NFKD” のどれかで、省略すると “NFC” になります。ブラウザで F12 キーを押して開発者ツールの「コンソール」に貼り付けると試せます。
const a = "が";
const b = "が";
console.log(a === b);
console.log(a.length, b.length);
console.log(a === b.normalize());
console.log("ガ①A㈱".normalize("NFKC"));
Microsoft Edge 155 での結果は、順に false、1 2、true、ガ1A(株) でした。Python と同じ結果です。
引数のつづりを間違えると、エラーになります。Edge 155 では "a".normalize("NFX") で次のエラーが出ました。
RangeError: The normalization form should be one of NFC, NFD, NFKC, NFKD.なお、a.localeCompare(b)(言語のルールに沿った比較)は 0(同じ)を返しました。一方、"ながの".includes("が") は false でした。比べ方によって結果が変わるので、検索や一致の判定では、先に両方を正規化しておくのが確実です。
PowerShell では、.NET の文字列の Normalize() メソッドを使います。Microsoft のドキュメントによると、引数なしでは「正規化形式 C」(NFC)になります。次の結果は Windows PowerShell 5.1 で確認しました。
まず、そのまま比べるコマンドです。[char]0x3099 は結合用の濁点を表します。実行すると「False」と表示されます。
"が".Equals("か" + [char]0x3099)NFC に正規化してから比べるコマンドです。実行すると「True」と表示されます。
"が".Equals(("か" + [char]0x3099).Normalize())NFKC にするときは、引数に “FormKC” を指定します(NFD は “FormD”、NFKD は “FormKD”)。実行すると「ABC123」と表示されます。
"ABC123".Normalize("FormKC")注意したいのは、PowerShell の -eq 演算子です。この PC(Windows PowerShell 5.1、表示言語は日本語)では、("か" + [char]0x3099) -eq "が" が True になりました。-eq は言語のルールに沿って比べるため、表し方の違いを同じとみなしたと考えられます。一方で .Equals() は False です。同じ PowerShell の中でも比べ方によって結果が変わるので、確実に比べたいときは両方を Normalize() してから比べましょう。PowerShell の基本は「PowerShellの基本コマンド一覧」で紹介しています。
社員名簿や商品名を検索する機能で、データには「パソコン」(半角)、利用者が入力したのは「パソコン」(全角)、ということはよくあります。保存されているデータと検索語の両方を同じ形に正規化してから比べると、こうした取りこぼしを防げます。比べるための「キー」を作る関数の例です。
import unicodedata

def normalize_key(s):
    return unicodedata.normalize("NFKC", s).casefold().strip()

print(normalize_key("TANAKA Taro ") == normalize_key("tanaka taro"))
print(normalize_key("パソコン"))
users = ["admin", "tanaka"]
print(normalize_key("admin") in users)
True
パソコン
TrueNFKC で全角半角をそろえ、casefold() で大文字・小文字をそろえ、strip() で前後の空白を取っています。全角スペースは NFKC で半角スペースになるので、strip() で一緒に取れます。
上の例の最後の行のように、全角の「admin」は、そのままでは「admin」と別の文字列です。正規化しないで登録を受け付けると、見た目が「admin」とほとんど同じアカウントを別人が作れてしまい、なりすましに使われるおそれがあります。ユーザー名やメールアドレスのように「同じかどうか」が大事な値は、登録するときもログインするときも同じ正規化をしてから比べるようにします。
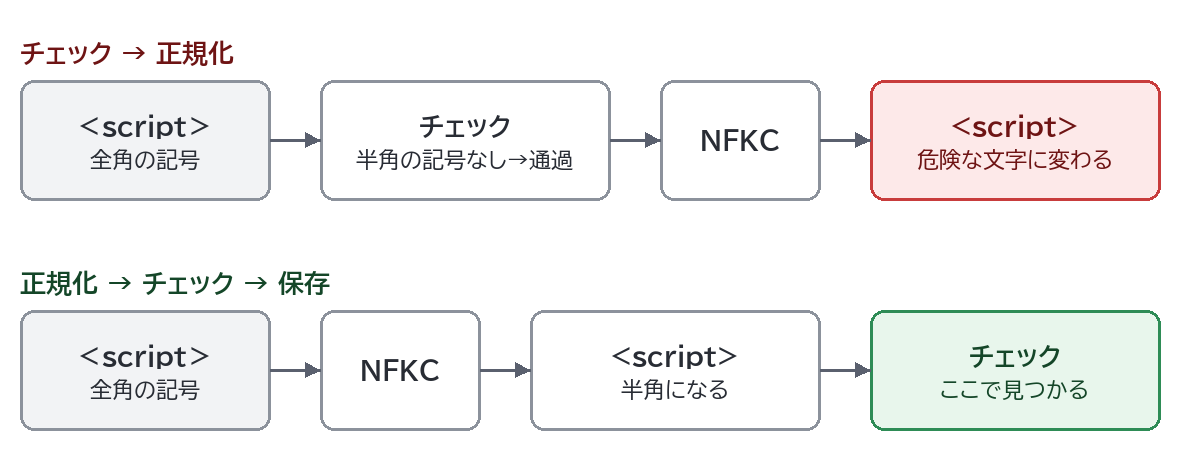
正規化する順番も大切です。次の例では、全角の「<」は、正規化前のチェックでは「<」と見なされませんが、NFKC のあとでは半角の「<」に変わります。
import unicodedata

name = "<script>"
print("<" in name)
name = unicodedata.normalize("NFKC", name)
print("<" in name, name)
False
True <script>「チェック → 正規化」の順にすると、チェックを通った文字列が、正規化によって危険な文字を含む文字列に変わってしまいます。正規化 → チェック → 保存の順にしましょう。また、HTML に表示するときのエスケープは、正規化とは別に必ず行います(「XSS(クロスサイトスクリプティング)とは?」参照)。
UAX #15 には、NFKC・NFKD について「Normalization Forms KC and KD must not be blindly applied to arbitrary text.(どんな文章にもむやみに適用してはならない)」と書かれています。多くの書式の違いを消してしまい、文章の意味にとって大事な区別までなくなることがあるためです。具体的には、次のような変化が起きます。
そのため、利用者が入力した文章そのものは元のまま(または NFC にして)保存し、NFKC は「検索や比較のためのキー」を作るときだけに使うのが安全です。用途ごとの目安をまとめます。
| 用途 | おすすめ | 理由 |
|---|---|---|
| 文章・本文の保存 | NFC(または何もしない) | 見た目も意味も変わらず、「が」と「か+濁点」だけがそろう |
| 検索用のキー・並べ替え用のキー | NFKC+大文字小文字の統一 | 全角半角の違いで見つからないのを防げる。元の文章は別に残す |
| ユーザー名・ID の重複チェック | NFKC+大文字小文字の統一 | 見た目がほぼ同じアカウントを防げる |
| ファイル名の比較 | NFC | NFKC で名前を書き換えると、①などを含むファイル名が別の名前になる |
| パスワード | 独自に決めず、使うライブラリや仕様に従う | 処理を変えると、以前のパスワードでログインできなくなる |
「全角の英数字と記号だけを半角にしたい。①や㈱、半角カナはそのままにしたい」という場合は、NFKC は変えすぎです。Python なら str.translate で、変換する文字を自分で決めた対応表を使えます。全角の「!」(U+FF01)から「~」(U+FF5E)までは、半角の「!」(U+0021)から「~」(U+007E)と同じ順に並んでいるので、番号を 1 つずつずらして対応表を作れます。
ZEN = "".join(chr(0xFF01 + i) for i in range(94)) + " "
HAN = "".join(chr(0x21 + i) for i in range(94)) + " "
table = str.maketrans(ZEN, HAN)

print("Abc123! @".translate(table))
print("ガ①㈱".translate(table))
Abc123! @
ガ①㈱全角英数字・記号・全角スペースだけが半角になり、「ガ①㈱」は変わっていません。NFKC と違い、どの文字をどう変えるかを自分で決められるのが利点です。半角カナを全角にする処理も、同じように対応表を作れば書けます(濁点の付く文字は 2 文字を 1 文字にまとめる必要があるため、少し手間がかかります)。
検索語だけを NFKC にして、データベースの値はそのまま、という書き方では、データ側の「パソコン」は見つかりません。比べる両方を同じ形式で正規化します。データが多い場合は、正規化したキーを別の列に保存しておくと、毎回変換しなくて済みます。
濁点には、結合用の濁点(U+3099)とは別に、キーボードで「゛」と入力したときの単独の濁点(U+309B)があります。「か゛」(U+304B U+309B)を NFKC にすると、結果は「か」+半角スペース+結合用の濁点(U+304B U+0020 U+3099)になり、「が」にはなりませんでした。単独の濁点は前の文字とくっつかないので、正規化では「が」にできません。
NFC でも、文字が変わることがあります。たとえば、オングストロームの記号「Å」(U+212B)は、NFC にするとアルファベットの「Å」(U+00C5)に変わりました(Python 3.12 で確認)。見た目は同じですが、コードポイントが違うので、元のバイト列と完全に同じでなければならないデータ(電子署名をしたデータなど)には、正規化をかけないようにします。
ファイル一覧と比べるために名前を NFKC にすると、「資料①.xlsx」は「資料1.xlsx」になり、実際のファイル名と一致しなくなります。ファイル名を比べるときは NFC でそろえ、ファイルを開くときは、一覧から取り出した元の名前を使いましょう。
文章を保存するなら NFC、検索や重複チェックのための比較なら NFKC が目安です。迷ったら「元の文章は NFC で保存し、比較用のキーだけ NFKC で作る」と考えると、意味が変わる心配がありません。
違います。正規化は、正しく読めている文字の「表し方」をそろえる処理です。「縺薙s縺ォ縺。縺ッ」のような文字化けは、文字コード(UTF-8 と Shift_JIS など)の読み違いが原因なので、正規化しても直りません。文字化けを直したいときは、文字化け復元ツールで元の文字コードの候補を確かめてください。
Python の len() や JavaScript の length では 2 になります。見た目どおり 1 文字と数えたいときは、先に NFC にするか、見た目の 1 文字単位で数える方法を使います(詳しくは「UnicodeとUTF-16・サロゲートペアとは?」で解説しています)。文字数・バイト数カウントは、濁点を組み合わせた文字も見た目どおり 1 文字として数え、UTF-8・Shift_JIS のバイト数も同時に表示できます。
Unicode 正規化ではできません。「あ」と「ア」は、NFKC でも別の文字のままです。そろえたいときは、ひらがなとカタカナの対応表を使った変換を、正規化とは別に行います。