浮動小数点数の誤差とは?0.1+0.2が0.3にならない理由と対処法
hr
ENG LIFE BLOG
JavaScript で "😀".length を実行すると、1 ではなく 2 が返ってきます。家族の絵文字「👨👩👧👦」にいたっては 11 です。入力欄の文字数チェックやデータベースの文字数制限で、「見た目は 1 文字なのに上限を超える」という不具合が起きるのはこのためです。
この記事では、原因となる Unicode の「コードポイント」と UTF-16 の「サロゲートペア」の仕組みを、😀 を実際に計算しながら解説します。そのうえで、言語ごとの「文字数」の違い、文字列を途中で切ると壊れる例、データベースの注意点を紹介します。
UTF-8 のバイト数や BOM、文字化けの直し方は「UTF-8とは?」「文字コードとは?」で解説しているので、この記事では UTF-16 と絵文字の数え方を中心に説明します。
Unicode(ユニコード)は、世界中の文字に 1 つずつ番号を付けた一覧表です。この番号をコードポイントといい、「U+」の後ろに 16 進数を書いて表します。
| 文字 | コードポイント | 10 進数 |
|---|---|---|
| A | U+0041 | 65 |
| あ | U+3042 | 12354 |
| 😀 | U+1F600 | 128512 |
| 𠮷(「吉」の上が「土」の字) | U+20BB7 | 134071 |
コードポイントは 0 から 10FFFF(16 進数)までの範囲と決められています(Unicode の用語集 Glossary の「Code Point」の定義)。大事なのは、コードポイントはあくまで「番号」で、ファイルやメモリーに保存するときのバイトの並びとは別だということです。番号をバイトに変える方式が UTF-8・UTF-16・UTF-32 で、同じ 😀 でも方式によって保存される中身が変わります。
Unicode では、65,536 個(16 進数で 10000 個)ずつのまとまりを「面(プレーン)」と呼びます。U+0000〜U+10FFFF は、面 0 から面 16 までの 17 面に分かれます。
| 名前 | 範囲 | 入っている文字の例 |
|---|---|---|
| 基本多言語面(BMP、面 0) | U+0000〜U+FFFF | 英数字、ひらがな・カタカナ、よく使う漢字、多くの記号 |
| 補助面(面 1〜16) | U+10000〜U+10FFFF | 😀 などの多くの絵文字、𠮷 などのめずらしい漢字、古代文字 |
BMP の文字は 16 ビット(2 バイト)の数 1 つに収まりますが、補助面の文字は収まりません。この「収まらない文字」をどう表すかが、次のサロゲートペアの話です。補助面にある文字を「補助文字(supplementary character)」と呼びます。
UTF-16 は、16 ビットの数(これをコード単位といいます)を並べて文字を表す方式です。BMP の文字はコードポイントの番号をそのまま 1 コード単位にします。たとえば「あ」(U+3042)は 3042 の 1 単位です。
補助面の文字は、2 つのコード単位の組み合わせで表します。これがサロゲートペアです。1 つ目を上位サロゲート(high surrogate)、2 つ目を下位サロゲート(low surrogate)といい、それぞれ専用の範囲が予約されています。
| 種類 | 範囲 | 役割 |
|---|---|---|
| 上位サロゲート | D800〜DBFF | ペアの 1 つ目。番号の上位 10 ビットを運ぶ |
| 下位サロゲート | DC00〜DFFF | ペアの 2 つ目。番号の下位 10 ビットを運ぶ |
U+D800〜U+DFFF の範囲にはふつうの文字が割り当てられていないので、UTF-16 のデータを読む側は「D800〜DBFF が来たら、次の単位とセットで 1 文字」と判断できます。
RFC 2781(UTF-16 の仕様)の 2.1 節に書かれている手順どおりに、😀 を計算してみます。
これで、😀 は UTF-16 で「D83D DE00」の 2 コード単位になることが分かりました。2 進数と 16 進数の読み替えに慣れていない場合は「2進数・16進数の基本」も参考にしてください。
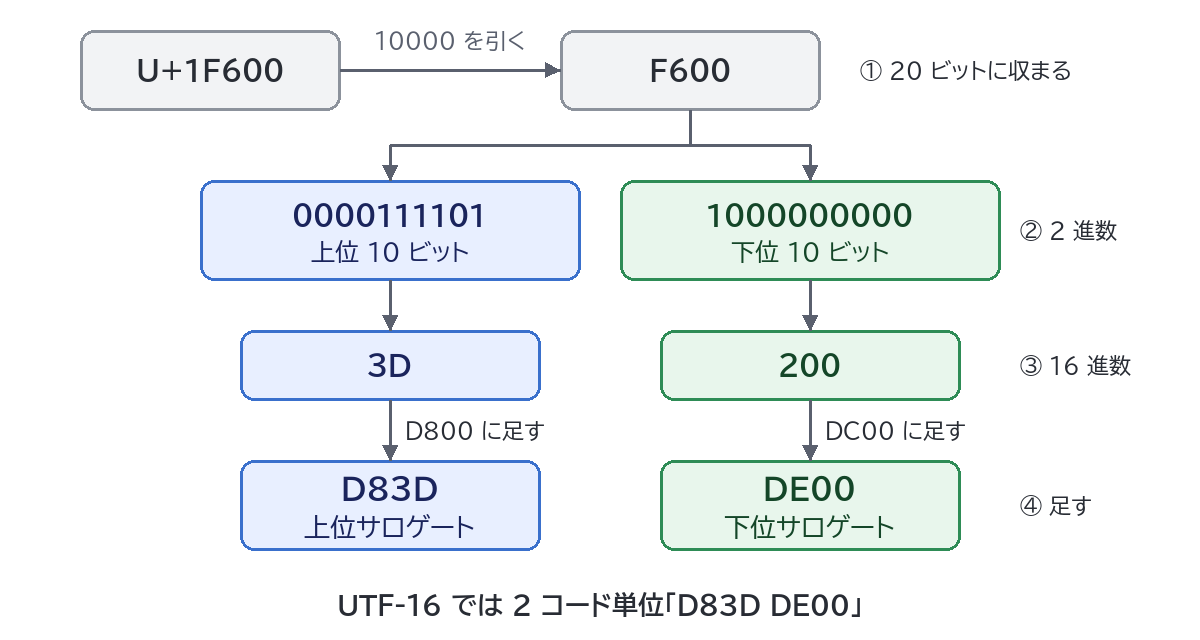
同じ計算を Python で書くと次のようになります。「>> 10」は 10 ビット右にずらす(上位 10 ビットを取り出す)、「& 0x3FF」は下位 10 ビットだけを残す、という意味です。
cp = 0x1F600
v = cp - 0x10000
high = 0xD800 + (v >> 10)
low = 0xDC00 + (v & 0x3FF)
print(hex(v), hex(high), hex(low))
print("😀".encode("utf-16-be").hex(" "))
Windows 11 の Python 3.12 で実行した結果です。自分で計算した値と、Python に UTF-16(ビッグエンディアン)で変換させたバイトが一致しています。
0xf600 0xd83d 0xde00
d8 3d de 00
逆に、サロゲートペアからコードポイントに戻すには「(上位 − D800) × 400 + (下位 − DC00) + 10000」を計算します。(D83D − D800) は 3D、3D × 400 = F400、(DE00 − DC00) は 200 なので、F400 + 200 + 10000 = 1F600 に戻ります。
同じ文字を 3 つの方式で保存したときのバイト(16 進数)を比べます。Python の encode("utf-8")・encode("utf-16-be")・encode("utf-32-be") で確かめた値です。
| 文字 | UTF-8 | UTF-16 | UTF-32 |
|---|---|---|---|
| A(U+0041) | 41(1 バイト) | 00 41(2 バイト) | 00 00 00 41(4 バイト) |
| あ(U+3042) | E3 81 82(3 バイト) | 30 42(2 バイト) | 00 00 30 42(4 バイト) |
| 😀(U+1F600) | F0 9F 98 80(4 バイト) | D8 3D DE 00(4 バイト) | 00 01 F6 00(4 バイト) |
UTF-16 は「2 バイト固定」と誤解されがちですが、補助面の文字は 4 バイトです。昔の「Unicode は 65,536 文字まで」という前提で作られたプログラムが、絵文字で不具合を起こすのはこのためです。
プログラムの「文字数」は、次のどれを数えているかで結果が変わります。
length、Java の length()len()サロゲートペアの問題は「コード単位」と「コードポイント」のずれです。しかし実際には、複数のコードポイントを組み合わせて 1 文字に見せる仕組みもあるため、「コードポイント」と「書記素」もずれます。次の表は、JavaScript(Microsoft Edge 155)と Python 3.12 で実際に数えた結果です。
| 見た目 | 中身(コードポイント) | UTF-16 コード単位 | コードポイント | 書記素 |
|---|---|---|---|---|
| あ | U+3042 | 1 | 1 | 1 |
| 😀 | U+1F600 | 2 | 1 | 1 |
| 𠮷 | U+20BB7 | 2 | 1 | 1 |
| が(結合文字の濁点) | U+304B + U+3099 | 2 | 2 | 1 |
| é(結合文字のアクセント) | U+0065 + U+0301 | 2 | 2 | 1 |
| ❤️(絵文字スタイルの指定) | U+2764 + U+FE0F | 2 | 2 | 1 |
| 葛(異体字の指定) | U+845B + U+E0100 | 3 | 2 | 1 |
| 👍🏽(肌の色) | U+1F44D + U+1F3FD | 4 | 2 | 1 |
| 🇯🇵(国旗) | U+1F1EF + U+1F1F5 | 4 | 2 | 1 |
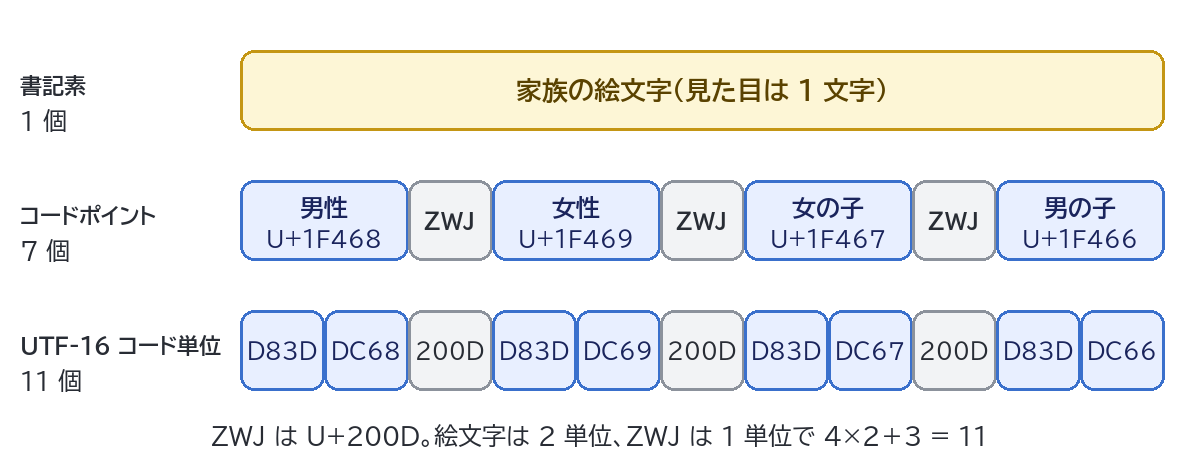
| 👨👩👧👦(家族) | 👨 ZWJ 👩 ZWJ 👧 ZWJ 👦 | 11 | 7 | 1 |
それぞれの仕組みを簡単に説明します。
貼り付けた文章のコードポイント数・UTF-16 のコード単位数・見た目の文字数をまとめて確かめたいときは、「文字数・バイト数カウント」ツールが使えます。絵文字を見た目どおり 1 文字と数え、参考としてコードポイント数と UTF-16 のコード単位数も表示します。
JavaScript の文字列は UTF-16 のコード単位の並びです。ブラウザの開発者ツール(F12 キー →「コンソール」タブ)で試せます。次の例は Microsoft Edge 155 で確認しました。
length はコード単位の数なので、😀 は 2 になります。
"😀".lengthスプレッド構文 [...s] は文字列をコードポイントごとに分けるので、😀 は 1 になります。ただし家族の絵文字は 7 です。
[..."👨👩👧👦"].length見た目どおりの文字数(書記素の数)を数えるには Intl.Segmenter を使います。家族の絵文字も 1 になります。
[...new Intl.Segmenter("ja", {granularity: "grapheme"}).segment("👨👩👧👦")].length1 文字ずつの値を調べるときは、charCodeAt() がコード単位(😀 の 0 番目は d83d、1 番目は de00)、codePointAt() がコードポイント(😀 の 0 番目は 1f600)を返します。正規表現も同じで、/^.$/.test("😀") は false、u フラグを付けた /^.$/u.test("😀") は true になります。
Python 3 の文字列はコードポイントの並びなので、len("😀") は 1 です。サロゲートペアを意識する場面はほとんどありませんが、結合文字や ZWJ 絵文字はコードポイントごとに数えられます。
s = "👨👩👧👦"
print(len(s))
print(len(s.encode("utf-16-le")) // 2)
print(len(s.encode("utf-8")))
print([f"U+{ord(c):04X}" for c in s])実行結果です。コードポイントは 7 個、UTF-16 では 11 コード単位、UTF-8 では 25 バイトです。
7
11
25
['U+1F468', 'U+200D', 'U+1F469', 'U+200D', 'U+1F467', 'U+200D', 'U+1F466']
Python の標準ライブラリには、書記素で区切る機能はありません(Python 3.12 で確認)。見た目の文字数が必要なら、書記素の区切りに対応した外部ライブラリを使うことになります。なお、Windows のコマンドプロンプトや PowerShell で絵文字を print すると UnicodeEncodeError になることがあります。そのときは py -X utf8 ファイル名.py のように UTF-8 モードで実行してください。
Java の String も UTF-16 なので、length() は JavaScript の length と同じくコード単位の数です。コードポイントの数は codePointCount()、書記素の数は java.text.BreakIterator で数えます。次は Java 21(21.0.1)で実行した例です。
String s = new String(Character.toChars(0x1F600)); // 😀
System.out.println(s.length());                      // 2
System.out.println(s.codePointCount(0, s.length())); // 1
System.out.println(Integer.toHexString(s.charAt(0))); // d83d
System.out.println(Character.isHighSurrogate(s.charAt(0))); // true
Java 21 の BreakIterator.getCharacterInstance() で数えると、家族の絵文字と 🇯🇵 は 1、「か」+結合文字の濁点も 1 になりました。古い Java では結果が違う可能性があるので、使う Java のバージョンで確かめてください。
「先頭から 10 文字だけ表示する」「140 文字で切る」といった処理を、数え方を意識せずに書くと文字が壊れます。
"あ😀".slice(0, 2) はコード単位で 2 つ分なので、「あ」と 😀 の上位サロゲート(D83D)だけが残ります。ペアの片方だけのサロゲートは「孤立サロゲート」と呼ばれ、Unicode の FAQ でも UTF としては不正(invalid)とされています。画面には「�」のような文字が表示されます。不正な文字列かどうかは isWellFormed() で調べられ、次の結果は false です。
"あ😀".slice(0, 2).isWellFormed()このような文字列を URL に入れようとすると、encodeURIComponent() は「URIError: URI malformed」というエラーを出します。また TextEncoder で UTF-8 に変換すると、孤立サロゲートは EF BF BD(置換文字「�」)に置き換わり、元の絵文字は失われます。
encodeURIComponent("あ😀".slice(0, 2))同じ理由で、s.split("").reverse().join("") で文字列を逆順にすると、絵文字の上位と下位が入れ替わって壊れます。[...s].reverse().join("") ならコードポイント単位なので 😀 は壊れません(ただし家族の絵文字などはばらばらになります)。
「あ😀」は UTF-8 で 7 バイト(3 + 4)です。「5 バイトまで」と切ると、😀 の 4 バイトのうち 2 バイトだけが残り、デコードできなくなります。
b = "あ😀".encode("utf-8")
print(b[:5].decode("utf-8", errors="replace"))
b[:5].decode("utf-8")実行結果です。errors="replace" を付けた 2 行目は壊れた部分が「�」になり、3 行目はエラーで止まります。
あ�
UnicodeDecodeError: 'utf-8' codec can't decode bytes in position 3-4: unexpected end of dataファイルを決まったバイト数ずつ読み込んで、そのたびにデコードする処理でも同じことが起きます。ファイルの読み書きは「Pythonのファイル読み書き」で解説しているように、open() に encoding を指定してテキストとして読めば、Python が文字の境目を正しく扱います。
Python で家族の絵文字の先頭 3 コードポイント(s[:3])を取り出すと「👨👩」(男性+ZWJ+女性)になり、家族が 2 人に減ってしまいます。JavaScript の "👨👩👧👦".slice(0, 5) でも同じく「👨👩」になりました。エラーは出ませんが、意味が変わってしまうので気付きにくい不具合です。
見た目の文字単位で切りたいときは、JavaScript なら Intl.Segmenter で区切ってから先頭の何個かをつなげます。Edge 155 で「👨👩👧👦あいう」の先頭 2 個を取り出すと、「👨👩👧👦あ」と正しく取り出せました。
データベースの「何文字まで」も、どの単位で数えるかを確かめる必要があります。MySQL 8.4 のリファレンスマニュアルでは、VARCHAR(M) の M は保存できる最大の文字数とされています。また、strict モード(厳密モード)が有効なら上限を超える値は保存されずにエラーになり、無効なら切り詰めて警告を出すと書かれています。
もう 1 つの落とし穴が、MySQL の文字コード名「utf8」です。
| MySQL の文字コード | 1 文字の最大バイト数 | 補助面の文字(😀・𠮷 など) |
|---|---|---|
| utf8mb3(以前は utf8 という名前で使われていた) | 3 バイト | 保存できない |
| utf8mb4 | 4 バイト | 保存できる |
MySQL の公式ドキュメント(8.4)によると、「utf8」はこれまで utf8mb3 の別名として使われてきましたが、この使い方は非推奨になっています。utf8mb3 は BMP の文字しか扱えず、補助面の文字は保存できません。utf8mb3 自体も非推奨で、将来のメジャーリリースで削除される予定とされ、新しいアプリケーションには utf8mb4 を使うよう推奨されています。MySQL 8.4 のサーバーの文字コードの既定値は utf8mb4 です。
古いテーブルが utf8(utf8mb3)のままだと、「日本語は保存できるのに、絵文字や 𠮷 だけ保存できない」という現象が起きます。また、アプリ側の入力チェックを JavaScript の length で、データベース側をコードポイント数で数えていると、絵文字の多い文章で上限の判定が食い違います。参考までに、SQLite(3.45.3)の length() で数えると 😀 は 1、家族の絵文字は 7 で、コードポイントの数でした。
Intl.Segmenter を使い、データベースの上限と合わせたいならデータベースと同じ単位で数えます。よく使う漢字の多くは BMP にあるので 1 コード単位です。ただし「𠮷」(U+20BB7)のように補助面にある漢字もあり、人名や地名で使われることがあります。"𠮷".length は 2 です。
ありません。UTF-8 は補助面の文字を 4 バイトで直接表します。RFC 3629 は、サロゲート用の番号(U+D800〜U+DFFF)を UTF-8 で表すことを禁止しています。Python で孤立サロゲートを encode("utf-8") すると「surrogates not allowed」というエラーになります。
目的で選びます。画面に表示する文字数や「〇文字まで入力できます」の表示は書記素、データベースや API の上限チェックは保存先と同じ単位(文字数ならコードポイント、バイト数なら UTF-8 のバイト数など)、文字列を切るときは書記素の境目で切るのが安全です。