.envと環境変数で秘密情報を守る|APIキーをGitに上げない方法と漏れたときの対処
hr
ENG LIFE BLOG
ログイン機能のある Web サービスを作ると、利用者のパスワードをデータベースに保存する必要が出てきます。このとき「どう保存するか」を間違えると、データベースが漏れた瞬間に、利用者のパスワードがそのまま知られてしまいます。しかも多くの人は同じパスワードを別のサービスでも使っているため、被害は自分のサービスだけでは終わりません。
この記事では、開発者の立場から「パスワードをどう保存すれば安全か」を、セキュリティの団体 OWASP の資料(Password Storage Cheat Sheet)の原文で確かめた内容をもとに説明します。Python の標準ライブラリだけで動く保存・照合のコードと、この PC で実際に測った計算時間も載せています。
この記事で分かること:
hashlib.pbkdf2_hmac・hashlib.scrypt・hmac.compare_digest を使った保存と照合のコードパスワードの保存方法を考えるときは、「データベースの中身が攻撃者の手に渡った」という最悪の状況を前提にします。SQL インジェクションのような脆弱性、バックアップファイルの置き忘れ、内部の人による持ち出しなど、漏れる経路はいくつもあるからです。
そのうえで目指すのは、「データベースを見てもパスワードそのものは分からず、候補を 1 つずつ試して突き止めようとしても膨大な時間と費用がかかる」状態です。
ログイン時は、入力されたパスワードで保存時と同じ計算をして比べます。サーバーは元のパスワードを知らなくても照合できればよいのです。
データベースを見られた時点で全員のパスワードが分かります。運用担当者に見えてしまう点も問題です。
暗号化は「鍵があれば元に戻せる」仕組み(可逆)です。OWASP は「暗号化は双方向の関数なので、攻撃者は暗号化されたデータから元の平文を取り出せる」と説明し、パスワードは暗号化ではなくハッシュ化するよう勧めています。暗号化を使ってよいのは、別のシステムにログインするためにどうしても元のパスワードが必要な、例外的な場合だけです。
サーバーが鍵を使って復号できるなら、そのサーバーに侵入した攻撃者も同じことができます。「パスワードを忘れたら、今のパスワードをメールで送ります」というサービスは、元に戻せる形で保存している可能性が高いと言えます。なお、Base64 は暗号化ですらなく、誰でも元に戻せる変換です(「Base64とは?」を参照)。
ハッシュは元に戻せない(一方向の)計算なので、暗号化よりはましです。しかし、SHA-256 や MD5 をそのまま 1 回使うだけでは不十分です。理由は 2 つあります。
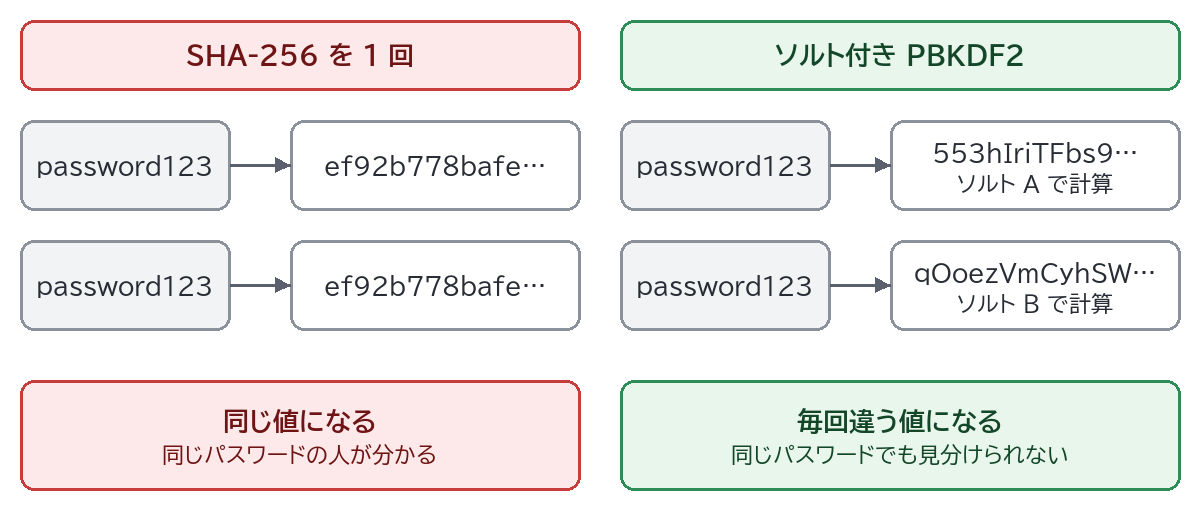
1 つ目は、同じパスワードからは必ず同じ値ができることです。次のコードで確かめます。
import hashlib
for pw in ["password123", "password123", "Password123"]:
    print(pw, hashlib.sha256(pw.encode()).hexdigest())
Python 3.12 での結果です。
password123 ef92b778bafe771e89245b89ecbc08a44a4e166c06659911881f383d4473e94f
password123 ef92b778bafe771e89245b89ecbc08a44a4e166c06659911881f383d4473e94f
Password123 008c70392e3abfbd0fa47bbc2ed96aa99bd49e159727fcba0f2e6abeb3a9d601
同じパスワードの人は同じ値になるので、データベースを見れば「この人たちは同じパスワードだ」と分かります。また、よく使われるパスワードのハッシュ値をあらかじめ計算した表(レインボーテーブルなど)を用意しておけば、表を引くだけで元のパスワードが分かってしまいます。
2 つ目は、計算が速すぎることです。SHA-256 はファイルの改ざんチェックなどに使うため、速く計算できるように作られています。OWASP も「SHA-256 のような速いハッシュは、攻撃者が大量の推測を素早く行えるため、パスワードの保存には適さない」と書いています。どれくらい速いかは、後の「計算時間を比べる」で実測します。
SHA-256 や MD5 の値を実際に計算してみたいときは、「ハッシュ生成ツール」が使えます。このツールはファイルの改ざんチェック用で、ページ内でも「パスワードの保存には使わない」ことを説明しています。
速いハッシュの弱点を補うのがソルトとストレッチング、追加の守りがペッパーです。
| しくみ | 内容 | 防ぐもの | 保存場所 |
|---|---|---|---|
| ソルト | ユーザーごとに作るランダムな値をパスワードに加えて計算する | 同じパスワードが同じ値になること、事前に計算した表 | ハッシュ値と一緒に DB に保存してよい |
| ストレッチング | 計算をわざと何十万回も繰り返したり、メモリを多く使わせたりして遅くする | 大量の候補を高速に試すこと | 回数などの設定値を DB に一緒に保存する |
| ペッパー | 全ユーザー共通の秘密の値を計算に加える | DB だけが漏れた場合の解析 | DB とは別の場所(秘密情報の保管庫など) |
ソルトは「塩」のことで、パスワードに振りかけるランダムな値です。ユーザーごとに違うソルトを使えば、同じ「password123」でもハッシュ値はまったく別になります。OWASP は、ソルトによって攻撃者はハッシュを 1 つずつ、それぞれのソルトで解かなければならなくなり、事前に計算した表も使えなくなると説明しています。
ソルトは秘密にする必要はなく、ハッシュ値と一緒に保存します(照合のときに同じソルトが必要だからです)。大事なのは「ユーザーごとに、毎回、安全な乱数で作る」ことです。Python のドキュメントは、ソルトを os.urandom() などの適切な乱数で作った 16 バイト程度以上にするよう書いています。
ソルトがあっても、よくあるパスワードを上から順に試されると、弱いパスワードは見つかってしまいます。そこで、1 回の計算にわざと時間がかかるようにします。正しいパスワードを知っている本人は 1 回計算するだけなので、0.1 秒かかっても困りません。しかし何億もの候補を試したい攻撃者にとっては、1 回の時間が長いほど負担が大きくなります。
どれだけ遅くするかを決める値を「ワークファクター」と呼びます(PBKDF2 なら繰り返し回数、Argon2id や scrypt ならメモリ量と回数)。コンピューターが速くなったら上げていきます。
ペッパーは「胡椒」で、全ユーザー共通の秘密の値です。ソルトと違い、データベースには保存せず、秘密情報の保管庫(シークレット管理サービス)や HSM(鍵を安全に保管する専用の装置)に置きます。SQL インジェクションなどでデータベースだけが盗まれた場合、ペッパーが分からないので解析できません。
OWASP はペッパーを「多層防御として検討する(それだけでは安全性は増えない)」ものとしています。ペッパーを変えると全員のパスワードの再設定が必要になる点にも注意します。
ソルトとストレッチングを組み込んだ、パスワード保存専用の方式がいくつかあります。OWASP の Password Storage Cheat Sheet が勧める方式と最低限の設定値は次のとおりです(2026 年 10 月 18 日に原文で確認)。
| 方式 | 位置づけ | 設定値の目安(最低限) |
|---|---|---|
| Argon2id | 第一の選択肢 | メモリ 19 MiB(m=19456)、回数 t=2、並列度 p=1 |
| scrypt | Argon2id が使えないとき | N=2^17(128 MiB)、r=8、p=1 |
| bcrypt | Argon2・scrypt が使えない既存システム向け | ワークファクター 10 以上。入力は 72 バイトまで |
| PBKDF2 | FIPS-140 への準拠が必要なとき | HMAC-SHA-256 で 600,000 回以上(HMAC-SHA-512 なら 220,000 回) |
出典:OWASP Cheat Sheet Series「Password Storage Cheat Sheet」(2026 年 10 月 18 日確認)。この数値は改訂されることがあるので、採用する前に最新の原文を確認してください。
補足です。
Python の標準ライブラリには Argon2id と bcrypt がありませんが、PBKDF2(hashlib.pbkdf2_hmac)と scrypt(hashlib.scrypt)は入っています。次の章ではまず追加のインストールなしで動く PBKDF2 で、仕組みを確かめます。
照合するには、ハッシュ値だけでなく「どの方式で・何回計算したか・どのソルトを使ったか」も必要です。そこで、これらを $ で区切って 1 つの文字列にし、データベースの 1 つの列に入れます。
pbkdf2_sha256$600000$(ソルトの Base64)$(ハッシュ値の Base64)方式と回数を一緒に保存しておくと、将来回数を上げたり方式を変えたりしても、古い形式の値を見分けて照合できます。OWASP も、方式とワークファクターをパスワードと一緒に標準的な形式(たとえば PHC 文字列形式)で保存しておくと、移行が楽になると書いています。後で紹介する Argon2id のライブラリが出力する $argon2id$v=19$m=... がその形式です。
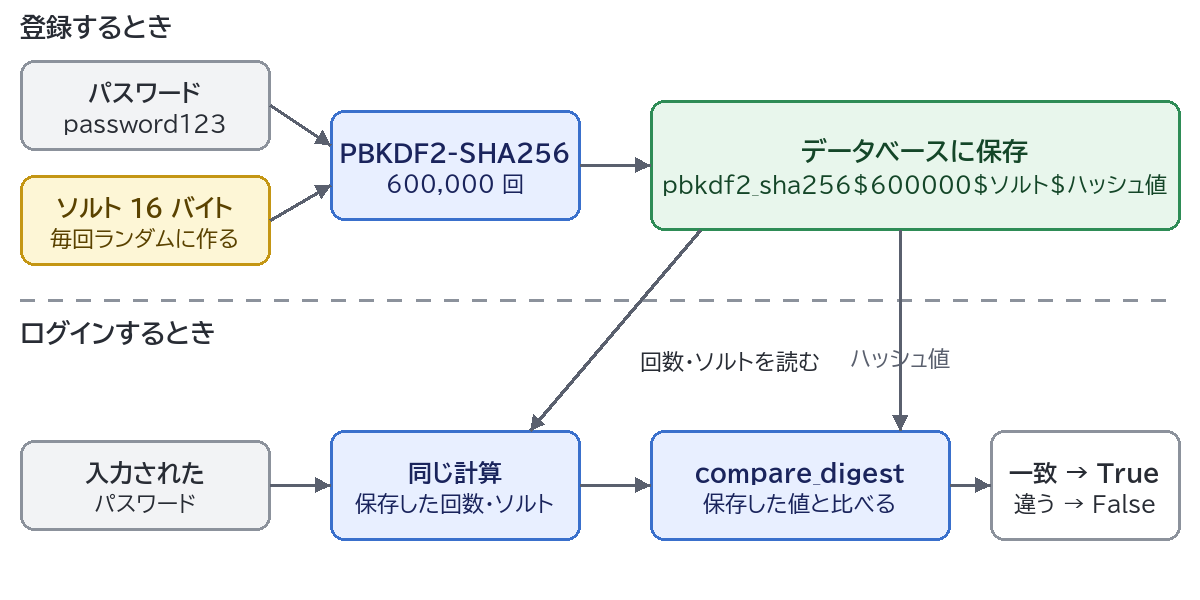
次の内容を pw_pbkdf2.py として保存します。
import base64
import hashlib
import hmac
import secrets

ALGORITHM = "pbkdf2_sha256"
ITERATIONS = 600_000      # OWASP の推奨値(2026 年 10 月 18 日に確認)
SALT_BYTES = 16
MAX_PASSWORD_BYTES = 1024  # 極端に長い入力で処理が重くならないように


def _b64(data: bytes) -> str:
    return base64.b64encode(data).decode("ascii")


def hash_password(password: str, iterations: int = ITERATIONS) -> str:
    pw = password.encode("utf-8")
    if len(pw) > MAX_PASSWORD_BYTES:
        raise ValueError("password is too long")
    salt = secrets.token_bytes(SALT_BYTES)  # ユーザーごとに新しいソルト
    dk = hashlib.pbkdf2_hmac("sha256", pw, salt, iterations)
    return f"{ALGORITHM}${iterations}${_b64(salt)}${_b64(dk)}"


def verify_password(password: str, stored: str) -> bool:
    pw = password.encode("utf-8")
    if len(pw) > MAX_PASSWORD_BYTES:
        return False
    try:
        algorithm, iterations, salt_b64, hash_b64 = stored.split("$")
        iterations = int(iterations)
        salt = base64.b64decode(salt_b64, validate=True)
        expected = base64.b64decode(hash_b64, validate=True)
    except ValueError:
        return False
    if algorithm != ALGORITHM or iterations < 1:
        return False
    dk = hashlib.pbkdf2_hmac("sha256", pw, salt, iterations)
    return hmac.compare_digest(dk, expected)


def needs_rehash(stored: str) -> bool:
    algorithm, iterations = stored.split("$")[:2]
    return algorithm != ALGORITHM or int(iterations) < ITERATIONS


if __name__ == "__main__":
    h1 = hash_password("password123")
    h2 = hash_password("password123")
    print(h1)
    print(h2)
    print("正しいパスワード:", verify_password("password123", h1))
    print("1 文字違い     :", verify_password("Password123", h1))
    print("作り直しが必要 :", needs_rehash(h1))

    old = hash_password("password123", iterations=100_000)  # 昔の設定で作った値
    print(old)
    print("作り直しが必要 :", needs_rehash(old))
保存したフォルダーで PowerShell から実行します。
py pw_pbkdf2.pyこの PC(Windows 11、Python 3.12.6)での結果です。ソルトは毎回ランダムなので値は毎回変わります。
pbkdf2_sha256$600000$9RZS13jTPs2HjmuIK27Qlw==$553hIriTFbs9xMqWWN/8gSg+vOVMGmHrKZTp9a5J8tw=
pbkdf2_sha256$600000$33+QlupptTzNnppghAJ+nQ==$qOoezVmCyhSW2CYj+D7IRHh2UKcoiMKY+AtaC71l/cw=
正しいパスワード: True
1 文字違い     : False
作り直しが必要 : False
pbkdf2_sha256$100000$hurWzSDIRRHcbKr7HSR5Bg==$9Msp++Qn/SD1I10oc0PlbEwWojGSmK56heNosJWMBf4=
作り直しが必要 : True
同じ「password123」でも 1 行目と 2 行目は違う値です。SHA-256 を 1 回使ったときと違い、同じパスワードの人を見分けられません。
secrets.token_bytes() で作る:random モジュールは予測できる乱数なので、セキュリティの用途には使いませんhmac.compare_digest() で行う:== は最初に違うバイトが見つかった時点で比較をやめるため、かかった時間から情報が漏れるおそれがあります。compare_digest() はそうした時間の差が出にくいように作られた比較関数です保存済みの値から元のパスワードは分からないので、回数を上げた値をサーバーだけで作り直すことはできません。OWASP が紹介している一般的な方法は、次にそのユーザーがログインしたときに作り直すことです。
verify_password() で照合するneeds_rehash() で古い設定かどうかを調べるhash_password() を呼び、新しい値でデータベースを更新する実行結果の最後の 2 行が、古い設定の値を見分けた例です。MD5 などからの移行方法は OWASP の同じページの「Upgrading Legacy Hashes」にあります。
scrypt も標準ライブラリで使えます。OWASP の設定例「N=2^17、r=8、p=1」は約 128 MiB のメモリを使います。ところが hashlib.scrypt のメモリ上限(maxmem)を省略すると OpenSSL の既定値(ドキュメントによると 32 MiB)になるため、この PC では次のエラーになりました。
ValueError [digital envelope routines] memory limit exceededちょうど 128 MiB を指定しても同じエラーだったので、下のコードでは 256 MiB にしています。
import base64
import hashlib
import hmac
import secrets

N, R, P = 2**17, 8, 1           # OWASP の設定例(2026 年 10 月 18 日に確認)
MAXMEM = 256 * 1024 * 1024      # 128 MiB を使うので上限を広げる
DKLEN = 32


def hash_password(password: str) -> str:
    salt = secrets.token_bytes(16)
    dk = hashlib.scrypt(password.encode("utf-8"), salt=salt,
                        n=N, r=R, p=P, maxmem=MAXMEM, dklen=DKLEN)
    salt_b64 = base64.b64encode(salt).decode("ascii")
    dk_b64 = base64.b64encode(dk).decode("ascii")
    return f"scrypt${N}${R}${P}${salt_b64}${dk_b64}"


def verify_password(password: str, stored: str) -> bool:
    algorithm, n, r, p, salt_b64, hash_b64 = stored.split("$")
    if algorithm != "scrypt":
        return False
    expected = base64.b64decode(hash_b64)
    dk = hashlib.scrypt(password.encode("utf-8"), salt=base64.b64decode(salt_b64),
                        n=int(n), r=int(r), p=int(p), maxmem=MAXMEM,
                        dklen=len(expected))
    return hmac.compare_digest(dk, expected)


if __name__ == "__main__":
    h = hash_password("password123")
    print(h)
    print(verify_password("password123", h))
    print(verify_password("password124", h))
この PC での結果です(ソルトは毎回変わります)。
scrypt$131072$8$1$VtiQ9Ko1rBFOFKpGtGN0IA==$dGPOGjoGfi/V3CF7r6ox40zfpKHKmMuVhytK3JYvWAY=
True
False
この設定は 1 回に 128 MiB を使うので、同時に 10 人がログインすると 1 GiB 以上必要です。サーバーのメモリに合わせて、OWASP の表のメモリを減らして p を増やす設定も検討します。
「計算を遅くする」とはどの程度なのかを、次のコードで測りました。それぞれ 5 回測った中央値を表示します。
import hashlib
import time

password = b"password123"
salt = b"0123456789abcdef"


def measure(label, func, count):
    times = []
    for _ in range(5):
        start = time.perf_counter()
        for _ in range(count):
            func()
        times.append((time.perf_counter() - start) / count)
    times.sort()
    sec = times[2]  # 5 回の中央値
    print(f"{label:<28} 1 回 {sec * 1000:12.6f} ms   1 秒あたり {1 / sec:14,.0f} 回")


measure("SHA-256 1 回", lambda: hashlib.sha256(salt + password).digest(), 100_000)
measure("PBKDF2-SHA256 600,000 回",
        lambda: hashlib.pbkdf2_hmac("sha256", password, salt, 600_000), 1)
measure("scrypt N=2^17 r=8 p=1",
        lambda: hashlib.scrypt(password, salt=salt, n=2**17, r=8, p=1,
                               maxmem=256 * 1024 * 1024), 1)
この PC(Intel Core i7-13700F、Windows 11、Python 3.12.6、OpenSSL 3.0.15)での結果です。何度実行してもほぼ同じでした。
SHA-256 1 回                  1 回     0.000399 ms   1 秒あたり      2,508,221 回
PBKDF2-SHA256 600,000 回      1 回   164.142600 ms   1 秒あたり              6 回
scrypt N=2^17 r=8 p=1        1 回   289.534300 ms   1 秒あたり              3 回
SHA-256 を 1 回計算するのは約 0.0004 ミリ秒、PBKDF2(600,000 回)は約 164 ミリ秒で、約 41 万倍の差があります。ログインする本人にとって 0.16 秒の待ち時間はほとんど気になりませんが、候補を大量に試す側にとっては大きな違いです。
単純に計算すると、この PC の Python で 10 億個の候補を 1 つずつ試す場合、SHA-256 1 回なら約 400 秒(7 分弱)ですが、PBKDF2 では約 1.6 億秒(約 5 年)かかります。
ただし、この数字はあくまで「この PC・この方法で測った値」です。SHA-256 の時間には Python の関数呼び出しの手間も含まれていて、専用のプログラムや GPU(画像処理用の、並列計算が得意な装置)を使えば、どちらももっと速く計算できます。OWASP も、GPU やクラウドを使えば攻撃者の費用は比較的小さいと書いています。見てほしいのは絶対的な時間ではなく、何十万倍もの差がつくという点です。scrypt や Argon2id がメモリを多く使うのも、GPU のような並列計算で速くされにくくするためです。
OWASP が第一に勧める Argon2id を Python で使うには、外部のライブラリが必要です。代表的なのは argon2-cffi(PyPI のページ)と、bcrypt(PyPI のページ)です。2026 年 10 月 18 日に PyPI で確認した最新版は、argon2-cffi が 25.1.0、bcrypt が 5.0.0 でした。仮想環境(venv)を作って有効にしてから、次のコマンドでインストールします。仮想環境の作り方は「Pythonの仮想環境venvの使い方」を参照してください。
py -m pip install argon2-cffiargon2-cffi では、OWASP の最低限の設定(m=19456、t=2、p=1)を次のように指定できます。
from argon2 import PasswordHasher
from argon2.exceptions import VerifyMismatchError

ph = PasswordHasher(time_cost=2, memory_cost=19456, parallelism=1)

h = ph.hash("password123")
print(h)
print(ph.verify(h, "password123"))
try:
    ph.verify(h, "Password123")
except VerifyMismatchError:
    print("一致しない")
print(ph.check_needs_rehash(h))
仮想環境の Python 3.12 での結果です。
$argon2id$v=19$m=19456,t=2,p=1$OD9Wohz8YMdQRVZ68EIl4Q$pBq0/IsJ0bx1lUijf8ELRC2/+bvdLUdatvIfp2Qe90c
True
一致しない
False
出力された 1 つの文字列に、方式(argon2id)・バージョン・設定値・ソルト・ハッシュ値がすべて入っています。ソルトの生成や比較もライブラリが行うので、自分で書くのは「設定値を決めること」と「照合に失敗したときの処理」だけです。照合に失敗すると False を返すのではなく例外(VerifyMismatchError)が出る点に注意してください。この PC では、1 回のハッシュ計算は約 18 ミリ秒でした(1 回の計測)。
引数なしの PasswordHasher() の既定値は、この版では t=3、m=65536(64 MiB)、p=4 でした。設定を変えたときに check_needs_rehash() で古い値を見分け、ログイン時に作り直す流れは PBKDF2 と同じです。
bcrypt を使う場合は、bcrypt.hashpw(password, bcrypt.gensalt()) で保存用の値を作り、bcrypt.checkpw() で照合します。bcrypt 5.0.0 では、72 バイトを超えるパスワードを渡すと次のエラーになりました(以前の版では黙って切り捨てられていました)。
ValueError: password cannot be longer than 72 bytes, truncate manually if necessary (e.g. my_password[:72])この PC では、ワークファクター 10 で約 43 ミリ秒、既定の 12 で約 172 ミリ秒でした(各 1 回の計測)。新しく作るなら Argon2id を選びましょう。
Web フレームワークにパスワード保存の仕組みがあるなら、自分で書かずにそれを使い、設定値が OWASP の目安を満たすかを確認するのが確実です。
for 文で SHA-256 を重ねるような自作の方式は、検証された方式ではありません。PBKDF2 など、確立した方式とライブラリを使います大丈夫です。ソルトの役割は計算をユーザーごとに別々にさせることで、秘密にすることではありません。秘密の値が必要なら、それはペッパーの役割です。
600,000 回は 2026 年 10 月 18 日時点の OWASP の推奨値で、「これ以上」を目安にします。Python のドキュメントにも「2022 年時点では SHA-256 で数十万回が提案されている」と書かれています。コンピューターの性能が上がると推奨値も上がっていくので、ときどき見直し、上げたときはログイン時に作り直します。
いいえ。計算を遅くしても、「123456」のようによく使われるパスワードは、候補の最初のほうで試されてしまいます。保存方法の工夫は「漏れたときに突き止めるまでの時間を延ばす」もので、弱いパスワードを強くするものではありません。新規登録のときに短すぎるパスワードやよく使われるパスワードを断る、多要素認証を用意するなど、別の対策と組み合わせます。
パスワードは、平文・暗号化・SHA-256 の 1 回ではなく、ソルトとストレッチングを組み込んだ専用の方式(第一候補は Argon2id)で保存します。方式・設定値・ソルト・ハッシュ値を 1 つの文字列にまとめて保存し、照合には hmac.compare_digest() のような比較関数を使い、設定を上げたときはログイン時に作り直します。設定値は OWASP の最新の原文と、自分のサーバーでの実測で決めましょう。