Pythonの例外処理入門|try・except・finally・raiseの使い方
hr
ENG LIFE BLOG
ダウンロードしたファイルが壊れていないか確かめたい、同じ中身のファイルを探したい、データが途中で書き換えられていないか調べたい。こうしたときに使うのが「ハッシュ値」です。Python では標準ライブラリの hashlib を使うと、追加のインストールなしで SHA-256 などのハッシュ値を計算できます。
この記事のコードと出力は、Windows 11 の Python 3.12 で実際に実行して確かめたものです。ハッシュ値は同じ入力なら必ず同じになるので、同じコードを実行すれば同じ値が出ます。
この記事で分かること:
hashlib.sha256(b"...").hexdigest() の基本と、文字列を encode() しないと出るエラーhashlib.file_digest()hmac の使い方ハッシュ値は、データを「ハッシュ関数」という決まった計算にかけて得られる、決まった長さの値です。データの「指紋」のようなもので、中身が同じなら必ず同じ値になり、中身が少しでも違えばまったく違う値になります。
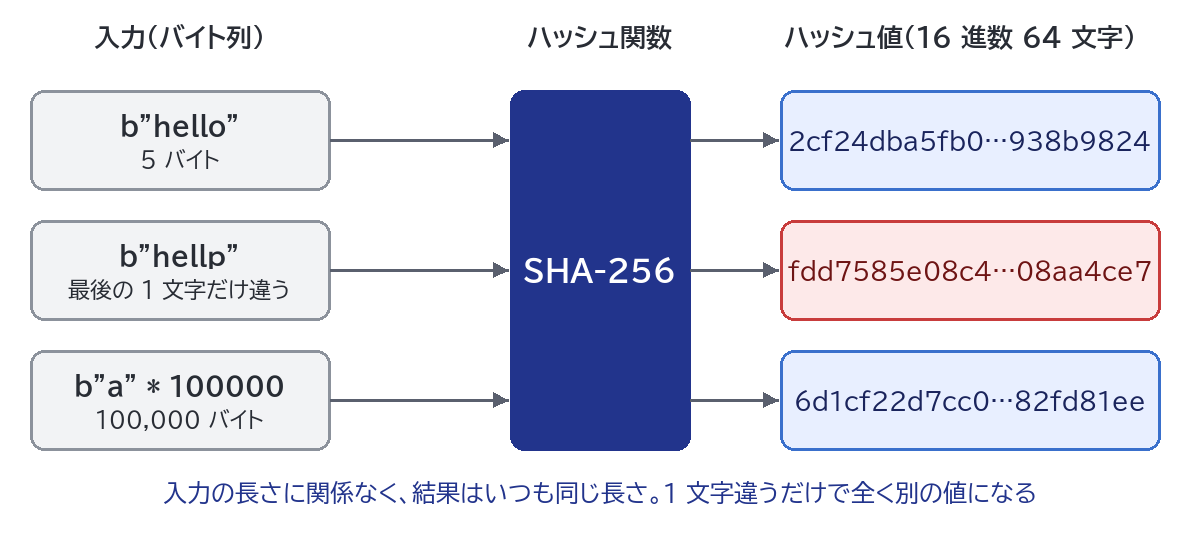
図 1 の値は、次の節のコードで実際に計算したものです。ハッシュ値には次の性質があります。
| 性質 | 意味 | 使い道 |
|---|---|---|
| 同じ入力なら同じ値 | いつ・どのパソコンで計算しても同じになる | ファイルの照合、重複の検出 |
| 長さが決まっている | SHA-256 なら入力が 0 バイトでも 1GB でも 32 バイト(16 進数で 64 文字) | 大きなデータを短い値で見比べられる |
| 少しの違いで全く別の値 | 1 ビット違うだけで、似ても似つかない値になる | 改ざん・破損の検出 |
| 元に戻せない | ハッシュ値から元のデータを計算で求めることはできない | 中身を見せずに同じかどうかだけ確かめる |
暗号化(鍵があれば元に戻せる)や Base64(誰でも元に戻せる)とは違い、ハッシュは一方通行の計算です。違いは「Base64とは?」でも説明しています。
いちばん基本の形です。b"hello" の b は「バイト列(bytes)」を表します。
import hashlib

print(hashlib.sha256(b"hello").hexdigest())
print(hashlib.sha256(b"hellp").hexdigest())
print(hashlib.sha256(b"Hello").hexdigest())
print(hashlib.sha256(b"a" * 100000).hexdigest())
print(len(hashlib.sha256(b"hello").hexdigest()))
実行結果です。最後の 1 文字や、先頭の大文字・小文字が違うだけで、値はまったく別になりました。100,000 バイトの入力でも長さは 64 文字のままです。
2cf24dba5fb0a30e26e83b2ac5b9e29e1b161e5c1fa7425e73043362938b9824
fdd7585e08c4e2afd71dcabdb4636c89d557a3f42db9e2040c8bbd1708aa4ce7
185f8db32271fe25f561a6fc938b2e264306ec304eda518007d1764826381969
6d1cf22d7cc09b085dfc25ee1a1f3ae0265804c607bc2074ad253bcc82fd81ee
64
hexdigest() はハッシュ値を 16 進数の文字列で返します。digest() にすると 32 バイトの bytes のまま返ります。見比べる用途には hexdigest() を使います。
hashlib.md5()・hashlib.sha1() のように関数を変えると、ほかのアルゴリズム(計算方法)で計算できます。名前を文字列で指定したいときは hashlib.new("sha256", b"hello") と書きます。b"hello" の結果は、MD5 が 5d41402abc4b2a76b9719d911017c592、SHA-1 が aaf4c61ddcc5e8a2dabede0f3b482cd9aea9434d でした。
| アルゴリズム | 長さ(16 進数) | 安全性 |
|---|---|---|
| MD5 | 32 文字(16 バイト) | 衝突(別のデータで同じ値)を作る方法が知られている |
| SHA-1 | 40 文字(20 バイト) | 同上。新しく使わない |
| SHA-256 | 64 文字(32 バイト) | 現在の標準的な選択 |
| SHA-512 | 128 文字(64 バイト) | 安全。値が長い |
使えるアルゴリズムの一覧は hashlib.algorithms_guaranteed で確かめられます。迷ったら SHA-256 を選びましょう。
ハッシュ関数が計算するのは「文字」ではなく「バイト列」です。str をそのまま渡すと、次のエラーになります。
import hashlib

print(hashlib.sha256("hello").hexdigest())
print(hashlib.sha256("hello").hexdigest())
^^^^^^^^^^^^^^^^^^^^^^^
TypeError: Strings must be encoded before hashing「文字列はハッシュ化する前にエンコードしなければならない」という意味です。encode("utf-8") でバイト列に変えてから渡します。
import hashlib

text = "hello"
print(hashlib.sha256(text.encode("utf-8")).hexdigest())
結果は b"hello" と同じ 2cf24dba…938b9824 になります。encode() は引数を省略しても UTF-8 になりますが、どの文字コードで計算したかを読む人に伝えるため、書いておくのがおすすめです。
画面上で同じに見える文字でも、文字コードや改行コードが違えばバイト列が違い、ハッシュ値も変わります。「ほかのツールと値が合わない」ときの多くはこれが原因です。
import hashlib

s = "こんにちは"
for enc in ["utf-8", "shift_jis"]:
    data = s.encode(enc)
    print(enc, len(data), hashlib.sha256(data).hexdigest())

for data in [b"hello\n", b"hello\r\n"]:
    print(data, len(data), hashlib.sha256(data).hexdigest())
utf-8 15 125aeadf27b0459b8760c13a3d80912dfa8a81a68261906f60d87f4a0268646c
shift_jis 10 58f4daa97f82ff3d1e2ddf6f1b750f5c4511fa1e7aea6340c4990ae0eac3974e
b'hello\n' 6 5891b5b522d5df086d0ff0b110fbd9d21bb4fc7163af34d08286a2e846f6be03
b'hello\r\n' 7 cd2eca3535741f27a8ae40c31b0c41d4057a7a7b912b33b9aed86485d1c84676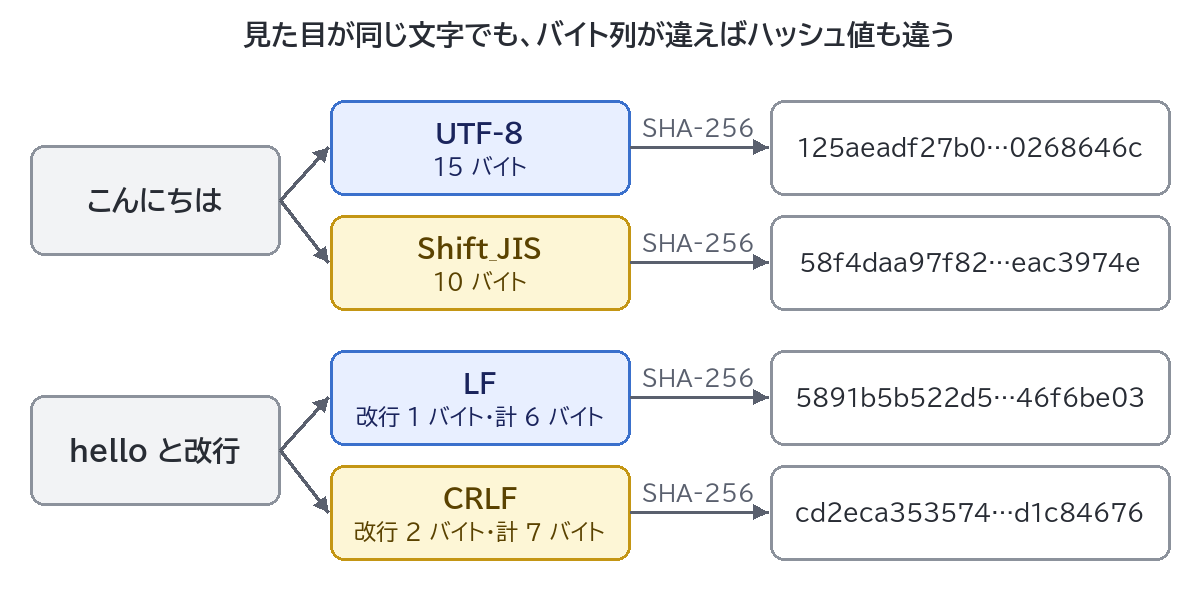
「こんにちは」は UTF-8 では 1 文字 3 バイトで 15 バイト、Shift_JIS では 1 文字 2 バイトで 10 バイトです。改行は LF(\n)が 1 バイト、Windows でよく使う CRLF(\r\n)が 2 バイトです。文字コードの違いは「文字コードとは?」、改行コードは「改行コードCRLFとLFの違い」で詳しく説明しています。
気づきにくい落とし穴が 2 つあります。
echo hello | sha256sum とすると「hello と LF」の値(5891b5b5…)になり、Python の b"hello" とは合いません。改行を付けない printf 'hello' | sha256sum なら 2cf24dba… で一致しましたopen("default.txt", "w", encoding="utf-8") で "hello\n" を書いたファイルは 7 バイトになり、ハッシュ値は CRLF の値(cd2eca35…)になりました。LF のまま書きたいときは newline="\n" を付けます(詳しくは「Pythonのファイル読み書き」)テキストのハッシュ値を手早く確かめたいときは「ハッシュ生成ツール」も使えます。文字コードは UTF-8 で、改行コードを LF と CRLF から選べるので、上の違いをブラウザ上で試せます。
ハッシュ値は、データを一度に渡さなくても計算できます。hashlib.sha256() で空の「ハッシュオブジェクト」を作り、update() で何回かに分けて渡します。
import hashlib

h = hashlib.sha256()
h.update(b"hel")
h.update(b"lo")
print(h.hexdigest())
結果は 2cf24dba…938b9824 で、b"hello" を一度に渡したときと同じです。公式ドキュメントにも「m.update(a); m.update(b) is equivalent to m.update(a+b)」(つなげて 1 回渡すのと同じ)と書かれています。この性質を使うと、メモリに入りきらない大きなファイルも計算できます。
ファイルは必ずバイナリモード("rb")で開きます。テキストモードで開くと文字列(str)として読まれ、改行コードの変換も入るため、正しいハッシュ値になりません。
1MiB(1,048,576 バイト)ずつ読み、update() に渡していく関数です。どの Python 3.8 以降でも動きます(:= は 3.8 からの書き方です)。filehash.py として保存します。
import hashlib
import sys


def sha256_of_file(path, chunk_size=1024 * 1024):
    h = hashlib.sha256()
    with open(path, "rb") as f:
        while chunk := f.read(chunk_size):
            h.update(chunk)
    return h.hexdigest()


print(sha256_of_file(sys.argv[1]))
py filehash.py ファイル名 で実行するとハッシュ値を表示します。f.read(chunk_size) は、ファイルの終わりに来ると空の b"" を返します。空のバイト列は偽として扱われるので、そこで while が終わります。
Python 3.11 で hashlib.file_digest() が追加され、同じことが 1 行で書けるようになりました。
import hashlib
import sys

with open(sys.argv[1], "rb") as f:
    digest = hashlib.file_digest(f, "sha256")
print(digest.hexdigest())
公式ドキュメントでは、1 つ目の引数は「バイナリモードで読み込み用に開いたファイルオブジェクト」でなければならず、閉じるのは呼び出した側の責任とされています。上のように with で開けば自動で閉じられます。テキストモードで開いたファイルを渡すと、次のエラーになりました。
ValueError: '<_io.TextIOWrapper name='lf.txt' mode='r' encoding='utf-8'>' is not a file-like object in binary reading mode.hashlib.sha256(f.read()) と一度に読んでも値は同じですが、ファイルの大きさと同じだけメモリを使います。200MiB のファイルで 3 つの方法を比べました(tracemalloc で測った、Python が確保したメモリの最大値。2 回実行してほぼ同じ結果)。
| 方法 | 時間 | メモリの最大値 |
|---|---|---|
sha256(f.read())(一度に読む) | 0.15〜0.16 秒 | 200.0 MiB |
sha256_of_file()(1MiB ずつ) | 0.15〜0.16 秒 | 2.0 MiB |
file_digest() | 0.12 秒 | 0.3 MiB |
3 つとも同じハッシュ値(a1cdeea4…)になりました。数 GB のファイルを一度に読むとメモリが足りなくなることがあるので、ファイルは少しずつ読む方法か file_digest() を使いましょう。時間はこの PC での値で、ディスクの速さによって変わります。
ソフトウェアの配布サイトには、ファイルと一緒に「SHA256: 〜」のようなハッシュ値が書かれていることがあります。手元で計算した値と一致すれば、ダウンロードの途中で壊れたり、すり替えられたりしていないと確かめられます。ここでは手元で作ったファイルを配布物に見立てて試します。
make_sample.py として保存します。1MiB の練習用ファイル sample-1.0.bin を作るコードです。data = bytes(range(256)) * 4096
with open("sample-1.0.bin", "wb") as f:
f.write(data)
print(len(data), "バイト書き込みました")py make_sample.pyverify.py として保存します。1 つ目の引数にファイル、2 つ目に公開されているハッシュ値を受け取ります。import hashlib
import hmac
import sys
def sha256_of_file(path, chunk_size=1024 * 1024):
h = hashlib.sha256()
with open(path, "rb") as f:
while chunk := f.read(chunk_size):
h.update(chunk)
return h.hexdigest()
path = sys.argv[1]
expected = sys.argv[2].strip().lower()
actual = sha256_of_file(path)
print("計算した値:", actual)
print("公開された値:", expected)
if hmac.compare_digest(actual, expected):
print("一致しました")
else:
print("一致しません。ファイルを使わないでください")py verify.py sample-1.0.bin fbbab289f7f94b25736c58be46a994c441fd02552cc6022352e3d86d2fab7c83計算した値: fbbab289f7f94b25736c58be46a994c441fd02552cc6022352e3d86d2fab7c83
公開された値: fbbab289f7f94b25736c58be46a994c441fd02552cc6022352e3d86d2fab7c83
一致しました配布サイトの値が英大文字(FBBAB289…)で書かれていても、.lower() で小文字にそろえているので「一致しました」になりました。前後の空白は .strip() で取り除いています。
次に、ファイルの 1,001 バイト目の 1 ビットだけを書き換えたコピー(tampered.bin)で試すと、値がまったく変わり、不一致になりました。
計算した値: 18b9c06a372a31e89a5074c5d5a2c7de9bfe5f63b6eb2f73ea8245e09b404b13
公開された値: fbbab289f7f94b25736c58be46a994c441fd02552cc6022352e3d86d2fab7c83
一致しません。ファイルを使わないでください
ただし、配布サイトそのものが乗っ取られるとファイルとハッシュ値の両方を書き換えられます。照合で分かるのは「公開されている値と同じファイルか」までなので、値は公式サイトの HTTPS のページで確認しましょう。
Python で計算した値は、OS のコマンドで計算した値と同じになります。上で作った sample-1.0.bin で確かめました。
PowerShell(5.1)の Get-FileHash:
(Get-FileHash -Algorithm SHA256 .\sample-1.0.bin).HashFBBAB289F7F94B25736C58BE46A994C441FD02552CC6022352E3D86D2FAB7C83コマンドプロンプトの certutil(最後の SHA256 を省くと SHA-1 で計算されます):
certutil -hashfile sample-1.0.bin SHA256SHA256 ハッシュ (対象 sample-1.0.bin):
fbbab289f7f94b25736c58be46a994c441fd02552cc6022352e3d86d2fab7c83
CertUtil: -hashfile コマンドは正常に完了しました。Git Bash の sha256sum(GNU coreutils 8.32):
sha256sum sample-1.0.binfbbab289f7f94b25736c58be46a994c441fd02552cc6022352e3d86d2fab7c83 *sample-1.0.bin3 つとも Python で計算した値と同じです。Get-FileHash だけ英大文字ですが、16 進数の大文字・小文字は同じ値を表します。ただし Python の == は大文字と小文字を区別するので、比べる前にどちらかにそろえます。各コマンドの開き方や表示の読み方は「ハッシュ生成ツール」のページで画面の手順つきで説明しています。
hashlib の公式ドキュメントには「Some algorithms have known hash collision weaknesses (including MD5 and SHA1).」(MD5 や SHA1 を含む一部のアルゴリズムには、衝突に関する既知の弱点がある)と書かれています。衝突とは、違うデータなのに同じハッシュ値になることです。攻撃者が衝突を作れると、「ハッシュ値が一致したから本物」という確認が成り立たなくなります。
そのため、改ざんの検出など安全に関わる用途では SHA-256 以上を使います。古いシステムとの互換のために MD5 の値が必要なときや、安全とは関係のない用途(キャッシュのキーなど)に使うときは、Python 3.9 からある usedforsecurity=False を付けて、その意図をコードに残せます。
import hashlib

print(hashlib.md5(b"hello", usedforsecurity=False).hexdigest())
結果は通常の MD5 と同じ 5d41402abc4b2a76b9719d911017c592 です。公式ドキュメントによると、False は「安全のための用途ではない」ことを示し、制限された環境でブロックされている安全でないアルゴリズムも使えるようにするものです。安全性が上がるわけではありません。
ふつうのハッシュ値は誰でも計算できるので、データとハッシュ値を一緒に書き換えられると改ざんに気づけません。送る側と受け取る側だけが知っている「鍵」を混ぜて計算するのが HMAC です。Web サービスの通知(Webhook)が本物かどうかを確かめる仕組みなどで使われます。
import hashlib
import hmac

key = b"my-secret-key"
msg = b'{"order_id": 123, "amount": 5000}'

sig = hmac.new(key, msg, digestmod=hashlib.sha256).hexdigest()
print(sig)
print(hmac.new(b"wrong-key", msg, digestmod=hashlib.sha256).hexdigest())

received = sig
print(hmac.compare_digest(sig, received))
1e1670f56a009ffdf5464505b6e2c8400ea0557ce608142d0744dd0f3bd68b4b
5fb0b9c24db1c1ab44d9e1c6a341ad6f654427832f6ad405e99793d70cae1f5d
True同じメッセージでも鍵が違えば別の値になるので、鍵を知らない人は正しい値を作れません。ポイントは次の 3 つです。
digestmod は Python 3.8 から必須です。省くと TypeError: Missing required argument 'digestmod'. になりました== ではなく hmac.compare_digest() を使います。公式ドキュメントは、比較にかかる時間の差から情報を探る攻撃(タイミング攻撃)を減らすため、こちらを勧めていますcompare_digest() の 2 つの引数は同じ型(どちらも ASCII の str か、どちらも bytes)にします。str と bytes を混ぜると TypeError: a bytes-like object is required, not 'str' になりました。大文字・小文字も区別されます鍵は推測されない値にする必要があります。安全な鍵の作り方は「Pythonのrandomとsecretsの違い」を見てください。
hashlib.sha256(password.encode()).hexdigest() の値をデータベースに保存するのは危険です。SHA-256 は速く計算できるように作られているため、漏れたハッシュ値に対して、よく使われるパスワードを片っ端から試されるとすぐに見つかってしまいます。hashlib の公式ドキュメントにも、sha1(password) のような単純な方法は総当たりに強くなく、よいパスワードハッシュ関数は計算の重さを調整でき、遅く、ソルトを含むものだと書かれています。
ソルト・ストレッチングの意味や、hashlib.pbkdf2_hmac・Argon2id を使った保存と照合のコードは「パスワードの安全な保存方法」で詳しく説明しています。
| 症状 | 原因 | 直し方 |
|---|---|---|
TypeError: Strings must be encoded before hashing | str をそのまま渡した | .encode("utf-8") でバイト列にする |
| ほかのツールと値が合わない | 文字コード・改行コード・末尾の改行の有無が違う | どのバイト列を計算しているかをそろえる |
| Windows で作ったファイルだけ値が違う | テキストモードで書いて改行が CRLF になった | newline="\n" を付けるか、バイナリモードで書く |
ValueError: ... is not a file-like object in binary reading mode. | file_digest() にテキストモードのファイルを渡した | open(path, "rb") で開く |
同じ値なのに == が False | 英大文字の値(Get-FileHash など)と比べた | .lower() でそろえてから比べる |
| 大きなファイルでメモリ不足 | f.read() で一度に読んだ | 少しずつ読むか file_digest() を使う |
計算で元に戻すことはできません。ただし「hello」のような短く推測しやすいデータは、候補を片っ端からハッシュ化して同じ値を探せば見つかります。「ハッシュにしたから秘密が守られる」とは考えないでください。
SHA-256 などは計算方法が決まっているので、同じバイト列なら値は変わりません。この記事でも Python・PowerShell・certutil・sha256sum の値が一致しました。値が変わるのは、バイト列そのもの(文字コード・改行コードなど)が違うときです。
hashlib では hashlib.sha256(バイト列).hexdigest() でハッシュ値を計算します。文字列は encode("utf-8") してから渡し、ファイルは "rb" で開いて少しずつ読むか file_digest() を使います。値が合わないときは文字コードと改行コードを疑い、安全に関わる用途では SHA-256 以上と hmac.compare_digest() を使い、パスワードの保存には専用の方式を使いましょう。