Pythonのconfigparserの使い方|INIファイルの読み書きと型変換の落とし穴
hr
ENG LIFE BLOG
Python で乱数を作るとき、多くの入門書では random モジュールが出てきます。サイコロやくじ引きのプログラムならそれで十分ですが、パスワードやログイン用のトークン(合言葉のような文字列)を random で作ってはいけません。Python 公式のドキュメントにも、はっきりそう書かれています。
この記事では、random と secrets の違いを、Python 3.12 で実際に動かした結果と、公式ドキュメント(docs.python.org)の原文をもとに説明します。乱数の値は実行するたびに変わるので、記事に載せた値と同じにはなりません(seed を決めた例だけは同じ値になります)。
この記事で分かること:
random の基本(random()・randint()・choice()・sample()・shuffle())secrets でパスワード・再設定用のトークン・確認コードを作る方法と、compare_digest() での比べ方token_hex(16) が 32 文字になるといった、バイト数と文字数の関係random.SystemRandom と uuid.uuid4() がどんな乱数を使っているか先に使い分けをまとめます。迷ったら「その値を他人に当てられたら困るか」で考えます。困るなら secrets です。
| 用途 | 使うもの | 理由 |
|---|---|---|
| ゲーム・くじ引き・サンプルデータ作り | random | 当てられても困らない。速くて関数が多い |
| シミュレーション・テストで同じ結果を再現したい | random(seed を決める) | seed が同じなら同じ並びになる |
| パスワード・初期パスワードの発行 | secrets | 当てられると不正ログインにつながる |
| パスワード再設定 URL・API キー・セッション ID | secrets | 当てられると他人になりすませる |
| メールや SMS で送る確認コード | secrets | 当てられると本人確認を突破される |
| データの ID(主キーなど) | uuid.uuid4() など | 重ならないことが目的。後の節で説明 |
まずは random のよく使う関数を動かしてみます。次のコードを basic.py という名前で保存して実行します。
import random

print(random.random())
print(random.randint(1, 6))
print(random.choice(["グー", "チョキ", "パー"]))
print(random.sample(range(1, 11), 3))

cards = ["A", "B", "C", "D", "E"]
random.shuffle(cards)
print(cards)
py basic.pyPython 3.12 での実行例です(実行するたびに変わります)。
0.8418319694045058
3
チョキ
[3, 4, 10]
['E', 'C', 'A', 'D', 'B']| 関数 | 何をするか | 注意点 |
|---|---|---|
random() | 0.0 以上 1.0 未満の小数を返す | 1.0 ちょうどは出ない |
randint(a, b) | a 以上 b 以下の整数を返す | b も含む。randrange(1, 6) は 5 までなので混同しない |
choice(seq) | リストなどから 1 つ選ぶ | 空のリストだと IndexError |
sample(seq, k) | 重ならないように k 個選ぶ | k が要素数より多いと ValueError |
choices(seq, k=n) | 重なりを許して n 個選ぶ | 同じものが何度も出てよい |
shuffle(list) | リストそのものの順番を混ぜる | 戻り値は None。新しいリストは返さない |
randint(1, 6) と randrange(1, 6) を 1,000 回ずつ実行して出た値を集めると、前者は [1, 2, 3, 4, 5, 6]、後者は [1, 2, 3, 4, 5] でした。サイコロなら randint(1, 6) です。
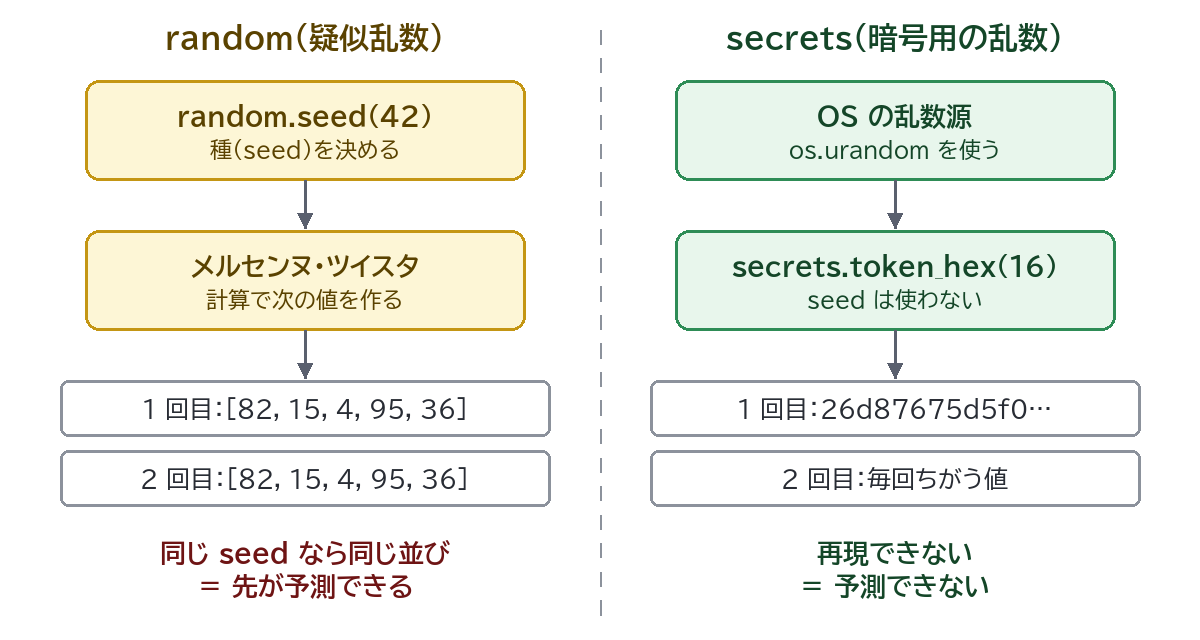
random が作る乱数は「疑似乱数」です。本当にでたらめな値ではなく、seed(種)と呼ばれる最初の値から、決まった計算で次々に値を作っています。Python が使っている計算方法はメルセンヌ・ツイスタ(Mersenne Twister)という方式で、公式ドキュメントにも「Python uses the Mersenne Twister as the core generator.」と書かれています。
計算で作っているので、seed が同じなら毎回同じ並びになります。次のコードで確かめます。
import random

random.seed(42)
print([random.randint(1, 100) for _ in range(5)])

random.seed(42)
print([random.randint(1, 100) for _ in range(5)])

random.seed(43)
print([random.randint(1, 100) for _ in range(5)])
Python 3.12 での結果です。このファイルを 2 回実行しても、2 回とも同じ結果になりました。
[82, 15, 4, 95, 36]
[82, 15, 4, 95, 36]
[5, 37, 90, 98, 19]
seed が 42 の 2 回はまったく同じ並びで、43 にすると別の並びになります。テストやシミュレーションで「前回と同じ条件でもう一度動かしたい」ときには、これがとても便利です。ただし、公式ドキュメントの「Notes on Reproducibility」には、アルゴリズムの多くは Python のバージョンで変わることがあり、変わらないと約束されているのは random() の並びなどに限られると書かれています。randint() の結果がほかのバージョンでも同じになるとは限りません。
random のドキュメントの冒頭には、次の警告が書かれています(2026 年 10 月 23 日に原文を確認)。
The pseudo-random generators of this module should not be used for security purposes. For security or cryptographic uses, see the secrets module.
訳すと「このモジュールの疑似乱数生成器は、セキュリティの目的に使うべきではない。セキュリティや暗号の用途には secrets モジュールを参照すること」です。理由は、前の節で見たとおり、計算で作っている値は、仕組みと状態が分かれば先を予測できるからです。
「seed を書かなければ毎回違う値になるから大丈夫」と思うかもしれません。たしかに random.seed() の説明には、seed を省略すると、OS が乱数源を用意していればそれを使い、なければ現在の時刻を使うと書かれています。しかし、seed が分からなくても安全にはなりません。
メルセンヌ・ツイスタは、内部に持っている状態(624 個の 32 ビットの数)から次の値を計算します。出力された値を十分な数だけ集めると、この内部状態を逆算できることが知られています。この PC の Python 3.12 でも、seed を指定していない random.Random() から 32 ビットの値を 624 個取り出し、それを元に作った複製が、元と同じ次の値(randint(1, 100) の 5 回分など)を出すことを確かめました。攻撃のためのコードになるので、ここには載せません。
つまり、random で作ったトークンをたくさん目にできる攻撃者は、次に発行されるトークンを当てられるおそれがあります。パスワード再設定の URL がこれで作られていたら、他人のアカウントを乗っ取られかねません。
secrets は Python 3.6 で追加された標準ライブラリです。ドキュメントには、random の疑似乱数ではなく secrets を使うべきだと書かれています(原文:「secrets should be used in preference to the default pseudo-random number generator in the random module, which is designed for modelling and simulation, not security or cryptography.」)。インストールは不要で、import secrets だけで使えます。
| 関数 | 返すもの | 例(実行するたびに変わる) |
|---|---|---|
token_bytes(n) | n バイトのランダムなバイト列 | b'\xc7\xa5v\x0e...' |
token_hex(n) | n バイトを 16 進数の文字列にしたもの(2n 文字) | 26d87675d5f01aa9e981a40dbb7d16c2 |
token_urlsafe(n) | n バイトを URL に使える Base64 の文字列にしたもの | VGx7_sRkV0FcsFqvOPMfiA |
choice(seq) | リストなどから 1 つ選ぶ | パスワードの 1 文字を選ぶ |
randbelow(n) | 0 以上 n 未満の整数 | 確認コードを作る |
randbits(k) | k ビットのランダムな整数 | ― |
compare_digest(a, b) | a と b が等しいか(True / False) | トークンの照合 |
英大文字・小文字・数字から 16 文字を選ぶ例です。secrets.choice() を 1 文字ずつ呼び出します。公式ドキュメントのレシピ(8 文字の例)と同じ書き方です。
import secrets
import string

alphabet = string.ascii_letters + string.digits
password = "".join(secrets.choice(alphabet) for _ in range(16))
print(password)実行すると、byQXDrBSKq7MiE2a のような 16 文字が表示されます。もう一度実行すると、まったく別の文字列になりました。記事に載っている値は誰でも見られるので、実際のパスワードには使わないでください。
「大文字・小文字・数字を必ず含む」といった条件があるときは、ドキュメントのレシピのように、条件を満たすまで作り直す(while True: で作り、条件を満たしたら break)方法が紹介されています。条件に合わせて特定の位置の文字を決め打ちすると、そのぶん当てやすくなるので避けます。
「パスワードを忘れた方」のメールに入れる URL には、推測できない長いトークンを付けます。URL に入れるので、token_urlsafe() が便利です。
import secrets

token = secrets.token_urlsafe(32)
print("https://example.com/reset?token=" + token)
実行例です(毎回変わります)。
https://example.com/reset?token=tGUP1n2qIMwkO25Oait4zW2H1ce62WhivzcyKhz52o4token_urlsafe() の文字列は、英大文字・小文字・数字と「-」「_」だけでできていて、末尾の「=」も取り除かれています(Python 3.12 のソースコードで base64.urlsafe_b64encode() の結果から「=」を除いていることを確認)。そのため URL にそのまま付けられます。ログイン状態を保つセッション ID も同じ作り方で、「Cookieとセッションの仕組みとは?」では secrets.token_urlsafe(32) を使っています。
メールで送る「123456」のような数字のコードは randbelow() で作り、:06d で 6 桁にそろえます。こうしないと、たとえば 86665 が出たときに 5 桁で表示されてしまいます。
import secrets

print(f"{secrets.randbelow(1_000_000):06d}")
実行例は 086665 でした(毎回変わります)。randbelow(1_000_000) は 0〜999999 のどれかを返します。6 桁の数字は 100 万通りしかないので、何度でも試せるようにすると当てられてしまいます。有効期限や試行回数の上限と組み合わせて使います。
送られてきたトークンが保存しておいた値と同じかを調べるときは、== ではなく secrets.compare_digest() を使います。ドキュメントでは「constant-time compare(一定時間の比較)」で、タイミング攻撃の危険を減らすと説明されています。タイミング攻撃とは、比べるのにかかった時間のわずかな差から「先頭の何文字まで合っていたか」を探る攻撃です。
import secrets

saved = "abc123"
print(secrets.compare_digest(saved, "abc123"))
print(secrets.compare_digest(saved, "abc124"))
print(secrets.compare_digest(saved.encode(), b"abc123"))
結果は次のとおりです。文字列どうし、バイト列どうしのどちらでも比べられます。
True
False
True
secrets.compare_digest は、中身としては hmac.compare_digest と同じものです(Python 3.12 の secrets.py に from hmac import compare_digest と書かれています)。パスワードのハッシュ値を照合するときにも使います。保存の仕方は「パスワードの安全な保存方法」で説明しています。
token_hex(16) の 16 は「文字数」ではなく「ランダムなバイト数」です。16 進数では 1 バイトが 2 文字になるので 32 文字になります。token_urlsafe() は Base64 なので、1 バイトがおよそ 1.3 文字(3 バイトが 4 文字)になります。次のコードで実際の長さを数えました。
import secrets

for n in (8, 16, 24, 32, 64):
    print(n, len(secrets.token_hex(n)), len(secrets.token_urlsafe(n)))
print("default", len(secrets.token_hex()), len(secrets.token_urlsafe()))
8 16 11
16 32 22
24 48 32
32 64 43
64 128 86
default 64 43| バイト数 n | ビット数 | token_hex(n) の文字数 | token_urlsafe(n) の文字数 |
|---|---|---|---|
| 8 | 64 | 16 | 11 |
| 16 | 128 | 32 | 22 |
| 24 | 192 | 48 | 32 |
| 32 | 256 | 64 | 43 |
| 64 | 512 | 128 | 86 |
同じ 32 バイトでも、16 進数なら 64 文字、Base64 なら 43 文字です。強さを決めるのは文字数ではなく、元のランダムなバイト数です。16 進数と Base64 の仕組みは「2進数・16進数の基本」と「Base64とは?」で説明しています。
secrets のドキュメントの「How many bytes should tokens use?」には、「As of 2015, it is believed that 32 bytes (256 bits) of randomness is sufficient for the typical use-case expected for the secrets module.」と書かれています。2015 年時点で、一般的な用途には 32 バイト(256 ビット)で十分と考えられている、という意味です。同じ節には、コンピューターが速くなるにつれて必要な量は増えるとも書かれています。
バイト数を省略したときの値は secrets.DEFAULT_ENTROPY で決まり、Python 3.12 では 32 でした(上の結果の default 行でも 64 文字と 43 文字)。ただしドキュメントには、この既定値はいつでも変わりうると書かれています。必要な長さが決まっているなら、token_urlsafe(32) のように数を書いておくと、Python を更新しても長さが変わらず安心です。
random モジュールの中にも、OS の乱数源を使う random.SystemRandom というクラスがあります。ドキュメントには、os.urandom() を使って OS の乱数源から値を作り、同じ並びは再現できないので seed() は無視されると書かれています。
import random

r = random.SystemRandom()
r.seed(42)
print([r.randint(1, 100) for _ in range(5)])
r.seed(42)
print([r.randint(1, 100) for _ in range(5)])
print(r.sample(["A", "B", "C", "D", "E"], 3))
[20, 59, 51, 68, 21]
[89, 50, 77, 47, 82]
['E', 'D', 'C']seed(42) を 2 回呼んでも、並びは別々になりました。os.urandom() のドキュメントによると、Windows では BCryptGenRandom()、Linux では使えるなら getrandom() システムコールを使います。
実は secrets は、この SystemRandom を使って作られています。Python 3.12 の secrets.py を開くと、_sysrand = SystemRandom() を作り、secrets.choice はその choice、token_bytes() はその randbytes() を呼んでいました。secrets には shuffle() や sample() がないので、安全な乱数で並べ替えたり複数選んだりしたいときは、上のように random.SystemRandom() を使います。
ランダムな ID としてよく使われる UUID(728653f9-36d9-41f2-a4f6-bebba27deaa1 のような 36 文字の値)も、Python の uuid.uuid4() で作れます。uuid のドキュメントでは、uuid4() は「Generate a random UUID in a cryptographically-secure method」(暗号的に安全な方法でランダムな UUID を作る)と説明されています。ドキュメントには乱数源の名前までは書かれていませんが、Python 3.12 のソースコードでは UUID(bytes=os.urandom(16), version=4) となっていて、os.urandom() の 16 バイトを使っていました。
import uuid

u = uuid.uuid4()
print(u)
print(u.version, len(str(u)))
728653f9-36d9-41f2-a4f6-bebba27deaa1
4 3616 バイトのうち、バージョン(4)などを表す数ビットは決まった値に置き換えられるので、すべてがランダムなわけではありません。UUID は「ほかと重ならない ID」を作るための形式です。秘密のトークンが必要なら、目的に合わせて長さを選べる secrets.token_urlsafe() などを使うほうが意図がはっきりします。なお、uuid1() はコンピューターのネットワークアドレスを含むため、プライバシーを損なうおそれがあるとドキュメントに書かれています。
UUID をブラウザですぐに作りたいときは「UUID生成ツール」が使えます。v4 と v7 を最大 1000 個まとめて作れて、データはブラウザの外に送りません。
前の節のとおり、引数はバイト数なので 32 文字になります。「16 文字のトークンが欲しい」なら token_hex(8) ですが、ランダムな部分は 8 バイト(64 ビット)しかありません。文字数を減らしたいなら、バイト数を減らすより token_urlsafe() に替えるほうが強さを保てます(32 バイトで 64 文字 → 43 文字)。
secrets には shuffle() がありません。呼ぶと次のエラーになります。
AttributeError: module 'secrets' has no attribute 'shuffle'random.SystemRandom().shuffle(リスト) を使います。random.shuffle() と同じく、戻り値は None でリストそのものが並べ替わります。cards = random.shuffle(cards) と書くと cards が None になってしまうので注意します。
文字列とバイト列を混ぜて比べたり、日本語などの ASCII 以外の文字を含む文字列を比べたりすると、エラーになります。Python 3.12 での表示です。
secrets.compare_digest("abc", b"abc")
TypeError: a bytes-like object is required, not 'str'

secrets.compare_digest("あ", "あ")
TypeError: comparing strings with non-ASCII characters is not supported
ASCII 以外の文字を含む可能性があるときは、両方を .encode("utf-8") でバイト列にしてから比べます。
テストのために random.seed(42) と書いたまま本番に出すと、プログラムを起動するたびに同じ並びになります。これがくじ引きなら当選者を毎回当てられてしまいます。seed を固定するのはテストの中だけにします。なお secrets には seed がないので、この間違いは起きません。
"".join(random.choices(alphabet, k=16)) は短く書けるので、ネットの例でよく見かけます。しかし中身は random の疑似乱数なので、パスワードには向きません。前の節の secrets.choice() を使う書き方にします。
OS から値を取り寄せるぶんの手間はかかりますが、パスワードやトークンを 1 つ作るくらいなら気になる差ではありません。大量の乱数で計算するシミュレーションは、もともと random の用途です。速さで選ぶのではなく、「当てられたら困るか」で選びます。
いいえ。secrets のドキュメントのレシピにも、パスワードは元に戻せる形で保存せず、ソルトを付けて強い一方向ハッシュで保存するよう書かれています。乱数をどう作るかと、どう保存するかは別の話です。保存方法は「パスワードの安全な保存方法」を見てください。
API キーなどとして長く使う値を作ったなら、コードには書かず環境変数や .env ファイルで渡します。Git に上げてしまうと、どんなに安全な乱数で作っても意味がなくなります。やり方は「.envと環境変数で秘密情報を守る」で説明しています。
なりません。SHA-256 などのハッシュは、同じ入力からは必ず同じ値になります。時刻やユーザー名をハッシュ化してトークンにすると、入力が推測できれば同じ値を計算されてしまいます。ハッシュ値がどう決まるかは「ハッシュ生成ツール」で同じ文字を何度か入れてみると確かめられます。
random は seed から計算で値を作る疑似乱数で、再現できるのが長所ですが、そのぶん先を予測できます。パスワード・トークン・確認コードなど、当てられたら困る値は secrets(または random.SystemRandom)で作り、長さは 32 バイトを目安に数を書いて指定し、照合には compare_digest() を使いましょう。