Pythonのcollections入門|Counter・defaultdict・deque
hr
ENG LIFE BLOG
自分で作ったクラスを print したら <__main__.Point object at 0x...> と出た、中身が同じなのに == が False になった、set に入れたら TypeError: unhashable type になった――どれも、__str__・__repr__・__eq__ のような特殊メソッドを書くと解決できます。
この記事では、特殊メソッドの仕組みと、表示(__str__・__repr__)、比較(__eq__・__hash__・__lt__)、リストのように使えるクラス(__len__・__getitem__・__iter__・__contains__)、__add__ と NotImplemented、__bool__ を順に説明します。仕様は Python 公式ドキュメントの「データモデル」の章(3.3 特殊メソッド名)で確認し、出力は Windows 11・Python 3.12.6 で実際に実行したものです。クラスと self の基本は「Pythonのクラスの基本」をどうぞ。
特殊メソッドは、名前の前後にアンダースコアが 2 つずつ付いたメソッドです。アンダースコア 2 つ(double underscore)を略してダンダー(dunder)メソッドとも呼ばれます。いちばん身近なのは、インスタンスを作るときに呼ばれる __init__ です。
特殊メソッドは、ふつうは自分で呼びません。len(x) や a + b のような組み込みの書き方をすると、Python が裏で呼んでくれます。リストで確かめます。次のコードを sample.py という名前で保存します。
x = [3, 1, 2]
print(len(x), x.__len__())
print(x[0], x.__getitem__(0))
print(2 in x, x.__contains__(2))
print(1 + 2, (1).__add__(2))
PowerShell で、sample.py を保存したフォルダーに移動してから実行します(この記事のほかのコードも、同じように保存して実行できます)。
py sample.py3 3
3 3
True True
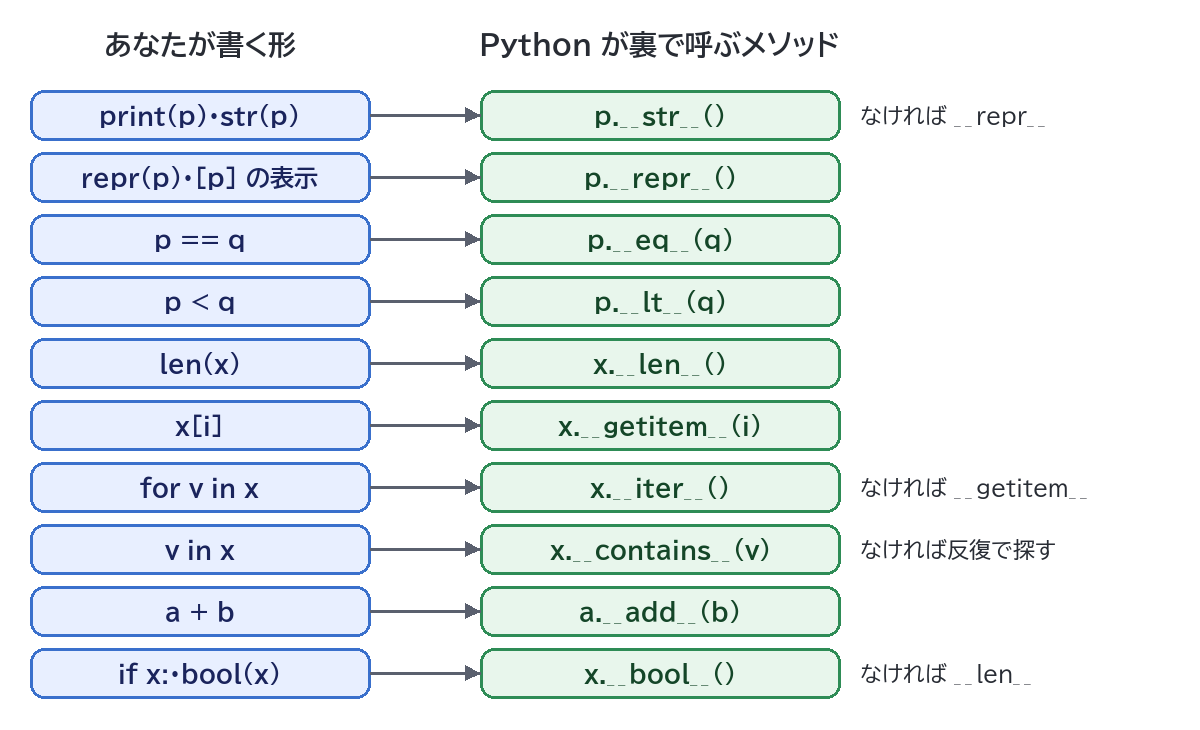
3 3左右が同じ結果になりました。len(x) は裏で x.__len__() を呼んでいるわけです。公式ドキュメントでは、これを Python の演算子オーバーロード(演算子の意味を型ごとに決めること)の方法と説明しています。自分のクラスに同じ名前のメソッドを書けば、len() や + を自分のクラスでも使えるわけです。この記事で扱う対応は次の図のとおりです。
座標を表す Point クラスを作って print してみます。
class Point:
    def __init__(self, x, y):
        self.x = x
        self.y = y

p = Point(1, 2)
print(p)
print(repr(p))
print([p])
<__main__.Point object at 0x0000027B490D7020>
<__main__.Point object at 0x0000027B490D7020>
[<__main__.Point object at 0x0000027B490D7020>]「__main__ モジュールの Point クラスのオブジェクト」という意味で、0x の後ろは実行のたびに変わる識別用の数字です。x と y の値が見えないので、デバッグのときに困ります。Python がこのクラスを「どう文字にすればよいか」を知らないためです。
文字にする方法を決める特殊メソッドは 2 つあります。
__repr__ … 開発者向けの「公式の」文字列。repr() で呼ばれます。公式ドキュメントでは、できれば同じ値のオブジェクトを作り直せる Python の式のような形にするべきだ、とされています__str__ … 人が読むための「非公式の」文字列。str()・print()・format()(f 文字列の {p} も同じ)で呼ばれます。Python の式の形でなくてよく、見やすさを優先できますclass Point:
def __init__(self, x, y):
self.x = x
self.y = y
def __repr__(self):
return f"Point({self.x!r}, {self.y!r})"
def __str__(self):
return f"({self.x}, {self.y})"
p = Point(1, 2)
print(p)
print(f"{p}")
print(f"{p!r}")
print([p, Point(3, 4)])(1, 2)
(1, 2)
Point(1, 2)
[Point(1, 2), Point(3, 4)]print や f 文字列の {p} では __str__ が、f 文字列の {p!r}(!r は「repr で文字にする」という指定)では __repr__ が使われました。そしてリストや辞書の中では、__str__ があっても __repr__ が使われます。リストや辞書を文字にするときは、中身 1 つ 1 つの repr を並べるためです。__repr__ の中の {self.x!r} も同じで、文字列なら引用符付きになり、数値の 1 と文字列の ‘1’ を見分けられます。書式指定は「Pythonのf文字列(f-string)の使い方」で詳しく解説しています。
片方だけ書くなら __repr__ です。__repr__ だけのクラスは、print でもリストの中でも同じ表示になりました。公式ドキュメントにも、__str__ がなければ代わりに __repr__ が使われるとあります。逆に __str__ だけのクラスは、リストに入れて print すると [<__main__.OnlyStr object at 0x000001EE785B2E40>] のようにアドレス表示に戻りました。まず __repr__ を書き、利用者向けに別の見せ方が必要なときだけ __str__ を足すのがおすすめです。
次は比較です。__eq__ を書いていない最初の Point で Point(1, 2) == Point(1, 2) を実行すると、中身が同じなのに False になりました。__eq__ を書かないと、== は「同じオブジェクトかどうか」(is と同じ)で比べるためです。中身で比べたいときは __eq__ を書きます。
class Point:
    def __init__(self, x, y):
        self.x = x
        self.y = y

    def __repr__(self):
        return f"Point({self.x!r}, {self.y!r})"

    def __eq__(self, other):
        if not isinstance(other, Point):
            return NotImplemented
        return (self.x, self.y) == (other.x, other.y)

p = Point(1, 2)
q = Point(1, 2)
print(p == q)
print(p != q)
print(p == (1, 2))
True
False
Falsep == q が True になりました。__ne__ を書かなくても、既定の __ne__ は __eq__ の結果を反転する(公式ドキュメント)ので != も正しく動きます。比べたい値はタプルにまとめて比べると簡単です。
__eq__ の最初で、相手が Point でなければ NotImplemented を返しています。これは「この組み合わせの比べ方は知らない」と Python に伝える特別な値です。NotImplemented を受け取った Python は、相手側の比較メソッドを試し、それでも決まらなければ == は「同じオブジェクトかどうか」で答えます。そのため p == (1, 2) はエラーにならず False になりました。
この行がないと、Point 以外と比べたときに other.x で AttributeError になります。False を返しても動きますが、相手の型に判断を任せる機会がなくなるので、NotImplemented を返すのが基本です。例外の NotImplementedError とは別物なので注意してください。
__eq__ を書いた先ほどの Point を、重複を除くために set に入れてみます。
print(Point.__hash__)
print({p, q})
None
Traceback (most recent call last):
...
print({p, q})
^^^^^^
TypeError: unhashable type: 'Point'辞書のキーにしても同じエラーでした。set や辞書は値から計算したハッシュ値(検索用の番号)で探すため、「== で等しいものはハッシュ値も同じ」でなければなりません。そこで公式ドキュメントのとおり、__eq__ を書いて __hash__ を書かないクラスでは、__hash__ が自動で None になります。
set や辞書のキーに使いたいなら、__hash__ も書きます。公式ドキュメントのおすすめは、__eq__ で比べている値をタプルにまとめて hash() に渡す方法です。先ほどの Point クラスの __eq__ の下に次のメソッドを足し、続く 2 つ目のコードを実行します。
    def __hash__(self):
        return hash((self.x, self.y))
p = Point(1, 2)
q = Point(1, 2)
print({p, q})
names = {p: "スタート"}
print(names[Point(1, 2)])
print(hash(p) == hash(q)){Point(1, 2)}
スタート
Trueset に入れると重複が 1 つにまとまり、別に作った Point(1, 2) で辞書を引けるようになりました。
注意:ハッシュ値は辞書に入れたときに計算されます。上のコードの続きで p.x = 100 とキーの値を書き換えると、names を print すれば {Point(100, 2): 'スタート'} と出るのに、Point(1, 2) in names も Point(100, 2) in names も False になりました。__hash__ を書くのは、作ったあとに値を変えないクラスだけにしましょう。値を変えられないクラスは dataclass の frozen=True で作れます(後述)。
「1.10.0」「1.2.0」のようなバージョン番号を表すクラスを作り、比較メソッドを書かずにインスタンスのリストを sorted に渡すと、TypeError: '<' not supported between instances of 'Version' and 'Version' になりました。
sorted は < で大小を比べますが、Version には「小さい」の決め方がないのでエラーになります。< に対応する特殊メソッドが __lt__(less than)です。ほかに __le__(<=)、__gt__(>)、__ge__(>=)があり、__eq__・__ne__ とあわせて 6 つの比較メソッドがあります。
6 つ全部を書くのは大変なので、標準ライブラリの functools.total_ordering を使います。__eq__ と、__lt__・__le__・__gt__・__ge__ のどれか 1 つを書けば、残りを自動で補ってくれるデコレーターです。
from functools import total_ordering

@total_ordering
class Version:
    def __init__(self, text):
        self.text = text
        self.parts = tuple(int(n) for n in text.split("."))

    def __repr__(self):
        return f"Version({self.text!r})"

    def __eq__(self, other):
        if not isinstance(other, Version):
            return NotImplemented
        return self.parts == other.parts

    def __lt__(self, other):
        if not isinstance(other, Version):
            return NotImplemented
        return self.parts < other.parts

versions = [Version("1.10.0"), Version("1.2.0"), Version("1.9.3")]
print(sorted(versions))
print(Version("2.0") >= Version("1.10.0"))
print(sorted(["1.10.0", "1.2.0", "1.9.3"]))
[Version('1.2.0'), Version('1.9.3'), Version('1.10.0')]
True
['1.10.0', '1.2.0', '1.9.3']数値のタプル (1, 10, 0) と (1, 2, 0) を比べているので、1.2.0 → 1.9.3 → 1.10.0 の正しい順に並びました。最後の行のように文字列のまま並べると、1 文字ずつ比べるため “1.10.0” が先に来てしまいます。書いていない >= も total_ordering が補ってくれました(付けずに __lt__ だけだと、<= は TypeError になりました)。
なお total_ordering で補ったメソッドは、6 つ自分で書くより遅いと公式ドキュメントにあります。並べ替えの基準がその場ごとに変わるなら、クラスに比較メソッドを書くより sorted の key を使うほうが向いています。key の使い方は「Pythonのsortedとkey・lambdaで並べ替える」で解説しています。
中にリストを持つクラスを作るとき、len()・[0]・for 文・in が使えると、利用する側が中身のリストを意識せずに済みます。
曲の一覧を持つプレイリストのクラスに、__len__(len() 用)と __getitem__([ ] 用)を書きます。
class Playlist:
    def __init__(self, name, songs):
        self.name = name
        self._songs = list(songs)

    def __len__(self):
        return len(self._songs)

    def __getitem__(self, index):
        return self._songs[index]

pl = Playlist("作業用", ["Intro", "Focus", "Break", "Outro"])
print(len(pl))
print(pl[0], pl[-1])
print(pl[1:3])
for song in pl:
    print("-", song)
print("Break" in pl)
print(bool(Playlist("空", [])))
4
Intro Outro
['Focus', 'Break']
- Intro
- Focus
- Break
- Outro
True
False受け取った index をそのまま中のリストに渡しているので、pl[-1] やスライス pl[1:3] も使えます。__iter__ がなくても for 文や in が動くのは、Python が __getitem__ を 0, 1, 2… と順に呼び、IndexError が出たところで止めるからです(古い方式の反復)。範囲外の pl[10] は IndexError: list index out of range でした。__bool__ がないときは __len__ が使われるので、空のプレイリストは False になります。
番号で取り出す必要がなく、for 文と in だけ使えればよいなら、__iter__ と __contains__ を書きます。次は、大文字・小文字を区別せずにタグを探せるクラスです。
class Tags:
    def __init__(self, *names):
        self._names = [n.lower() for n in names]

    def __iter__(self):
        return iter(self._names)

    def __contains__(self, name):
        return name.lower() in self._names

tags = Tags("Python", "Git", "SQL")
print("python" in tags)
print("PYTHON" in tags)
print(", ".join(tags))
True
True
python, git, sql__iter__ はイテレーター(次の値を 1 つずつ返すオブジェクト)を返します。中のリストの iter() を返すのが簡単です。__contains__ は in 用で、書かなくても in は __iter__ で先頭から探してくれますが、この例のように探し方を変えたいときに書きます。
よくある間違いは、__iter__ でリストそのもの(return self._names)を返すことです。for 文で TypeError: iter() returned non-iterator of type 'list' になりました。yield を使って __iter__ を書く方法や、イテレーターの仕組みは「Pythonのジェネレーターとyieldの使い方」で解説しています。
金額を表す Money クラスで、+ で足し算できるようにします。a + b は a.__add__(b) を呼びます。
class Money:
    def __init__(self, amount):
        self.amount = amount

    def __repr__(self):
        return f"Money({self.amount})"

    def __add__(self, other):
        if not isinstance(other, Money):
            return NotImplemented
        return Money(self.amount + other.amount)

    def __radd__(self, other):
        if other == 0:
            return self
        return NotImplemented

a = Money(1200)
b = Money(800)
print(a + b)
print(sum([a, b, Money(500)]))
a + 100
Money(2000)
Money(2500)
Traceback (most recent call last):
...
TypeError: unsupported operand type(s) for +: 'Money' and 'int'数値の + と同じく、元の a や b は書き換えず新しいオブジェクトを返すのが自然です。扱えない相手(ここでは int)には NotImplemented を返したので、a + 100 は Python 標準の分かりやすい TypeError になりました。__radd__ は、左側が足し方を知らないときに右側で呼ばれるメソッドです。sum() は 0 から足し始めるので、0 + Money(1200) で Money.__radd__(0) が呼ばれます。
NotImplemented を返さずに return Money(self.amount + other.amount) とだけ書くと、a + 100 は AttributeError: 'int' object has no attribute 'amount' になり、原因が分かりにくくなりました。__radd__ がないと、sum() は TypeError: unsupported operand type(s) for +: 'int' and 'Money' になりました。- は __sub__、* は __mul__ で同じように決められます。
if x: と書いたときに True と False のどちらとして扱うかは __bool__ で決められます。入力チェックの結果を表すクラスで、エラーがなければ True にしてみます。
class Result:
    def __init__(self, errors):
        self.errors = errors

    def __bool__(self):
        return not self.errors

ok = Result([])
ng = Result(["名前が空です"])
print(bool(ok), bool(ng))
if not ng:
    print("エラー:", ng.errors)
True False
エラー: ['名前が空です']公式ドキュメントによると、判定の順番は「__bool__ → なければ __len__(0 以外なら True)→ どちらもなければ常に True」です。__bool__ で return 1 と書くと TypeError: __bool__ should return bool, returned int になりました。
__len__ を書いたクラスは 0 件のとき False になるので、None かどうかを調べたいときは if pl: ではなく if pl is not None: と書きましょう。
with 文も特殊メソッドで動いています。with に入るときに __enter__、抜けるときに(例外が起きても)__exit__ が呼ばれ、__exit__ が True を返すと例外が握りつぶされます。書き方と落とし穴は「Pythonのwith文とは?コンテキストマネージャーの仕組みと作り方」で詳しく解説しています。
値をまとめて持つだけのクラスなら、@dataclass を付けるだけで特殊メソッドが自動で作られます。中身を確かめます。
import inspect
from dataclasses import dataclass

@dataclass
class Point:
    x: int
    y: int

p = Point(1, 2)
print(p)
print(p == Point(1, 2))
print(Point.__hash__)
print(inspect.signature(Point.__init__))
print("__repr__" in Point.__dict__, "__eq__" in Point.__dict__, "__str__" in Point.__dict__)
Point(x=1, y=2)
True
None
(self, x: int, y: int) -> None
True True False__init__ は (self, x: int, y: int) を受け取る形で作られ、__repr__ と __eq__ もクラスに作られています。__str__ は作られませんが、__repr__ が代わりに使われます。__eq__ が作られたので、手で書いたときと同じく __hash__ は None、つまりこのままでは set に入れられません。
@dataclass(frozen=True) にすると値を書き換えられなくなる代わりに __hash__ も作られ、{Point(1, 2), Point(1, 2)} が {Point(x=1, y=2)} にまとまりました。値を変えられないので、キーが見つからなくなる問題も起きません。order=True で __lt__ などの比較メソッドも作れます。オプションや既定値の書き方は「Pythonのdataclassの使い方」で解説しています。
目安は、値をまとめるだけなら dataclass、独自の比べ方や len()・+ が必要なら特殊メソッドを手で書くです。dataclass に __str__ だけ足すこともできます。
特殊メソッドを何も書いていないクラス Box で実際に出たエラーと、書けば直るメソッドの対応です。
| エラーメッセージ | 書くメソッド |
|---|---|
object of type 'Box' has no len() | __len__ |
'Box' object is not iterable | __iter__(または __getitem__) |
unsupported operand type(s) for +: 'Box' and 'Box' | __add__ |
'<' not supported between instances of 'Box' and 'Box' | __lt__(+ total_ordering) |
メソッド名のつづり間違い(def __str(self): や def _str_(self):)はエラーにならず、ふつうのメソッドになるだけなので、表示が変わらないときは前後のアンダースコアの数を確かめます。また __str__ で数値を返すと、print した時点で TypeError: __str__ returned non-string (type int) になりました。
動きますが、len(p) を使いましょう。組み込みの側でチェックが入るためです。__len__ が -1 を返すクラスで len() を呼ぶと ValueError: __len__() should return >= 0 になりましたが、直接呼ぶと -1 がそのまま返りました。
避けてください。公式ドキュメント(字句解析の章 2.3.3)では、前後にアンダースコア 2 つが付いた名前は Python が定義する名前で、ドキュメントにない使い方をすると警告なしに壊れることがある、とされています。自分のメソッドは my_method、内部用なら _my_method にします。先頭だけにアンダースコア 2 つを付けた __name は別の仕組み(名前マングリング)で、「Pythonのクラスの基本」で説明しています。
print()・==・len()・+ などの組み込みの書き方が裏で呼ぶメソッド__repr__。リストの中や !r では repr が使われる__eq__ を書くと __hash__ が None になる。set や辞書のキーにするなら、値を変えないクラスで hash((...)) を返す__eq__+__lt__+@total_ordering。扱えない相手には NotImplemented を返す