Pythonのloggingの使い方|printから卒業するログ出力の基本と設定例
hr
ENG LIFE BLOG
「個数を数える」「部署ごとに名前をまとめる」「最新の 3 件だけ残す」といった処理は、普通に書くと if 文や初期化が増えがちです。標準ライブラリの collections モジュールには、こうした処理を短く安全に書くための入れ物(コンテナ)がそろっています。インストールは不要で、from collections import Counter のように読み込むだけで使えます。
この記事では、よく使う Counter・defaultdict・deque の 3 つを中心に、namedtuple・OrderedDict・ChainMap も含めて、使いどころとよくある間違いを実行結果つきで説明します。載せている出力は、Windows 11・Python 3.12.6 で実際に実行して確かめたものです。仕様は Python 公式ドキュメントの collections のページで確認しています。
collections の型は、どれもリスト・辞書・タプルの「便利版」です。普通の辞書やリストで書くと面倒になる場面で使います。
| 型 | もとになる型 | 得意なこと | よくある使い道 |
|---|---|---|---|
| Counter | dict | 個数を数える | 単語・アクセス元・エラーの種類の集計、上位 N 件 |
| defaultdict | dict | ないキーに初期値を自動で入れる | グループ分け、合計の集計 |
| deque | list に近い | 両端の追加・削除が速い | キュー(先入れ先出し)、直近 N 件の保持 |
| namedtuple | tuple | 項目に名前を付けたタプル | 座標や CSV の 1 行など、変えない小さなデータ |
| OrderedDict | dict | 順番の入れ替え | LRU キャッシュ(古いものから捨てる) |
| ChainMap | dict を束ねる | 複数の辞書を重ねて 1 つに見せる | 設定の優先順位(引数 → 環境 → 既定値) |
以降のコードは、sample.py などの名前で保存し、PowerShell でそのフォルダーに移動してから次のコマンドで実行できます。
py sample.pyCounter にリストや文字列を渡すと、要素ごとの個数を数えた辞書のようなものができます。most_common(n) で多い順に n 件を取り出せます。
from collections import Counter
words = ["りんご", "みかん", "りんご", "ぶどう", "みかん", "りんご"]
c = Counter(words)
print(c)
print(c["りんご"], c["もも"])
print(c.most_common(2))
print(c.most_common())
print(c.total())
print(Counter("mississippi"))
Counter({'りんご': 3, 'みかん': 2, 'ぶどう': 1})
3 0
[('りんご', 3), ('みかん', 2)]
[('りんご', 3), ('みかん', 2), ('ぶどう', 1)]
6
Counter({'i': 4, 's': 4, 'p': 2, 'm': 1})most_common() は (要素, 個数) のタプルのリストを返します。n を省略するとすべてです。公式ドキュメントでは、個数が同じ要素は「最初に現れた順」に並ぶと説明されています(mississippi では i が s より先に現れるので i が先)total() は個数の合計です。Python 3.10 で追加されたので、それより古い環境では sum(c.values()) を使いますないキーが 0 として扱われるので、空の Counter を作って c[キー] += 1 と書くだけで数えられます。普通の辞書のように「キーがあるか」を先に調べる必要はありません。あとから追加で数えるときは update() を使います。
from collections import Counter
c = Counter()
for line in ["GET /index", "POST /login", "GET /index", "GET /about"]:
    method = line.split()[0]
    c[method] += 1
print(c)
c.update(["GET", "PUT"])
print(c)
print(dict(c))
Counter({'GET': 3, 'POST': 1})
Counter({'GET': 4, 'POST': 1, 'PUT': 1})
{'GET': 4, 'POST': 1, 'PUT': 1}Counter の update() は、普通の辞書の update と違って値を上書きせず足し算します。dict(c) で普通の辞書に戻せます。
Counter どうしは + と - で計算できます。たとえば「在庫」と「出荷」の差を出すような場面で便利ですが、結果が 0 以下になった要素は消えることに注意してください。
from collections import Counter
a = Counter(りんご=3, みかん=1)
b = Counter(りんご=1, みかん=2, もも=1)
print(a + b)
print(a - b)
print(b - a)
a.subtract(b)
print(a)
print(+a)
Counter({'りんご': 4, 'みかん': 3, 'もも': 1})
Counter({'りんご': 2})
Counter({'みかん': 1, 'もも': 1})
Counter({'りんご': 2, 'みかん': -1, 'もも': -1})
Counter({'りんご': 2})a - b では、みかんが 1 − 2 = −1、ももが 0 − 1 = −1 になるため、どちらも結果から消えて「りんご 2」だけが残りました。マイナスも残したいときは subtract() を使います。subtract は新しい Counter を返さず、a そのものを書き換えます。反対に、0 以下の要素を取り除きたいときは単項の +a が使えます。
実務でよくあるのが、CSV のある列の値を数える処理です。csv.DictReader の各行から列を取り出して Counter に渡すだけで集計できます(ここでは説明のため、CSV の中身を文字列で用意しています)。
import csv, io
from collections import Counter
data = "name,dept\n田中,営業\n佐藤,開発\n鈴木,営業\n"
reader = csv.DictReader(io.StringIO(data))
print(Counter(row["dept"] for row in reader))
Counter({'営業': 2, '開発': 1})Counter と defaultdict は辞書の一種(dict のサブクラス)なので、そのまま json.dumps() に渡せます。json.dumps(Counter(["東京", "大阪", "東京"]), ensure_ascii=False) の結果は {"東京": 2, "大阪": 1} でした。出力した JSON が長いときは、JSON整形ツールに貼ると、字下げして読みやすくできます。CSV の読み方そのものは「PythonでCSVを読み書きする方法」、JSON の書き出しは「PythonでJSONを扱う方法」で詳しく説明しています。
「部署ごとに社員の名前をリストにまとめる」処理を、普通の辞書でそのまま書くとエラーになります。最初の「営業」の時点では、辞書にまだ「営業」のリストがないからです。
rows = [("営業", "田中"), ("開発", "佐藤"), ("営業", "鈴木"), ("開発", "高橋"), ("総務", "伊藤")]
groups = {}
for dept, name in rows:
    groups[dept].append(name)
groups[dept].append(name)
~~~~~~^^^^^^
KeyError: '営業'普通の辞書なら、groups.setdefault(dept, []).append(name) のように「なければ空のリストを入れる」処理が必要です。
defaultdict を使うと、この「なければ作る」処理を書かずに済みます。defaultdict(list) は、ないキーを読もうとしたときに list() を呼んで空のリストを作り、そのキーに入れてから返します。
from collections import defaultdict
rows = [("営業", "田中"), ("開発", "佐藤"), ("営業", "鈴木"), ("開発", "高橋"), ("総務", "伊藤")]
groups = defaultdict(list)
for dept, name in rows:
    groups[dept].append(name)
print(groups)
print(dict(groups))
print(groups.default_factory)
defaultdict(<class 'list'>, {'営業': ['田中', '鈴木'], '開発': ['佐藤', '高橋'], '総務': ['伊藤']})
{'営業': ['田中', '鈴木'], '開発': ['佐藤', '高橋'], '総務': ['伊藤']}
<class 'list'>最初に渡した list は default_factory(初期値を作る関数)と呼ばれ、groups.default_factory で確かめられます。dict() で普通の辞書に変換できます。
default_factory には、引数なしで呼べるもの(関数やクラス)を渡します。よく使うのは次の 4 つです。
| 書き方 | ないキーの初期値 | 使い道 |
|---|---|---|
defaultdict(list) | [] | グループ分け(append で追加) |
defaultdict(int) | 0 | 個数・合計の集計(+= で足す) |
defaultdict(set) | set() | 重複なしのグループ分け(add で追加) |
defaultdict(lambda: "不明") | “不明” | 好きな値を初期値にする |
int() は 0 を返すので、defaultdict(int) で数を数えられます。個数ではなく金額などを合計するときに便利です。
defaultdict が初期値を作るのは、d[キー] の形で読んだときだけです。公式ドキュメントにも、get() は普通の辞書と同じく None を返すと書かれています。また、d[キー] で読んだだけでキーが追加される点にも注意が必要です。
from collections import defaultdict
d = defaultdict(list)
print(d.get("x"))
print("x" in d)
print(d["x"])
print("x" in d)
print(len(d), dict(d))
None
False
[]
True
1 {'x': []}「キーがあるか調べたいだけ」のときに if d["x"]: と書くと、空のリストが勝手に追加され、あとで JSON に書き出したときに空の項目が混ざる原因になります。存在の確認には "x" in d を使いましょう。
deque(デック。double-ended queue の略)は、左右どちらの端からでも追加・取り出しができる入れ物です。リストと同じ append と pop に加えて、左端用の appendleft・popleft があります。
from collections import deque
q = deque([1, 2, 3])
q.append(4)
q.appendleft(0)
print(q)
print(q.pop(), q.popleft())
print(q)
q.extend([7, 8])
q.extendleft([-1, -2])
print(q)
q.rotate(1)
print(q)
print(q[0], q[-1])
deque([0, 1, 2, 3, 4])
4 0
deque([1, 2, 3])
deque([-2, -1, 1, 2, 3, 7, 8])
deque([8, -2, -1, 1, 2, 3, 7])
8 7extendleft([-1, -2]) は 1 つずつ左に足していくので、結果は -2, -1 の順(逆順)になります。rotate(1) は全体を右に 1 つずらし、右端の 8 が左端に回ります。
リストでも pop(0) で先頭を取り出せますが、リストは要素を連続した場所に並べているため、先頭を抜くと残りをすべて 1 つずつ前に詰め直します。deque は端を外すだけなので、残りの要素は動きません。公式ドキュメントでも、deque の両端の追加・取り出しは O(1)(要素数に関係なくほぼ一定の時間)、リストの pop(0) と insert(0, v) は O(n)(要素数に比例して時間がかかる)と説明されています。
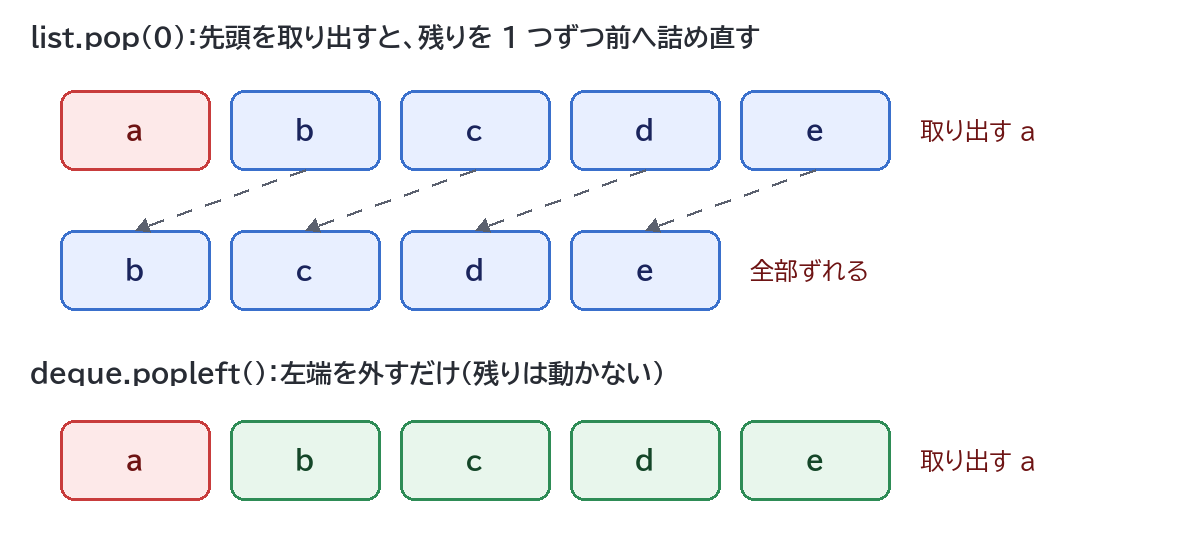
どれくらい差が出るのか、標準ライブラリの timeit で、すべての要素を先頭から 1 つずつ取り出す時間を測りました。
import timeit
for n in (10_000, 100_000):
    t_list = timeit.timeit("while x: x.pop(0)", setup=f"x = list(range({n}))", number=1)
    t_deque = timeit.timeit("while x: x.popleft()", setup=f"from collections import deque; x = deque(range({n}))", number=1)
    print(f"{n:>7,} 件  list.pop(0): {t_list:.4f} 秒  deque.popleft(): {t_deque:.4f} 秒  約 {t_list / t_deque:.0f} 倍")
10,000 件 list.pop(0): 0.0785 秒 deque.popleft(): 0.0002 秒 約 487 倍
100,000 件 list.pop(0): 7.9858 秒 deque.popleft(): 0.0017 秒 約 4684 倍この PC(Windows 11、Core i7-13700F、Python 3.12.6)では、10 万件のときに list が約 8 秒、deque が約 0.002 秒でした。3 回測っても、ほぼ同じ結果でした。注目したいのは、件数が 10 倍になると deque の時間はほぼ 10 倍なのに、list は約 100 倍になっている点です。1 回の pop(0) が件数に比例して遅くなるので、全部を取り出す時間は件数の 2 乗に比例して増えます。数値は PC によって変わりますが、「件数が多いほど差が開く」傾向は同じです。
deque を作るときに maxlen を指定すると、最大の長さを超えた分は反対側の端から自動で捨てられます。「最近見たページ」「直近 3 回の測定値」のような、新しいものだけを残したい場面にぴったりです。
from collections import deque
recent = deque(maxlen=3)
for page in ["/home", "/news", "/about", "/contact", "/faq"]:
    recent.append(page)
    print(list(recent))
print(recent)
print(recent.maxlen)
['/home']
['/home', '/news']
['/home', '/news', '/about']
['/news', '/about', '/contact']
['/about', '/contact', '/faq']
deque(['/about', '/contact', '/faq'], maxlen=3)
3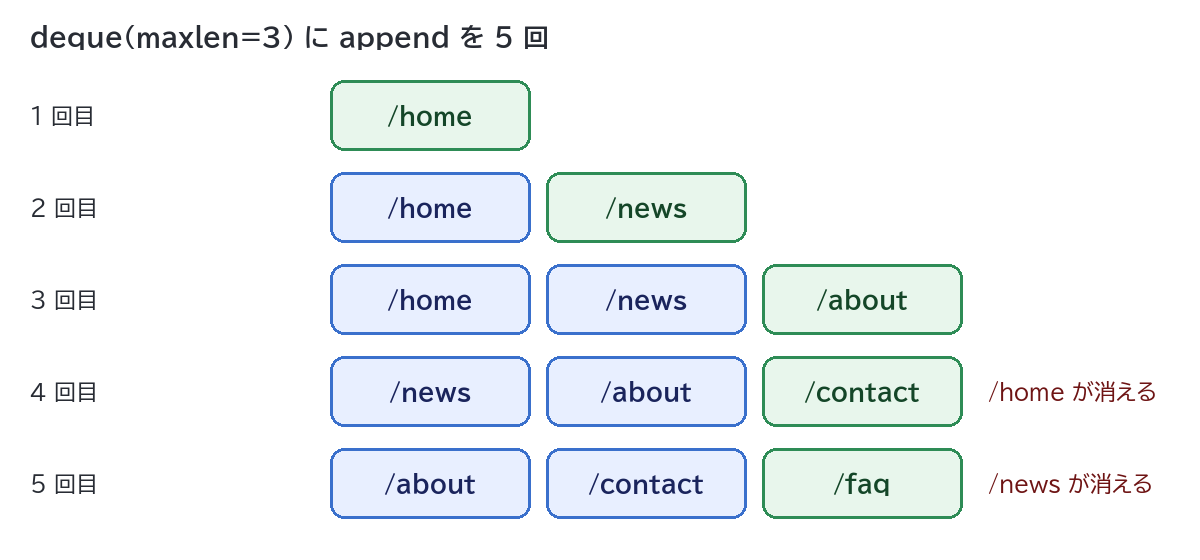
namedtuple は、タプルの各要素に名前を付けて p.x のように取り出せるようにしたものです。p[0] のような番号でも取り出せ、x, y = p の分解もできます。
from collections import namedtuple
Point = namedtuple("Point", ["x", "y"])
p = Point(3, 4)
print(p)
print(p.x, p[1])
x, y = p
print(x + y)
print(p._asdict())
print(p._replace(x=10))
print(p == (3, 4))
p.x = 5
Point(x=3, y=4)
3 4
7
{'x': 3, 'y': 4}
Point(x=10, y=4)
True
Traceback (most recent call last):
…
AttributeError: can't set attributeタプルなので値は変更できず、p.x = 5 は AttributeError になります。値を変えたいときは _replace() で新しいものを作ります。_asdict() は辞書に変換します(Python 3.8 からは OrderedDict ではなく普通の dict を返します)。
項目が多い、既定値を付けたい、値を変更したいといった場合は、dataclass のほうが向いています。違いと使い分けは「Pythonのdataclassの使い方」の「辞書・namedtuple との使い分け」で説明しています。
OrderedDict は「追加した順番を覚えている辞書」として作られました。しかし公式ドキュメントにあるとおり、Python 3.7 からは普通の dict も追加した順番を保つことが言語の仕様として保証されたため、「順番を保ちたいから OrderedDict」という理由で使う必要はなくなりました。古い記事やコードで OrderedDict を見かけるのは、この保証がなかった時代の名残であることが多いです。
from collections import OrderedDict
d = {}
d["b"] = 2
d["a"] = 1
d["c"] = 3
print(d, list(d))
print({"a": 1, "b": 2} == {"b": 2, "a": 1})
print(OrderedDict(a=1, b=2) == OrderedDict(b=2, a=1))
print(OrderedDict(a=1, b=2) == {"b": 2, "a": 1})
od = OrderedDict(a=1, b=2, c=3)
od.move_to_end("a")
print(od)
od.move_to_end("c", last=False)
print(od)
print(od.popitem(last=False))
{'b': 2, 'a': 1, 'c': 3} ['b', 'a', 'c']
True
False
True
OrderedDict({'b': 2, 'c': 3, 'a': 1})
OrderedDict({'c': 3, 'b': 2, 'a': 1})
('c', 3)普通の dict も、b・a・c と追加した順に表示されています。それでも OrderedDict が役に立つのは、次のような「順番そのものを操作・比較する」場面です。
last=False なら先頭へ移すこの 2 つを組み合わせると、「使ったものを move_to_end で末尾へ移し、容量を超えたら popitem(last=False) でいちばん古いものを捨てる」LRU キャッシュが書けます。ただ、関数の結果をキャッシュしたいだけなら、標準ライブラリの functools.lru_cache を使うほうが簡単です。
ChainMap は、複数の辞書を 1 つにまとめて見せるものです。キーを探すときは前の辞書から順に探し、最初に見つかった値を返します。「コマンドの引数 → 環境ごとの設定 → 既定値」のような優先順位のある設定に向いています。
from collections import ChainMap
defaults = {"color": "red", "user": "guest", "debug": False}
env = {"user": "admin"}
args = {"debug": True}
config = ChainMap(args, env, defaults)
print(config["color"], config["user"], config["debug"])
print(dict(config))
config["color"] = "blue"
print(args)
print(defaults)
red admin True
{'color': 'red', 'user': 'admin', 'debug': True}
{'debug': True, 'color': 'blue'}
{'color': 'red', 'user': 'guest', 'debug': False}読み取りはすべての辞書から探しますが、書き込み・削除は最初の辞書(ここでは args)にだけ行われます。config["color"] = "blue" は args に追加され、defaults は変わっていません。また、ChainMap は元の辞書をコピーせずに参照しているので、元の辞書を変えると ChainMap の見え方も変わります。
Counter は渡されたものを 1 つずつ取り出して数えます。文字列を渡すと 1 文字ずつ数えるため、単語を 1 つ数えたいのに Counter("apple") と書くと Counter({'p': 2, 'a': 1, 'l': 1, 'e': 1}) になります。単語として数えるには Counter(["apple"]) のようにリストに入れます(結果は Counter({'apple': 1}))。文章を単語ごとに数えるなら、先に split() などで単語のリストにしてから渡します。
default_factory には「呼び出すもの」を渡すので、list にかっこは付けません。defaultdict(list()) と書くと、空のリストそのものを渡したことになり、次のエラーになります。
TypeError: first argument must be callable or None「0 ではなく 1 から始めたい」のように特定の値にしたいときも、defaultdict(1) ではなく defaultdict(lambda: 1) と、値を返す関数にします。
前に説明したとおり、a - b の結果からは 0 以下の要素が消えます。「在庫 − 注文」で足りない商品を調べたいのに、マイナスになった商品が結果に出てこない、という間違いが起こります。マイナスも見たいときは subtract() を使います。また、c["b"] = 0 のように直接 0 を入れた要素は消えずに残ります(len() にも数えられます)。
deque は q[0] や q[-1] のような番号での取り出しはできますが、q[1:3] のようなスライスはできません。必要なら list(q)[1:3] のようにリストに変換してから切り出します。空の deque で popleft() を呼んだときのエラーも合わせて覚えておきましょう。
TypeError: sequence index must be integer, not 'slice'
IndexError: pop from an empty dequeキューから取り出すループは、while queue: のように中身があるかを確かめてから popleft() します。
個数を数えるなら Counter が便利です。most_common で上位を取り出せ、Counter どうしの足し算・引き算もできます。金額の合計など「個数ではない数を足す」ときや、リスト・セットにまとめたいときは defaultdict を使う、と分けると迷いません。
おすすめしません。deque はスライスやソート(sort メソッド)ができず、公式ドキュメントによると番号での取り出しも真ん中に近いほど遅くなります(O(n))。「両端での出し入れが多い」「直近 N 件だけ残したい」ときに deque、それ以外はリストを使うのが基本です。リストの操作は「Pythonのリスト・辞書・内包表記の基本」を参照してください。
d[キー] で読んだときだけ