Pythonのargparseの使い方|コマンドライン引数の受け取り方を実例で解説
hr
ENG LIFE BLOG
値によって処理を分けるとき、Python では長く if・elif を並べるのが普通でした。Python 3.10 で追加された match 文(構造的パターンマッチ)を使うと、「この値ならこれ」を並べて書けるだけでなく、リストを分解したり、辞書(JSON)から必要なキーだけ取り出したりしながら振り分けられます。
この記事では、match 文の基本(_ と |、上から順に調べる仕組み)、リスト・辞書・クラスのパターン、ガード(if)と as、そして一番の落とし穴である「case RED: と書くと何でも一致してしまう」問題までを順に説明します。載せている出力は、Windows 11・Python 3.12.6 で実際に実行して確かめたものです。
match 文は、match の後ろに書いた値(公式ドキュメントではサブジェクトと呼びます)を、case に書いたパターンと上から順に比べ、最初に一致した case の中身だけを実行する構文です。公式チュートリアルでは「C・Java・JavaScript の switch 文に表面上は似ているが、Rust や Haskell のパターンマッチにより近い」と説明されています。似ているのは見た目だけで、値を比べるだけでなく、値の形(構造)を調べて中身を変数に取り出せるのが大きな違いです。
言語リファレンス(8.6 match 文)には「Added in version 3.10」とあり、提案文書の PEP 636 も対象バージョンは 3.10 です。3.9 以前では構文として存在しないので使えません(構文エラーになります。この記事の環境には 3.9 がないため、そのエラー表示は確認していません)。使っている Python のバージョンは次のコマンドで確かめられます。
py --versionPython 3.12.6なお、match と case は「ソフトキーワード」で、match 文の位置以外ではふつうの名前として使えます。match = re.match(r"\d+", "123abc") のような既存のコードも、3.12 でそのまま動きました。
HTTP のステータスコードからメッセージを返す関数を、まず if・elif で書きます。
def http_message(status):
    if status == 200:
        return "成功"
    elif status == 404:
        return "見つかりません"
    elif status == 401 or status == 403:
        return "権限がありません"
    else:
        return "その他"

for code in [200, 404, 403, 500]:
    print(code, http_message(code))
同じ内容を match 文で書くと次のようになります。sample.py という名前で保存してください。
def http_message(status):
    match status:
        case 200:
            return "成功"
        case 404:
            return "見つかりません"
        case 401 | 403:
            return "権限がありません"
        case _:
            return "その他"

for code in [200, 404, 403, 500]:
    print(code, http_message(code))
PowerShell で、sample.py を保存したフォルダーに移動してから実行します。
py sample.py200 成功
404 見つかりません
403 権限がありません
500 その他どちらも結果は同じです。match 文の書き方のポイントは次の 3 つです。
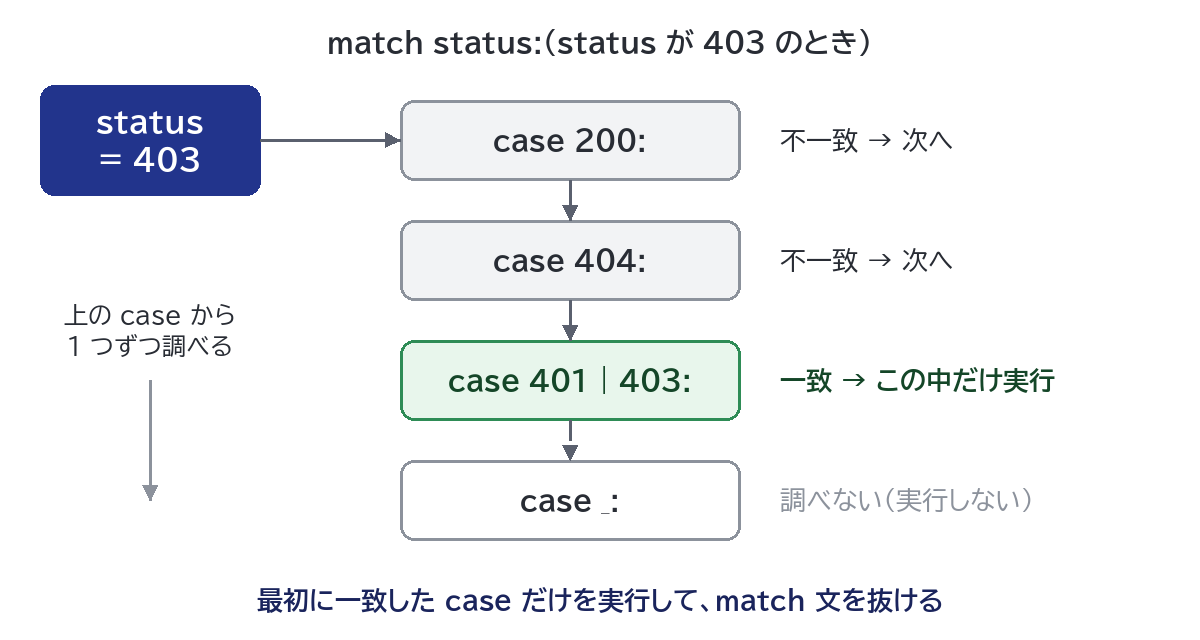
case 200: のように数値や文字列をそのまま書くと、値が == で等しいときに一致する(リテラルパターン)。ただし True・False・None は is で比べられるcase 401 | 403: のように | でつなぐと「どれかに一致すれば OK」になる(or ではなく | と書く)case _: の _ はワイルドカードで、何にでも一致する。if 文の else にあたるPEP 636 には「match 文はパターンを上から下へ調べ、最初に一致したパターンが見つかるとその case の中身を実行し、それ以降の case はすべて無視される」と書かれています。403 を渡したときの流れを図にすると次のとおりです。
「最初の 1 つだけ」であることは、重なるパターンを並べると確かめられます。
def check(n):
    match n:
        case 0:
            print("ゼロ")
        case 0 | 1:
            print("0 か 1")
        case _:
            print("それ以外")

check(0)
check(1)
check(5)
ゼロ
0 か 1
それ以外0 は case 0 | 1: にも当てはまりますが、先に case 0: に一致したので「ゼロ」だけが表示されました。C や Java の switch 文と違って、break を書かなくても次の case へ流れ込む(フォールスルー)ことはありません。
また、どの case にも一致しなければ何も実行されず、エラーにもなりません。上の http_message から case _: を消して 500 を渡すと、関数は何も返さずに None になります。想定外の値に気づきたいときは、最後に case _: を置いて raise ValueError(...) のように例外を出すと安全です(例外の出し方は「Pythonの例外処理入門」参照)。
match 文の本領は、値の形で振り分けて、中身を変数に取り出せることです。[x, y] のように書くと「要素がちょうど 2 個のリスト(やタプル)」に一致し、それぞれの要素が x と y に入ります。*rest を付けると「残り全部」をリストで受け取れます。簡単なコマンドを解釈する例です。
def run(line):
    match line.split():
        case ["quit"]:
            print("終了します")
        case ["go", direction]:
            print(f"{direction} へ移動")
        case ["get", first, *rest]:
            print(f"取る: {first} / 残り: {rest}")
        case []:
            print("何か入力してください")
        case _:
            print(f"分からないコマンド: {line!r}")

run("quit")
run("go north")
run("get apple")
run("get apple banana cherry")
run("")
run("go")
run("dance now please")
終了します
north へ移動
取る: apple / 残り: []
取る: apple / 残り: ['banana', 'cherry']
何か入力してください
分からないコマンド: 'go'
分からないコマンド: 'dance now please'["go", direction] は「1 個目が文字列 “go” で、ちょうど 2 個」のときだけ一致する。"go" だけの入力は要素が 1 個なので一致しない["get", first, *rest] は 2 個以上で一致し、3 個目以降が rest にリストで入る。2 個ちょうどなら rest は空のリスト[] は空のリスト(空の入力を split した結果)に一致するif 文で同じことをするには、len(words) == 2 and words[0] == "go" のような長さのチェックと添字の取り出しを毎回書く必要があります。match 文なら、形のチェックと取り出しが 1 行で済みます。* の付いた名前は 1 つのパターンに 1 つまでで、残りを使わないときは *_ と書けます。コマンドライン引数を本格的に扱うなら、標準ライブラリの argparse も検討してください(「Pythonのargparseの使い方」参照)。
{"type": "user", "name": name} のように辞書の形で書くと、「キー type の値が “user” で、キー name がある」辞書に一致し、name の値が変数 name に入ります。種類ごとに中身が違う JSON のイベントを振り分ける例です。
import json

text = '''[
  {"type": "user", "name": "sato", "age": 30},
  {"type": "order", "id": 101, "items": ["pen", "note"]},
  {"type": "user"},
  {"type": "ping"},
  {"name": "tanaka"}
]'''

for event in json.loads(text):
    match event:
        case {"type": "user", "name": name}:
            print(f"ユーザー: {name}")
        case {"type": "order", "id": int(order_id), "items": [*items]}:
            print(f"注文 {order_id}: {len(items)} 点")
        case {"type": kind, **rest}:
            print(f"未対応の type: {kind} 残り={rest}")
        case _:
            print(f"type がない: {event}")
ユーザー: sato
注文 101: 2 点
未対応の type: user 残り={}
未対応の type: ping 残り={}
type がない: {'name': 'tanaka'}注目したいのは 1 件目です。sato のデータには "age": 30 という、パターンに書いていないキーがありますが、問題なく一致しました。公式チュートリアルにも「シーケンスパターンと違い、余分なキーは無視される」とあります。リストは要素の数がぴったりでないと一致しないのに対し、辞書は「書いたキーがそろっていれば OK」という違いを覚えておきましょう。
{"type": "user"} は name キーがないので 1 つ目の case に一致せず、3 つ目の case に進んだ"id": int(order_id) は「値が int なら order_id に入れる」という意味(後で説明するクラスパターン)。"items": [*items] は「値がリストなら」**rest を書くと、パターンに書かなかったキーを辞書で受け取れる。{"type": "user", "name": "sato"} を {"type": "user", **rest} に通すと、rest は {'name': 'sato'} になったJSON の読み込み方は「PythonでJSONを扱う方法」で、受け取った JSON の形を確かめたいときは「JSON整形ツール」で整形すると、どんなキーがあるか見やすくなります。
int()・str() のようにクラス名にかっこを付けて書くと、「その型の値なら一致」になります(isinstance と同じ考え方です)。
def describe(value):
    match value:
        case bool():
            return f"真偽値 {value}"
        case int() | float():
            return f"数値 {value}"
        case str() if value == "":
            return "空の文字列"
        case str():
            return f"文字列 {value!r}"
        case list() | tuple():
            return f"要素 {len(value)} 個の並び"
        case None:
            return "None"
        case _:
            return f"その他の型 {type(value).__name__}"

for v in [True, 3, 2.5, "", "abc", [1, 2], (1,), None, {"a": 1}]:
    print(describe(v))
真偽値 True
数値 3
数値 2.5
空の文字列
文字列 'abc'
要素 2 個の並び
要素 1 個の並び
None
その他の型 dictbool() を int() より先に書いているのには理由があります。Python では True・False は int の仲間(bool は int を継承したクラス)なので、順番を逆にして case int(): を先に書くと、describe(True) は「数値 True」になりました。型で振り分けるときは、細かい型を先に書くのが鉄則です。
言語リファレンスによると、int・str・float・list などの組み込み型は、かっこの中にパターンを 1 つ書くとそれを値全体と照らし合わせます。たとえば int(0 | 1) は 0 には一致しますが 0.0 には一致しません。一方、ただの case 1: は == で比べるので、1.0 にも一致しました。
自分で作ったクラスにも使えます。Point(x=0, y=y) は「Point のインスタンスで、属性 x が 0」のときに一致し、属性 y の値を変数 y に入れます。dataclass なら、Point(x, 0) のように属性名を省いて位置で書くこともできます。
from dataclasses import dataclass

@dataclass
class Point:
    x: int
    y: int

def where(p):
    match p:
        case Point(x=0, y=0):
            return "原点"
        case Point(x=0, y=y):
            return f"y 軸の上(y={y})"
        case Point(x, 0):
            return f"x 軸の上(x={x})"
        case Point(x, y) if x == y:
            return f"斜めの線 y=x の上({x})"
        case Point():
            return "その他の場所"
        case _:
            return "Point ではない"

for p in [Point(0, 0), Point(0, 5), Point(3, 0), Point(2, 2), Point(1, 4), (1, 4)]:
    print(p, "->", where(p))
print(Point.__match_args__)
Point(x=0, y=0) -> 原点
Point(x=0, y=5) -> y 軸の上(y=5)
Point(x=3, y=0) -> x 軸の上(x=3)
Point(x=2, y=2) -> 斜めの線 y=x の上(2)
Point(x=1, y=4) -> その他の場所
(1, 4) -> Point ではない
('x', 'y')位置で書けるのは、dataclass が __match_args__ という属性(ここでは ('x', 'y'))を自動で作るからです。これが「1 番目は x、2 番目は y」という対応表になります。普通のクラスで位置の書き方を使いたいときは、クラスに __match_args__ = ("x", "y") を自分で書きます。最後の (1, 4) は値が同じでもただのタプルなので、Point のパターンには一致しませんでした。
パターンの中の x= や Point は変数に代入されません。公式チュートリアルの言葉では、代入されるのは「単独の名前(y など)だけ」で、ドット付きの名前・属性名・クラス名は代入されません。この性質が、後で説明する落とし穴につながります。dataclass そのものは「Pythonのdataclassの使い方」で解説しています。
パターンだけでは書けない条件は、case パターン if 条件: の形で足せます。これをガードと呼びます。パターンが一致し、変数に値が入ったあとでガードの条件が調べられ、False なら次の case へ進みます。
def classify(n):
    match n:
        case int(x) if x > 0:
            return f"正の数 {x}"
        case int(x) if x < 0:
            return f"負の数 {x}"
        case 0:
            return "ゼロ"
        case _:
            return "整数ではない"

for n in [5, -3, 0, 1.5]:
    print(classify(n))
正の数 5
負の数 -3
ゼロ
整数ではない0 は 1 つ目・2 つ目の case でパターン int(x) には一致しますが、ガードが False なので次へ進み、case 0: で止まりました。前の節の Point(x, y) if x == y も同じ仕組みです。
| で候補を並べたとき、「実際にどれだったか」を知りたいことがあります。(パターン) as 名前 と書くと、一致した値をその名前で受け取れます。
def handle(cmd):
    match cmd.split():
        case ["move", ("up" | "down" | "left" | "right") as d]:
            print(f"{d} へ動く")
        case ["move", other]:
            print(f"方向 {other!r} は使えません")
        case [("help" | "?") as word, *_]:
            print(f"{word} -> ヘルプを表示")

handle("move up")
handle("move north")
handle("? anything")
up へ動く
方向 'north' は使えません
? -> ヘルプを表示1 つ目の case は、2 個目の要素が up・down・left・right のどれかのときだけ一致し、その文字列が d に入ります。*_ は「残りは何個あってもよく、使わない」という意味です。
match 文で一番多い間違いは、定数のつもりでドットのない名前を case に書くことです。
RED = "red"
GREEN = "green"

def show(color):
    match color:
        case RED:
            print("赤です")
        case GREEN:
            print("緑です")

show("green")
File "...\sample.py", line 6
case RED:
^^^
SyntaxError: name capture 'RED' makes remaining patterns unreachable実行する前に SyntaxError で止まりました(表示のパスは省略しています)。メッセージは「名前 RED への取り込み(capture)のせいで、残りのパターンに到達できない」という意味です。case に単独の名前を書くと、それは「定数 RED と比べる」ではなく「どんな値でも一致して、その値を変数 RED に代入する」(キャプチャパターン)になります。PEP 636 にも「ドットのない名前は、常にキャプチャパターンとして解釈される」とあります。何にでも一致する case の後ろの case GREEN: には絶対に届かないので、Python がエラーにしてくれたわけです。
怖いのは、case RED: が最後の case のときはエラーにならないことです。
RED = "red"

color = "blue"
match color:
    case RED:
        print("赤です")
print("RED =", RED)
赤です
RED = blue“blue” なのに「赤です」と表示され、しかも定数だったはずの RED が “blue” に書き換わってしまいました。ほかの関数からも参照する定数が壊れるので、気づきにくいバグになります。
公式チュートリアルには「パターンで名前付きの定数を使うときは、キャプチャ変数と解釈されないようにドット付きの名前にする必要がある」とあります。Color.RED のようにドットが入っていれば、それは代入ではなく == で比べる値パターンになります。定数をまとめるには Enum が向いています。
from enum import Enum

class Color(Enum):
    RED = "red"
    GREEN = "green"

def show(color):
    match color:
        case Color.RED:
            print("赤です")
        case Color.GREEN:
            print("緑です")
        case _:
            print("知らない色")

show(Color.GREEN)
show(Color("red"))
show("red")
緑です
赤です
知らない色文字列の “red” をそのまま渡すと、普通の Enum のメンバーとは等しくないので「知らない色」になります。外から来た文字列は Color("red") で Enum に変換してから渡します。Enum の詳しい使い方は「PythonのEnum(列挙型)の使い方」を参照してください。Enum を使わない場合も、定数をモジュールにまとめて case config.RED: のようにドット付きで書けば同じように比べられます。
case _: の後ろに別の case を書くと、SyntaxError: wildcard makes remaining patterns unreachable になりました。言語リファレンスにも「何にでも一致する case ブロックは 1 つまでで、最後に置く」とあります。case _: は必ず最後に書きます。
文字列は 1 文字ずつ取り出せるので「シーケンス(並び)」の一種ですが、シーケンスパターンには一致しません。
def first_char(value):
    match value:
        case [first, *_]:
            return f"シーケンス: 先頭は {first!r}"
        case str():
            return f"文字列: {value!r}"
        case _:
            return "その他"

print(first_char("abc"))
print(first_char(list("abc")))
print(first_char(range(3)))
print(first_char(iter([1, 2])))
文字列: 'abc'
シーケンス: 先頭は 'a'
シーケンス: 先頭は 0
その他言語リファレンスには「サブジェクトが str・bytes・bytearray のときはシーケンスパターンは失敗する」とあります。文字列が勝手に 1 文字ずつ分解されないための決まりです。文字列を分けたいときは、コマンドの例のように split() でリストにしてから match に渡します。また、イテレーター(iter(...) やジェネレーター)もシーケンスではないので一致しません。range は一致しました。
case で値が入った変数は、if 文の中で代入した変数と同じく、match 文を抜けたあとも残ります。(1, 2) を case (x, y): に一致させたあとで print(x, y) を実行すると、1 2 と表示されました。同じ名前の変数が外にあると上書きされるので、case の中の変数名は外とぶつからないものにしましょう。
ほかの言語の switch 文を知っている人向けに、違いを表にまとめます(C・Java・JavaScript の古くからある書き方の switch 文との比較です)。
| 項目 | switch 文 | Python の match 文 |
|---|---|---|
| 次の case への流れ込み | break を書かないと起こる | 起こらない(最初に一致した case だけ) |
| どれにも一致しないとき | default: | case _:(なければ何もしない) |
| 複数の値をまとめる | case を縦に並べる | case 1 | 2: |
| 比べられるもの | 主に数値・文字列などの値 | 値に加えて、リスト・辞書・クラスの形 |
| 中身の取り出し | できない | パターンの中の名前に代入される |
| 条件の追加 | できない(if を中に書く) | case x if x > 0: |
「1 つの値を、いくつかの決まった値や形と比べる」なら match 文、「age >= 20 and is_member のように別々の条件を組み合わせる」なら if 文が向いています。比べる値が 2〜3 個しかないなら、if 文のほうが短く、3.9 以前でも動きます。match 文が特に役立つのは、リストや辞書の形を調べながら中身を取り出す場面です。
使えます。match・case・_ はソフトキーワードで、match 文の形のときだけ特別な意味になります。re.match() や match = ... を使った古いコードも、3.12 でそのまま動きました。
match 文は書けないので、if・elif で書きます。シーケンスパターンの代わりは len() と添字、マッピングパターンの代わりは "name" in event や event.get("name")、クラスパターンの代わりは isinstance() です。ファイルの中に match 文が 1 つでもあると、そのファイル全体が読み込めなくなる点に注意してください。引数の型をはっきりさせたいときは「Pythonの型ヒント入門」も参考になります。
| で複数の候補、_ で「それ以外」。case _: は最後に書く[x, *rest] でリストを、{"type": "user", "name": name} で辞書を、Point(x=0, y=y) でオブジェクトを分解できる。辞書の余分なキーは無視されるcase ... if ...:、一致した部分の受け取りは ascase RED: は「何でも一致して代入」になる。定数は Color.RED のようにドット付きで書く