Pythonのテスト入門|unittestとpytestの書き方・実行方法を実例で比較
hr
ENG LIFE BLOG
「並べ替え済みのリストに、順番を崩さずに値を足したい」「点数から A〜F の成績を決めたい」「優先度の高い仕事から 1 つずつ取り出したい」。こうした処理は、Python の標準ライブラリの bisect(バイセクト)と heapq(ヒープキュー)で短く・速く書けます。インストールは要りません。
この記事では、bisect の二分探索・bisect_left と bisect_right の違い・成績判定の定番の書き方と、heapq による「優先度付きキュー」の作り方・つまずきやすい TypeError の避け方を、実行結果つきで説明します。載せている出力は Windows 11・Python 3.12.6 で実際に実行したもので、処理時間は筆者の PC で測った値です(PC によって変わります)。
コードは sample.py などの名前で保存し、PowerShell でそのフォルダーに移動してから次のコマンドで実行できます。
py sample.pyどちらもリストを決まった並び方に保つことで、探す・取り出すを速くする道具ですが、保つ並び方と得意なことが違います。
| bisect | heapq | |
|---|---|---|
| 前提のリスト | 小さい順にきちんと並んだリスト | ヒープ(一番小さい値だけが先頭にある、ゆるい並び) |
| 得意なこと | 値が入る位置を探す、範囲で絞り込む | 一番小さい値を何度も取り出す |
| 主な関数 | bisect_left・bisect_right・insort | heappush・heappop・heapify・nlargest・merge |
| よくある使い道 | 成績・料金の区分け、範囲での絞り込み | 優先度順の仕事の処理、上位 N 件、ソート済みファイルの結合 |
並べ替えそのもの(sorted と key の使い方)は「Pythonのsortedとkey・lambdaで並べ替える」で説明しています。この記事は、並べ替えたあとのデータを速く扱う方法の話です。
bisect は、小さい順に並べ替え済みのリストに値 x を入れるとしたら、何番目に入れれば並びが崩れないか(挿入位置)を返します。返ってくるのは位置を表す数字(インデックス)で、リストそのものは変えません。
import bisect
nums = [10, 20, 30, 40, 50, 60, 70, 80]
i = bisect.bisect_left(nums, 35)
print(i)
nums.insert(i, 35)
print(nums)
print(bisect.bisect_left(nums, 5), bisect.bisect_left(nums, 99))
3
[10, 20, 30, 35, 40, 50, 60, 70, 80]
0 935 は 30 と 40 の間なので位置 3 が返り、そこに insert すれば並びを保ったまま追加できます。どの値より小さい 5 なら 0、どの値より大きい 99 ならリストの長さ(9)です。
bisect は先頭から 1 つずつ比べるのではなく、二分探索で位置を探します。二分探索は「真ん中の値と比べて、答えがある側の半分だけを残す」ことを繰り返す方法です。上の例を図にすると次のようになります。
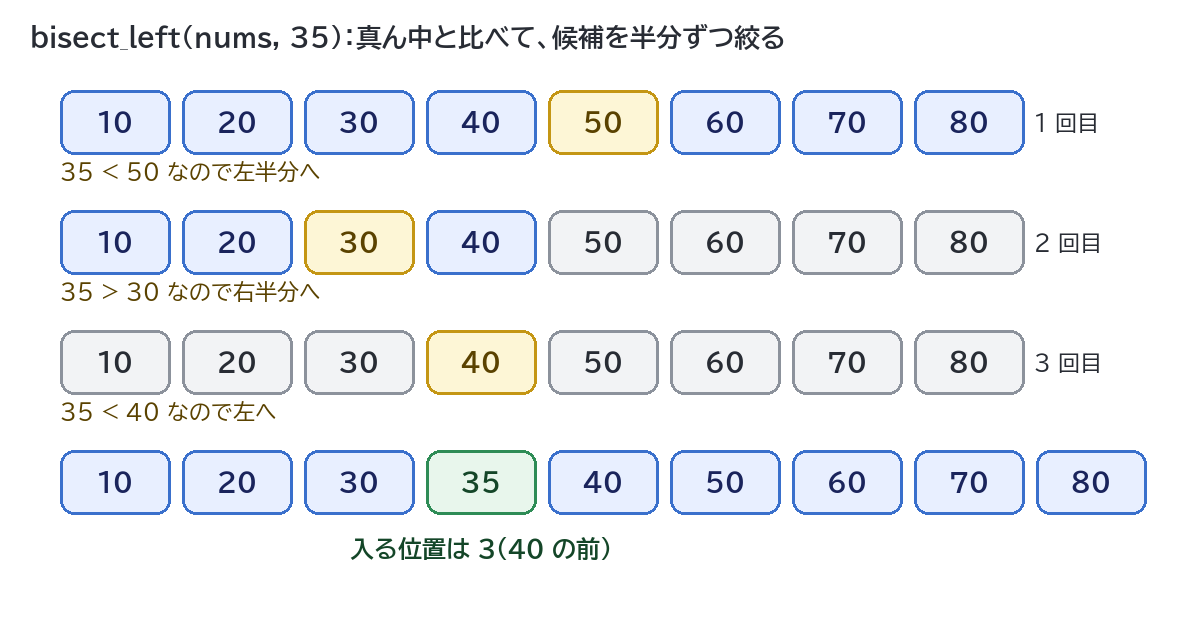
8 個なら 3 回、100 万個でも 20 回ほど比べるだけで位置が決まります(2 の 20 乗が約 105 万のため)。半分ずつに絞る考え方は、壊れたコミットを探す git bisect と同じです(「git blameとgit bisectで原因のコミットを探す方法」)。
ただし、半分を捨ててよいのは「左側はすべて小さく、右側はすべて大きい」と分かっているからです。並べ替えていないリストに使うと、間違った位置が返ります(後の「よくある間違い」で実演します)。
リストに x と同じ値がすでにあるとき、bisect_left は同じ値の左端(前)の位置、bisect_right は同じ値の右端(後ろ)の位置を返します。bisect.bisect は bisect_right の別名です。
import bisect
nums = [10, 20, 30, 30, 30, 40]
print(bisect.bisect_left(nums, 30))
print(bisect.bisect_right(nums, 30))
print(bisect.bisect(nums, 30))
print(bisect.bisect_right(nums, 30) - bisect.bisect_left(nums, 30))
2
5
5
330 は位置 2〜4 に 3 個あります。bisect_left は最初の 30 の位置 2、bisect_right は最後の 30 の次の位置 5 を返します。2 つの差を取ると、その値が何個あるか(ここでは 3 個)が分かります。同じ値がなければ、どちらも同じ位置を返します。
公式ドキュメントの言い方では、bisect_left の位置より左は x より小さい値、bisect_right の位置より左は x 以下の値です。境目の値をどちらの組に入れたいかで使い分けます。
insort(insort_right の別名)は、bisect で位置を探して insert するところまでを 1 回でやります。同じ値があるときは、その後ろに入ります(前に入れたいなら insort_left)。
import bisect
scores = [55, 70, 90]
bisect.insort(scores, 80)
bisect.insort(scores, 60)
bisect.insort(scores, 70)
print(scores)
[55, 60, 70, 70, 80, 90]「60 点未満は F、60 点以上は D、70 点以上は C …」のような区分けは、if を何段も書く代わりに bisect で書けます。公式ドキュメントにも同じ考え方の例があります。境目の点数を小さい順に並べ、bisect(=bisect_right)で位置を求めて、その位置の文字を取り出します。
from bisect import bisect

def grade(score):
    borders = [60, 70, 80, 90]
    return "FDCBA"[bisect(borders, score)]

for s in [0, 59, 60, 69, 70, 85, 90, 100]:
    print(s, grade(s))
0 F
59 F
60 D
69 D
70 C
85 B
90 A
100 Aたとえば 85 点は 80 と 90 の間に入るので位置 3、”FDCBA” の 3 番目(0 から数えて)の B です。ちょうど 60 点や 90 点で上の成績になるのは、bisect_right が同じ値の後ろの位置を返すからです。bisect_left にすると 60 点が F、90 点が B になり、「60 点以上は D」とずれます。境目ちょうどの値で確かめるのがテストのこつです。
Python 3.10 から、bisect の関数に key 引数を渡せるようになりました。タプルや辞書のリストを、ある項目で並べている場合に便利です。
import bisect
members = [("佐藤", 25), ("鈴木", 31), ("高橋", 42)]
i = bisect.bisect_left(members, 31, key=lambda m: m[1])
print(i, members[i])
bisect.insort(members, ("田中", 35), key=lambda m: m[1])
print(members)
1 ('鈴木', 31)
[('佐藤', 25), ('鈴木', 31), ('田中', 35), ('高橋', 42)]注意点として、公式ドキュメントによると bisect_left などでは key は探す値 x には使われません。x にはタプルではなく、比べる値そのもの(年齢 31)を渡します。一方 insort では、key は x にも使われてから位置が決まり、リストには x そのもの((“田中”, 35))が入ります。また、リストはその key の順に並んでいる必要があります。
値がリストにあるかどうかは x in リスト でも調べられます。ただし in は先頭から順番に比べるので、要素数に比例して時間がかかります。並べ替え済みのリストなら、bisect で位置を求め、その位置の値が x と等しいかを見れば同じことが分かります(下の by_bisect)。
位置がリストの長さと同じ(x がすべての値より大きい)ときは nums[i] がエラーになるので、先に i < len(nums) を確かめます。100 万件のリストで、最後のほうにある値を探して比べました。測り方は「Pythonで処理時間を測る方法」で説明している timeit.repeat を使い、100 回の平均の最小値を出しています。
import bisect
import timeit

nums = list(range(0, 2_000_000, 2))
target = 1_999_998

def by_in():
    return target in nums

def by_bisect():
    i = bisect.bisect_left(nums, target)
    return i < len(nums) and nums[i] == target

print(len(nums), by_in(), by_bisect())
t_in = min(timeit.repeat(by_in, number=100, repeat=5)) / 100
t_bi = min(timeit.repeat(by_bisect, number=100, repeat=5)) / 100
print(f"in     : {t_in * 1e6:10.2f} マイクロ秒")
print(f"bisect : {t_bi * 1e6:10.2f} マイクロ秒")
print(f"約 {t_in / t_bi:,.0f} 倍")
1000000 True True
in : 3408.32 マイクロ秒
bisect : 0.15 マイクロ秒
約 22,722 倍in は 1 回あたり約 3.4 ミリ秒(3,408 マイクロ秒)、bisect は 0.15 マイクロ秒でした(筆者の PC の値。2 回測ってほぼ同じ)。in は探す値が後ろのほうや「ない値」ほど遅くなります。
なお、あるかないかだけなら set(集合)も速く、同じ 100 万件で set の in は 0.03 マイクロ秒でした(ただし set を作るのに約 23 ミリ秒)。範囲での検索や「何番目か」が必要なら bisect を使います。
公式ドキュメントには、insort について「O(log n) の探索は、遅い O(n) の挿入の手順に左右される」と書かれています。O(n) は要素数に比例して時間がかかること、O(log n) は要素数が倍になっても 1 手順しか増えないことです。リストの途中に入れると、後ろの要素をすべて 1 つずつずらすためです。
import bisect
import timeit

nums = list(range(1, 2_000_001, 2))

def search_only():
    bisect.bisect(nums, 0)

def insort_head():
    bisect.insort(nums, 0)

def insort_tail():
    bisect.insort(nums, 3_000_000)

for name, fn in [("bisect で探すだけ", search_only),
                 ("insort で先頭に追加", insort_head),
                 ("insort で末尾に追加", insort_tail)]:
    t = min(timeit.repeat(fn, number=100, repeat=5)) / 100
    print(f"{name}: {t * 1e6:8.2f} マイクロ秒")
bisect で探すだけ: 0.11 マイクロ秒
insort で先頭に追加: 186.01 マイクロ秒
insort で末尾に追加: 0.10 マイクロ秒探すだけなら 0.11 マイクロ秒ですが、先頭に入れると 100 万個をずらすので約 186 マイクロ秒と、1,000 倍以上かかりました(末尾に入れるときはずらす要素がないので速いままです)。大量のデータに insort を何万回も繰り返すなら、まとめて追加してから 1 回 sort() するほうが速いことがあります。先頭への出し入れの遅さは、collections の記事で list.pop(0) と deque を比べたときと同じ理由です。
「締め切りの近い仕事から順に片付けたい」のように、今ある中で一番小さい値(優先度の高いもの)を取り出すことを繰り返す入れ物を、優先度付きキューと呼びます。heapq は、普通のリストをヒープという形に保つことで、これを速く行う関数を集めたモジュールです。
ヒープは、リストの k 番目を「親」、2k+1 番目と 2k+2 番目を「子」と見て、どの親も自分の子以下になるように並べたものです(公式ドキュメントの言い方では heap[k] <= heap[2*k+1] かつ heap[k] <= heap[2*k+2])。この決まりがあるので、一番小さい値はいつも先頭の heap[0] にあります。
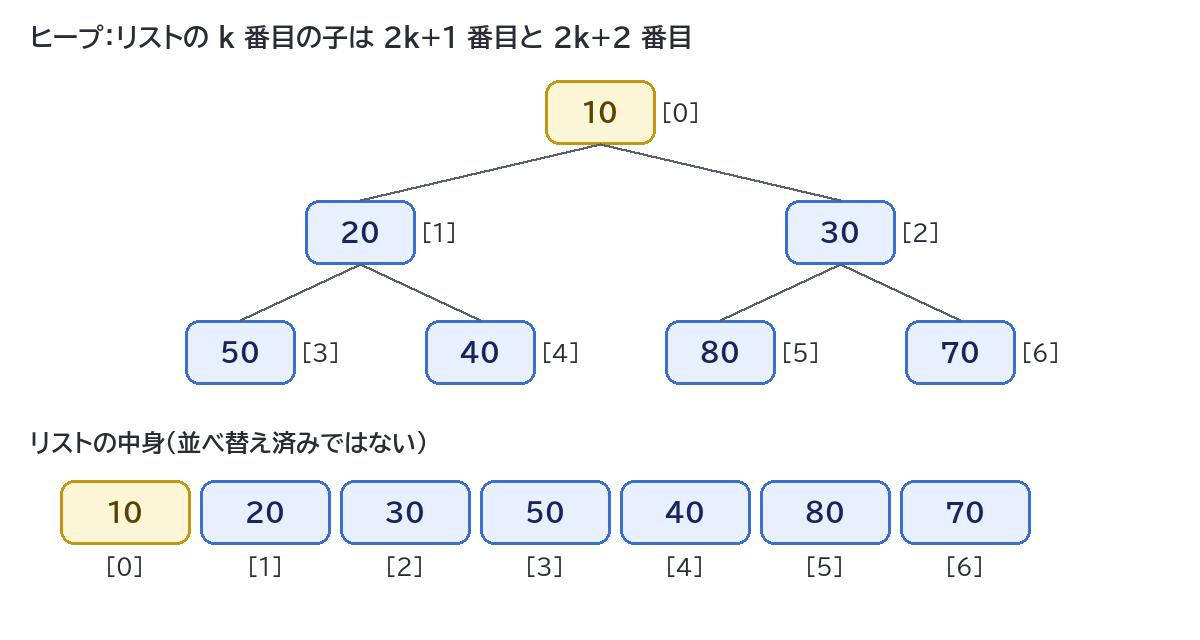
きちんと並べ替えず「親が子以下」だけを守るので、値を足したり取り出したりしたときに直すのは木の 1 本の道だけで済みます(100 万件でも 20 段ほど)。
空のリストから始め、heappush(リスト, 値) で追加し、heappop(リスト) で一番小さい値を取り出します。リストは普通の list なので、中身を print で見ることもできます。
import heapq
heap = []
for n in [50, 20, 80, 10, 40]:
    heapq.heappush(heap, n)
    print(heap)
print(heap[0])
print(heapq.heappop(heap), heap)
print(heapq.heappop(heap), heap)
[50]
[20, 50]
[20, 50, 80]
[10, 20, 80, 50]
[10, 20, 80, 50, 40]
10
10 [20, 40, 80, 50]
20 [40, 50, 80]heappop は先頭の 10 を返し、残りを「親が子以下」の形に直すので、取り出すたびに次に小さい値が先頭に来ます。ただしリスト全体は小さい順には並んでいません([10, 20, 80, 50, 40] のように)。heap[:3] が小さい順の 3 件とは限らず、heap[-1] が最大とも限らないので、小さい順の N 件が欲しいなら nsmallest か、heappop を N 回使います。
すでに値の入ったリストがあるなら、1 つずつ heappush する代わりに heapify(リスト) でまとめてヒープにできます。公式ドキュメントによると、heapify は元のリストをその場で書き換え、線形時間(要素数に比例する時間)で終わります。
import heapq
nums = [50, 20, 80, 10, 40, 30, 70]
heapq.heapify(nums)
print(nums)
while nums:
    print(heapq.heappop(nums), end=" ")
print()
[10, 20, 30, 50, 40, 80, 70]
10 20 30 40 50 70 80heapify したあとのリストは [10, 20, 30, 50, 40, 80, 70] で、これが図 2 のヒープです。heappop を繰り返すと、小さい順に取り出せます。
heapq は最小値を取り出すしくみです。Python 3.12 の heapq には、最大値を取り出す公開の関数はありません(公式ドキュメントによると、heappush_max などの最大ヒープ用の関数は Python 3.14 で追加されました)。3.13 までは、数値なら マイナスを付けて入れ、取り出したらマイナスを付けて戻すのが定番です。
import heapq
heap = []
for n in [50, 20, 80, 10, 40]:
    heapq.heappush(heap, -n)
print(heap)
print(-heapq.heappop(heap))
print(-heapq.heappop(heap))
[-80, -40, -50, -10, -20]
80
50-80 が一番小さいので先頭に来ます。取り出した -80 にマイナスを付けると 80、つまり一番大きい値になります。文字列のようにマイナスを付けられない値なら、あとで説明する nlargest を使うか、優先度の数値を別に用意してタプルにします。
データに優先度を付けるときは (優先度, データ) のタプルにして入れます。タプルは先頭の値から順に比べられるので、優先度の小さい順に取り出せます。ところが、優先度が同じものがあると、2 番目のデータどうしを比べようとして TypeError になることがあります。
import heapq
from dataclasses import dataclass

@dataclass
class Task:
    name: str

heap = []
heapq.heappush(heap, (1, Task("障害対応")))
heapq.heappush(heap, (2, Task("メール返信")))
heapq.heappush(heap, (2, Task("日報")))
print("3 件目まで入った")
heapq.heappush(heap, (1, Task("顧客への連絡")))
3 件目まで入った
Traceback (most recent call last):
File "C:\...\sample.py", line 13, in <module>
heapq.heappush(heap, (1, Task("顧客への連絡")))
TypeError: '<' not supported between instances of 'Task' and 'Task'(File の行のフォルダー名は省略しています。)Task は名前を持つだけの dataclass で、大小の比べ方が決まっていません。優先度 2 の仕事が 2 つ入った時点ではエラーにならず、4 件目で初めて落ちています。heappush は新しい値を木の上の親たちとだけ比べるので、優先度が同じものどうしが実際に比べられたときだけエラーになります。データの順番次第で出たり出なかったりするので、テストをすり抜けやすい間違いです。
公式ドキュメントの「優先度付きキューの実装メモ」で紹介されている方法は、優先度とデータの間に追加した順の連番をはさむことです。連番はすべて違う値なので、優先度が同じでも連番で順番が決まり、データどうしが比べられることはありません。連番は itertools.count() で作れます。
import heapq
import itertools
from dataclasses import dataclass

@dataclass
class Task:
    name: str

counter = itertools.count()
heap = []
for priority, name in [(2, "メール返信"), (1, "障害対応"), (2, "日報"), (3, "資料整理"), (1, "顧客への連絡")]:
    heapq.heappush(heap, (priority, next(counter), Task(name)))

while heap:
    priority, seq, task = heapq.heappop(heap)
    print(priority, seq, task.name)
1 1 障害対応
1 4 顧客への連絡
2 0 メール返信
2 2 日報
3 3 資料整理優先度 1 の 2 件は「障害対応」「顧客への連絡」の順、優先度 2 の 2 件は「メール返信」「日報」の順で、同じ優先度の中では入れた順に出てきます。連番にはエラーを防ぐことに加えて、入れた順を守る役目もあります。itertools.count の使い方は「Pythonのitertools入門」も参考にしてください。
「上位 3 件」のように一部だけ欲しいときは、nlargest(n, 並び) と nsmallest(n, 並び) が使えます(key も指定できます)。公式ドキュメントによると、nlargest は sorted(並び, key=key, reverse=True)[:n] と同じ結果になります。また「n が小さいときに一番よく働き、大きいときは sorted のほうが効率的。n が 1 なら min・max のほうが効率的」とも書かれています。100 万個の小数で実際に比べてみました。
import heapq
import random
import timeit

random.seed(1)
data = [random.random() for _ in range(1_000_000)]

for n in [1, 10, 1000, 100_000]:
    t_heap = min(timeit.repeat(lambda: heapq.nlargest(n, data), number=3, repeat=3)) / 3
    t_sort = min(timeit.repeat(lambda: sorted(data, reverse=True)[:n], number=3, repeat=3)) / 3
    print(f"n={n:>7,}  nlargest: {t_heap * 1e3:6.1f} ミリ秒  sorted: {t_sort * 1e3:6.1f} ミリ秒")

t_max = min(timeit.repeat(lambda: max(data), number=3, repeat=3)) / 3
print(f"max(data): {t_max * 1e3:6.1f} ミリ秒")
n= 1 nlargest: 4.9 ミリ秒 sorted: 140.2 ミリ秒
n= 10 nlargest: 9.2 ミリ秒 sorted: 139.3 ミリ秒
n= 1,000 nlargest: 10.9 ミリ秒 sorted: 141.7 ミリ秒
n=100,000 nlargest: 213.6 ミリ秒 sorted: 140.8 ミリ秒
max(data): 5.0 ミリ秒筆者の PC では、上位 10 件や 1,000 件なら nlargest が sorted の 10 倍以上速く、10 万件(全体の 1 割)では逆に sorted のほうが速くなりました。n が全体よりずっと小さいなら nlargest・nsmallest、n が大きいなら sorted、1 件なら max・min が目安です。
heapq.merge は、それぞれ小さい順に並んだ複数のリスト(やファイルの行)を、全体として小さい順になるようにつなぎます。公式ドキュメントでは、時刻つきの複数のログファイルをまとめる用途が例に挙がっています。
import heapq
log_a = ["09:00 A 起動", "09:30 A 受付", "10:10 A 終了"]
log_b = ["09:05 B 起動", "09:40 B 受付", "10:00 B 終了"]
for line in heapq.merge(log_a, log_b):
    print(line)
print(type(heapq.merge(log_a, log_b)))
09:00 A 起動
09:05 B 起動
09:30 A 受付
09:40 B 受付
10:00 B 終了
10:10 A 終了
<class 'generator'>先頭の時刻の文字列で比べられ、A と B のログが時刻順に交互に並びました。sorted(log_a + log_b) と結果は同じですが、merge は全部を一度に読み込まず、必要になった分だけ順に取り出します(戻り値が generator なのはそのためです)。大きなファイルを行ごとに読むときに向いています。ただし、それぞれの入力がすでに小さい順に並んでいることが前提です。
bisect は「並べ替え済み」を前提に半分を捨てていくので、並んでいないリストに使ってもエラーにはならず、黙って間違った結果を返します。
import bisect
nums = [30, 10, 50, 20, 40]
i = bisect.bisect_left(nums, 20)
print(i)
print(i < len(nums) and nums[i] == 20)
print(20 in nums)
nums.sort()
i = bisect.bisect_left(nums, 20)
print(i, nums[i] == 20)
2
False
True
1 True[30, 10, 50, 20, 40] には 20 が入っていますが、bisect では「ない」と判定されました。最初に真ん中の 50 と比べた時点で「20 は 50 より小さいから右半分にはない」と判断し、実際に 20 がある右半分を捨ててしまうからです。sort() してからなら正しく見つかります。append で値を足すと並びが崩れるので、追加には insort を使うか、bisect の前に並べ替えます。
heappop は「リストがヒープになっている」ことを前提にしています。普通のリストに使うと、やはりエラーにならずに間違った値が返ります。
import heapq
nums = [50, 20, 80, 10, 40]
print(heapq.heappop(nums))
print(nums)
50
[20, 10, 80, 40]一番小さい 10 ではなく、先頭にあった 50 が返ってきました。値の入ったリストを使うときは、先に heapify します。
PriorityQueue も優先度付きキューで、公式ドキュメントによると中では heapq を使っています。queue モジュールは複数のスレッド(同時に動く処理)の間で安全にデータを受け渡すためのもので、ロック(同時に書き換えないしくみ)が組み込まれています。スレッドを使わない普通のプログラムなら、heapq で十分です。