Pythonのwith文とは?コンテキストマネージャーの仕組みと作り方
hr
ENG LIFE BLOG
Python で「2 つのリストを順番に処理したい」「日付ごとにまとめたい」「全部の組み合わせを試したい」「1,000 件ずつに分けて処理したい」と思ったとき、for 文を何重にも書く前に試してほしいのが標準ライブラリの itertools(イターツールズ)です。インストール不要で、import するだけで使えます。
この記事では、まず組み込み関数の enumerate と zip を短く復習し、そのあと itertools の chain・islice・groupby・product・permutations・combinations・accumulate・count・cycle・pairwise・batched を実例で説明します。特に、groupby は先に並べ替えないと同じグループが分かれること、イテレーターは一度使うと空になることは、実際の出力で確かめます。載せている出力は、Windows 11・Python 3.12.6 で実際に実行したものです。
itertools は、「繰り返し(ループ)で使う値の並び」を作ったり加工したりする関数を集めたモジュールです。公式ドキュメントでは、高速でメモリ効率のよい道具の集まりで、組み合わせて使うことで目的に合った処理を短く書ける(「イテレーター代数」)と説明されています。
ここで大事なのがイテレーターという言葉です。イテレーターは「次の値を 1 つずつ取り出せるもの」で、リストのように全部の値を先にメモリに並べておくのではなく、求められたときに 1 つずつ作ります。そのため、何百万通りもの組み合わせでもメモリをほとんど使わずに順番に処理できます。その代わり、次の 2 つの性質があります。
print() しても中身は表示されない(list() に入れると中身が見える)この記事のコードは、出力を見やすくするために list() で囲んで表示しています。実際のプログラムでは、for 文でそのまま回せば list にする必要はありません。コードは sample.py などの名前で保存し、PowerShell でそのフォルダーに移動してから次のコマンドで実行できます。
py sample.pyitertools の前に、import なしで使える 2 つの関数を確認します。enumerate() は「番号と値」の組を、zip() は「複数の並びから 1 つずつ取った組」を作ります。どちらもイテレーターを返します。
names = ["田中", "鈴木", "佐藤"]
scores = [72, 95, 88]
for i, name in enumerate(names, start=1):
    print(i, name)
for name, score in zip(names, scores):
    print(name, score)
print(list(zip(names, [72, 95])))
1 田中
2 鈴木
3 佐藤
田中 72
鈴木 95
佐藤 88
[('田中', 72), ('鈴木', 95)]enumerate の番号は 0 から始まりますが、start=1 で 1 から始められます。注意したいのは最後の行です。zip はいちばん短い並びが終わったところで黙って止まるため、点数が 2 つしかないと佐藤さんが何も言われずに消えます。
長さが同じはずの並びを組み合わせるときは、Python 3.10 で追加された strict=True を付けると、長さが違ったときにエラーで止まります。公式ドキュメントでも、長さが同じ前提の場面ではこの指定がすすめられています。
names = ["田中", "鈴木", "佐藤"]
for name, score in zip(names, [72, 95], strict=True):
    print(name, score)
田中 72
鈴木 95
Traceback (most recent call last):
...
ValueError: zip() argument 2 is shorter than argument 1エラーは、短いほうが尽きたことに気づいた時点で出るため、それまでの 2 行は表示されています。逆に「足りない分は埋めて最後まで組みたい」ときは、itertools の zip_longest() を使います。足りない値は None(fillvalue=0 を指定すれば 0)になります。
from itertools import zip_longest
print(list(zip_longest("ABC", [1, 2])))
print(list(zip_longest("ABC", [1, 2], fillvalue=0)))
[('A', 1), ('B', 2), ('C', None)]
[('A', 1), ('B', 2), ('C', 0)]chain(a, b, c) は、a を最後まで出したら b、b が終わったら c と、続けて 1 本の並びとして返します。リストどうしなら a + b でもつなげますが、chain はリスト・タプル・文字列など型が違っても使え、新しい大きなリストを作りません。リストの中のリスト(二次元リスト)を平らにするには chain.from_iterable() を使います。
from itertools import chain
a = [1, 2]
b = (3, 4)
c = "ab"
print(list(chain(a, b, c)))
rows = [[1, 2], [3], [4, 5, 6]]
print(list(chain.from_iterable(rows)))
print(chain(a, b))
[1, 2, 3, 4, 'a', 'b']
[1, 2, 3, 4, 5, 6]
<itertools.chain object at 0x000002B3F3A73370>最後の行のように、list にしないで print すると「chain オブジェクト」とだけ表示されます(16 進数の部分は実行するたびに変わります)。これは壊れているのではなく、まだ値を作っていないだけです。
リストなら nums[10:15] のようにスライスで切り出せますが、イテレーターやファイルには [ ] が使えません。そこで使うのが islice(並び, 終了)、islice(並び, 開始, 終了, 間隔) です。番号の数え方はスライスと同じで、終了の番号は含まれません。
from itertools import islice
nums = range(100)
print(list(islice(nums, 5)))
print(list(islice(nums, 10, 15)))
print(list(islice(nums, 0, 10, 3)))
[0, 1, 2, 3, 4]
[10, 11, 12, 13, 14]
[0, 3, 6, 9]実用的なのは、大きなファイルの一部だけを読む使い方です。ファイルを開いたものは「1 行ずつ取り出せるイテレーター」なので、次のように書くと 1 行目(見出し)を飛ばして 2〜4 行目だけを読み、残りは読み込みません。members.csv は「id,name」の見出しのあとに 5 人分の行がある UTF-8 のファイルです。
from itertools import islice
with open("members.csv", encoding="utf-8") as f:
    for line in islice(f, 1, 4):
        print(line.rstrip("\n"))
1,田中
2,鈴木
3,佐藤公式ドキュメントにあるとおり、islice はマイナスの番号に対応していません。「最後の 3 つ」のつもりで islice(range(10), -3, None) と書くと、次のエラーになります。イテレーターは最後まで読まないと長さが分からないためです。最後の何件かが欲しいときは、list にしてから [-3:] で取り出します。
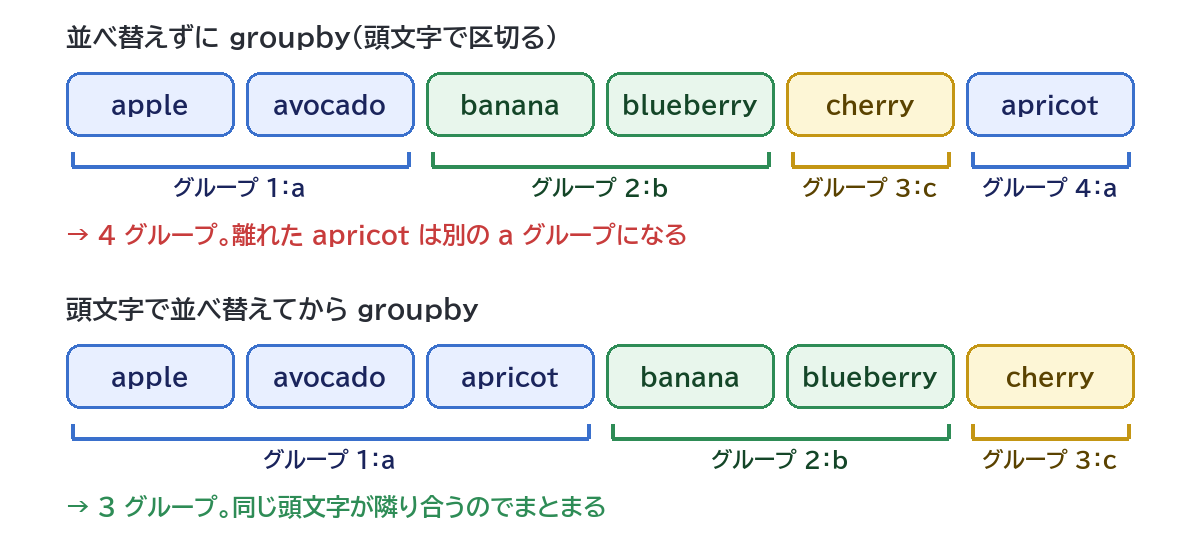
ValueError: Indices for islice() must be None or an integer: 0 <= x <= sys.maxsize.groupby(並び, key=関数) は、key 関数の結果が同じものをまとめて、「キー」と「そのグループの値」を順に返します。ただし、まとめるのは隣り合っているものだけです。公式ドキュメントにも「key 関数の値が変わるたびに新しいグループを作るので、ふつうは同じ key 関数で並べ替えておく必要がある」と書かれています。実際に、頭文字でまとめてみます。
from itertools import groupby
words = ["apple", "avocado", "banana", "blueberry", "cherry", "apricot"]
for key, group in groupby(words, key=lambda w: w[0]):
    print(key, list(group))
print("--- 並べ替えてから ---")
words.sort(key=lambda w: w[0])
for key, group in groupby(words, key=lambda w: w[0]):
    print(key, list(group))
a ['apple', 'avocado']
b ['banana', 'blueberry']
c ['cherry']
a ['apricot']
--- 並べ替えてから ---
a ['apple', 'avocado', 'apricot']
b ['banana', 'blueberry']
c ['cherry']並べ替える前は、最後の apricot が a の 2 つ目のグループとして別に出てきました。groupby は前から順に見て「キーが変わったら区切る」だけなので、離れた場所にある同じキーは別のグループになります。lambda w: w[0] は「文字列の 1 文字目を返す」小さな関数で、並べ替えにも groupby にも同じものを渡すのがポイントです。
実務でよくあるのは、売上データを日付ごとに集計する例です。辞書の値で並べ替え・まとめるときは、operator.itemgetter("date")(lambda r: r["date"] と同じ意味)が便利です。
from itertools import groupby
from operator import itemgetter
sales = [
    {"date": "2026-10-02", "item": "ペン", "price": 120},
    {"date": "2026-10-01", "item": "ノート", "price": 200},
    {"date": "2026-10-02", "item": "消しゴム", "price": 80},
    {"date": "2026-10-01", "item": "ペン", "price": 120},
]
sales.sort(key=itemgetter("date"))
for date, rows in groupby(sales, key=itemgetter("date")):
    rows = list(rows)
    total = sum(r["price"] for r in rows)
    print(date, len(rows), "件", total, "円")
2026-10-01 2 件 320 円
2026-10-02 2 件 200 円ループの中で rows = list(rows) としているのは、件数(len)と合計(sum)で 2 回使うためです。グループもイテレーターなので、list にしないと 1 回目の処理で空になります。並べ替えができない・したくない場合や、件数を数えたいだけの場合は、辞書や collections の Counter・defaultdict を使うほうが向いています。
「全部の組み合わせを試す」処理は、for 文を入れ子にすると深くなりがちです。itertools の 3 つの関数を使うと 1 行で書けます。
from itertools import product, permutations, combinations, combinations_with_replacement
sizes = ["S", "M"]
colors = ["白", "黒", "赤"]
print(list(product(sizes, colors)))
print(list(product([0, 1], repeat=3)))
print(list(permutations("ABC", 2)))
print(list(combinations("ABC", 2)))
print(list(combinations_with_replacement("ABC", 2)))
[('S', '白'), ('S', '黒'), ('S', '赤'), ('M', '白'), ('M', '黒'), ('M', '赤')]
[(0, 0, 0), (0, 0, 1), (0, 1, 0), (0, 1, 1), (1, 0, 0), (1, 0, 1), (1, 1, 0), (1, 1, 1)]
[('A', 'B'), ('A', 'C'), ('B', 'A'), ('B', 'C'), ('C', 'A'), ('C', 'B')]
[('A', 'B'), ('A', 'C'), ('B', 'C')]
[('A', 'A'), ('A', 'B'), ('A', 'C'), ('B', 'B'), ('B', 'C'), ('C', 'C')]| 関数 | 作るもの | 順番の違い | 同じ要素の重複 | 上の例の数 |
|---|---|---|---|---|
product(A, B) | A と B から 1 つずつ取った全組(for の入れ子と同じ) | 区別する | あり | 2×3=6 |
product(A, repeat=3) | product(A, A, A) と同じ | 区別する | あり | 2×2×2=8 |
permutations(A, 2) | 順列(並べ方) | 区別する(AB と BA は別) | なし | 3×2=6 |
combinations(A, 2) | 組み合わせ(選び方) | 区別しない(AB だけ) | なし | 3 |
combinations_with_replacement(A, 2) | 同じものを何度選んでもよい組み合わせ | 区別しない | あり(AA など) | 6 |
product([0, 1], repeat=3) は 3 ビットの 0 と 1 の全パターンになるので、テストの入力を総当たりで作るときに便利です。「総当たりで何通りになるか」は、作る前に math モジュールで計算できます。math.perm(5, 3) は 60、math.comb(5, 3) は 10 で、実際に len(list(permutations(range(5), 3))) などで数えた結果と一致しました。
注意したいのは、数がすぐに大きくなることです。たとえば 50 個から 5 個を選ぶ組み合わせは math.comb(50, 5) で 2,118,760 通り、英小文字 8 文字の全パターン(product(string.ascii_lowercase, repeat=8))は 26 の 8 乗で 208,827,064,576 通りです。イテレーターのまま 1 つずつ処理すればメモリは足りても、list() で全部をリストにするとメモリが足りなくなったり、ループが終わらなかったりします。
もう 1 つ、値が同じでも位置が違えば別のものとして扱われます(公式ドキュメントにも「値ではなく位置で区別する」とあります)。重複を除きたいときは set に入れます。
from itertools import combinations
print(list(combinations([1, 1, 2], 2)))
print(set(combinations([1, 1, 2], 2)))
[(1, 1), (1, 2), (1, 2)]
{(1, 1), (1, 2)}accumulate() は「ここまでの合計」を順に返します。日ごとの売上から累計売上を作るような処理が 1 行で書けます。2 つ目の引数に関数を渡すと、合計以外の積み重ねもできます。
from itertools import accumulate
import operator
sales = [120, 80, 200, 50]
print(list(accumulate(sales)))
print(list(accumulate(sales, initial=0)))
print(list(accumulate([3, 1, 4, 1, 5, 9, 2], max)))
print(list(accumulate([1, 2, 3, 4], operator.mul)))
[120, 200, 400, 450]
[0, 120, 200, 400, 450]
[3, 3, 4, 4, 5, 9, 9]
[1, 2, 6, 24]initial=0(Python 3.8 で追加)を付けると、先頭に初期値が入り、要素が 1 つ増えるmax を渡すと「ここまでの最大値」になる(最高記録の推移など)operator.mul(かけ算)を渡すと 1、1×2、1×2×3…の累積の積になるcount() は 0(または指定した数)から 1 ずつ増える数を、cycle() は渡した並びを先頭に戻りながら繰り返し返します。どちらも終わりがありません。list(count()) や for x in cycle(...) を止める条件なしに書くと、プログラムが終わらなくなります(PowerShell では Ctrl+C で止められます)。必ず break・islice・zip のどれかで止めます。
from itertools import count, cycle, repeat, islice
for n in count(1):
    if n > 3:
        break
    print(n)
print(list(islice(count(10, 5), 4)))
print(list(zip(count(1), ["a", "b", "c"])))
print(list(islice(cycle(["赤", "青"]), 5)))
members = ["田中", "鈴木", "佐藤", "高橋", "伊藤"]
print(list(zip(members, cycle(["A班", "B班"]))))
print(list(repeat("x", 3)))
1
2
3
[10, 15, 20, 25]
[(1, 'a'), (2, 'b'), (3, 'c')]
['赤', '青', '赤', '青', '赤']
[('田中', 'A班'), ('鈴木', 'B班'), ('佐藤', 'A班'), ('高橋', 'B班'), ('伊藤', 'A班')]
['x', 'x', 'x']count(10, 5) は 10 から 5 ずつ増えます。zip は短いほうで止まるので、終わりのない count や cycle と組み合わせると「メンバーの人数分だけ」で自然に止まります。メンバーを A 班・B 班に交互に振り分ける例のように、cycle は「順番に割り当てる」処理に向いています。repeat("x", 3) は同じ値を 3 回返します(回数を省くと終わりなく繰り返します)。
公式ドキュメントによると、pairwise() は Python 3.10、batched() は Python 3.12 で追加されました。古い Python では import の時点でエラーになるので、使う前に py --version でバージョンを確かめてください。
from itertools import pairwise, batched
temps = [18, 21, 19, 24]
print(list(pairwise(temps)))
print([b - a for a, b in pairwise(temps)])
print(list(pairwise("ABCD")))
ids = list(range(1, 11))
for batch in batched(ids, 4):
    print(batch)
[(18, 21), (21, 19), (19, 24)]
[3, -2, 5]
[('A', 'B'), ('B', 'C'), ('C', 'D')]
(1, 2, 3, 4)
(5, 6, 7, 8)
(9, 10)pairwise() は「隣どうしのペア」を返します。前日との気温の差のように、1 つ前の値と比べる処理を for i in range(len(temps) - 1) と番号で書かずに済みます。要素が 4 つならペアは 3 つです。
batched(並び, n) は n 個ずつのタプルに分けます。割り切れないときは最後のタプルが短くなります(上の例では (9, 10))。API に 100 件ずつ送る、データベースに 1,000 行ずつ書き込むといった「まとめて処理」に使えます。CSV を読みながら 2 件ずつ処理すると、次のようになります(members.csv は islice の例と同じファイルです)。
import csv
from itertools import batched
with open("members.csv", encoding="utf-8", newline="") as f:
    reader = csv.DictReader(f)
    for batch in batched(reader, 2):
        names = [row["name"] for row in batch]
        print(len(batch), names)
2 ['田中', '鈴木']
2 ['佐藤', '高橋']
1 ['伊藤']なお、最後が短いときにエラーにする strict=True は Python 3.13 で追加されたオプションです。3.12 で batched("ABCDEFG", 3, strict=True) と書くと、TypeError: batched() takes at most 2 arguments (3 given) になりました。
いちばん多いつまずきです。イテレーターは最後まで取り出すと空になり、巻き戻せません。
nums = iter([1, 2, 3])
print(sum(nums))
print(sum(nums))
z = zip("abc", [1, 2, 3])
print(list(z))
print(list(z))
6
0
[('a', 1), ('b', 2), ('c', 3)]
[]2 回目の sum は 0、2 回目の list は空です。エラーにならないので気づきにくく、「件数を数えてから for で回したら何も処理されなかった」という形で現れます。何度も使うなら、最初に items = list(z) のようにリストにして、リストのほうを使い回します。なお、range() やリスト自体はイテレーターではないので、何度ループしても空になりません。
groupby のグループは、元の並びを groupby と共有しています。公式ドキュメントにあるとおり、groupby が次のグループに進むと前のグループは見えなくなります。グループをいったん保存してから中身を見ると、空になります。
from itertools import groupby
data = [1, 1, 2, 2, 2, 3]
saved = [(k, g) for k, g in groupby(data)]
for k, g in saved:
    print(k, list(g))
print([(k, list(g)) for k, g in groupby(data)])
print([(k, len(list(g))) for k, g in groupby("AAABBC")])
1 []
2 []
3 []
[(1, [1, 1]), (2, [2, 2, 2]), (3, [3])]
[('A', 3), ('B', 2), ('C', 1)]直し方は、ループの中ですぐに list(g) にすることです。最後の行は、同じ文字が何個続いているかを数える例です(key を省くと値そのものでまとめます)。
イテレーターには長さも番号もありません。c = combinations("ABC", 2) に対して len(c) や c[0] と書くと、それぞれ次のエラーになります。
TypeError: object of type 'itertools.combinations' has no len()
TypeError: 'itertools.combinations' object is not subscriptable
件数だけなら math.comb などで計算し、中身を番号で取り出したいなら list にします。最初の 1 つだけなら next(c) でも取り出せます。
前半の実演のとおり、並べ替えないと同じキーのグループが複数できます。並べ替えはしていても、基準が違うとまとまりません。先ほどの売上データを、商品名(item)で並べ替えてから日付(date)で groupby すると、次のように同じ日付が 2 回ずつ出てきます。
sales.sort(key=itemgetter("item"))
for date, rows in groupby(sales, key=itemgetter("date")):
    print(date, [r["item"] for r in rows])
2026-10-01 ['ノート']
2026-10-02 ['ペン']
2026-10-01 ['ペン']
2026-10-02 ['消しゴム']sort の key と groupby の key には同じ関数を渡す、と覚えておくと安全です。
batched は 3.12、pairwise は 3.10 からの関数なので、それより古い Python では import の時点で ImportError: cannot import name 'batched' from 'itertools' のようなエラーになります(Python 3.12 で、存在しない名前を itertools から import したときに出るエラーの形から確認しました。古い Python そのものでは試していません)。サーバーや CI(自動テストの環境)の Python が手元より古いことがよくあります。複数の Python で動かすコードでは、使う前に実行環境のバージョンを確認してください。
「1 つの並びの各要素を変換・絞り込む」だけなら内包表記で十分です。「複数の並びをつなぐ・組み合わせる」「途中で区切る・まとめる」「隣と比べる」といった処理は itertools のほうが短く、間違いも起きにくくなります。両方を組み合わせて [b - a for a, b in pairwise(temps)] のように書くのもよくある形です。
strict=True(3.10 以降)