Pythonのmatch文の使い方|パターンマッチとcase RED:の落とし穴
hr
ENG LIFE BLOG
Python で「点数の高い順に並べたい」「辞書のリストを年齢順にしたい」「部署ごと・点数順に並べたい」と思ったときに使うのが、組み込み関数の sorted() とリストの sort() メソッドです。key 引数と lambda(ラムダ)が分かると、並べられるものが一気に増えます。
この記事では、sorted と sort の違い、key と lambda の使い方、複数の条件での並べ替え、安定ソート、そして「”10″ が “9” より前に来る」「None が混ざるとエラー」「日本語があいうえお順にならない」といったつまずきやすい点を、実行結果つきで説明します。載せている出力は、Windows 11・Python 3.12.6 で実際に実行したものです。
コードは sample.py などの名前で保存し、PowerShell でそのフォルダーに移動してから次のコマンドで実行できます。
py sample.pysorted(並び) は並べ替えた新しいリストを返し、元のデータは変えません。リスト.sort() は元のリストそのものを並べ替え(書き換え)、戻り値は None です。None は「何もない」を表す Python の値です。
scores = [72, 95, 88, 60]
result = sorted(scores)
print(result)
print(scores)
scores.sort()
print(scores)
[60, 72, 88, 95]
[72, 95, 88, 60]
[60, 72, 88, 95]sorted のあとも scores は元の順番のままで、sort を呼んだあとで初めて scores 自体が並び替わっています。
sort の戻り値は None なので、結果を同じ変数に入れ直すとリストが None で上書きされます。
scores = [72, 95, 88, 60]
scores = scores.sort()
print(scores)
print(scores[0])
None
Traceback (most recent call last):
File "C:\...\sample.py", line 4, in <module>
print(scores[0])
~~~~~~^^^
TypeError: 'NoneType' object is not subscriptable(File の行のフォルダー名は省略しています。)エラーの意味は「None には [0] のような添え字が使えない」です。エラーが出るのは 4 行目ですが、原因は 2 行目にあります。sort を使うなら scores.sort() とだけ書き、結果を変数に入れたいなら scores = sorted(scores) と書きます。公式ドキュメント(Sorting Techniques)でも、list.sort は「混乱を避けるために None を返す」と説明されています。
| sorted(並び) | リスト.sort() | |
|---|---|---|
| 元のデータ | 変えない | 書き換える |
| 戻り値 | 新しいリスト | None |
| 使えるもの | for で回せるものすべて | リストだけ |
迷ったら sorted を使うのが安全です。sort は元のリストが要らないときに少しだけ効率がよい、と公式ドキュメントにあります。sorted の結果はいつもリストです。
print(sorted("python"))
print(sorted({"b": 1, "a": 2}))
print(sorted([3, 1, 2], reverse=True))
['h', 'n', 'o', 'p', 't', 'y']
['a', 'b']
[3, 2, 1]文字列は 1 文字ずつのリストに、辞書はキーだけのリストになります。最後の行のように reverse=True を付けると大きい順(降順)になります。何も付けなければ小さい順(昇順)です。
key には「要素を 1 つ受け取って、比べるための値を返す関数」を渡します。各要素をその関数に通した結果(キー)で並べ、結果には元の要素が入ります。関数は各要素に 1 回ずつ呼ばれます。
words = ["banana", "Cherry", "apple", "Banana", "fig"]
print(sorted(words))
print(sorted(words, key=str.lower))
print(sorted(words, key=len))
['Banana', 'Cherry', 'apple', 'banana', 'fig']
['apple', 'banana', 'Banana', 'Cherry', 'fig']
['fig', 'apple', 'banana', 'Cherry', 'Banana']key=str.lower は小文字にした値で比べるので、大文字・小文字を区別しない順になります(表示は元の文字列のまま)key=len は文字数の順です。banana・Cherry・Banana はどれも 6 文字なので、元の並びの順番のまま残っています(あとで説明する「安定ソート」)注意したいのは、key には関数そのものを渡すことです。key=str.lower() のようにかっこを付けると、その場で関数を呼んでしまい、次のエラーになります。
TypeError: unbound method str.lower() needs an argument「最後の文字で並べたい」のように、ちょうどよい組み込み関数がないときは自分で関数を作ります。def で書くこともできますが、key のためだけに名前を付けるのは大げさなので、lambda 式で 1 行で書くのが一般的です。lambda 引数: 返す値 の形で、「引数を受け取って、: の右側の値を返す名前のない関数」になります。
def last_char(s):
    return s[-1]

words = ["banana", "apple", "cherry", "kiwi"]
print(sorted(words, key=last_char))
print(sorted(words, key=lambda s: s[-1]))
['banana', 'apple', 'kiwi', 'cherry']
['banana', 'apple', 'kiwi', 'cherry']def で作った last_char と、lambda s: s[-1] は同じ働きです。最後の文字が a・e・i・y の順に並んでいます。lambda の中には式を 1 つしか書けず、if 文や複数行の処理は書けません。処理が長くなるときは def で関数を作って、その名前を key に渡します。
実際のプログラムでよく並べるのは、「辞書のリスト」(JSON や CSV を読み込んだデータなど)や「タプルのリスト」です。辞書は u["age"]、タプルは p[1] のように、並べたい項目を lambda で取り出します。
users = [
    {"name": "田中", "age": 34, "score": 72},
    {"name": "鈴木", "age": 28, "score": 95},
    {"name": "佐藤", "age": 41, "score": 88},
]
for u in sorted(users, key=lambda u: u["age"]):
    print(u["name"], u["age"])
print([u["name"] for u in sorted(users, key=lambda u: u["score"], reverse=True)])

points = [("b", 3), ("a", 5), ("c", 1)]
print(sorted(points))
print(sorted(points, key=lambda p: p[1]))
鈴木 28
田中 34
佐藤 41
['鈴木', '佐藤', '田中']
[('a', 5), ('b', 3), ('c', 1)]
[('c', 1), ('b', 3), ('a', 5)]タプルを key なしで並べると、1 番目の要素で比べ、同じなら 2 番目で比べます(この性質はあとの「複数の条件で並べる」で使います)。辞書のリストは key なしでは並べられないので、必ず key で項目を指定します。
標準ライブラリの operator モジュールには、「指定した項目を取り出す関数」を作る道具があります。itemgetter("age") は lambda u: u["age"] と同じ働きで、項目を複数書くとタプルで返します。attrgetter("price") は lambda x: x.price と同じで、クラスや dataclass の属性で並べるときに使います。
from operator import itemgetter, attrgetter
from dataclasses import dataclass

users = [
    {"name": "田中", "dept": "営業", "age": 34},
    {"name": "鈴木", "dept": "開発", "age": 28},
    {"name": "佐藤", "dept": "営業", "age": 25},
]
print([u["name"] for u in sorted(users, key=itemgetter("age"))])
print([(u["dept"], u["age"]) for u in sorted(users, key=itemgetter("dept", "age"))])

@dataclass
class Item:
    name: str
    price: int

items = [Item("ノート", 150), Item("ペン", 100), Item("のり", 120)]
print(sorted(items, key=attrgetter("price")))
['佐藤', '鈴木', '田中']
[('営業', 25), ('営業', 34), ('開発', 28)]
[Item(name='ペン', price=100), Item(name='のり', price=120), Item(name='ノート', price=150)]公式ドキュメントでは、lambda より「簡単で速い」と紹介されています。dataclass の書き方は「Pythonのdataclassの使い方」で説明しています。
「部署の順に並べ、同じ部署の中では点数の高い順」のように条件が 2 つ以上あるときは、key でタプルを返します。タプルは 1 番目、2 番目…の順に比べられるので、そのまま「第 1 条件、第 2 条件」になります。
reverse=True は全体を逆にするので、「部署は昇順、点数は降順」のように向きが混ざると使えません。並べたい項目が数値なら、マイナスを付けると、その項目だけ大きい順になります。
members = [
    ("田中", "営業", 72),
    ("鈴木", "開発", 95),
    ("佐藤", "営業", 88),
    ("高橋", "開発", 72),
    ("伊藤", "営業", 88),
]
# 部署の昇順、同じ部署なら点数の高い順
for m in sorted(members, key=lambda m: (m[1], -m[2])):
    print(m)
('佐藤', '営業', 88)
('伊藤', '営業', 88)
('田中', '営業', 72)
('鈴木', '開発', 95)
('高橋', '開発', 72)営業が開発より前なのは、「営」(U+55B6)のほうが「開」(U+958B)より文字の番号が小さいからです(日本語の順番は後で説明します)。佐藤さんと伊藤さんは部署も点数も同じなので、元のリストの順番(佐藤 → 伊藤)のままです。
マイナスを付けられるのは数値だけです。文字列にマイナスを付けると、次のエラーになります。
TypeError: bad operand type for unary -: 'str'文字列の項目を降順にしたいときは、2 回に分けて並べます。コツは「後回しにしたい条件(第 2 条件)から先に並べる」ことです。次の例は「日付の新しい順、同じ日付ならファイル名の昇順」です。日付は “2026-10-01” のような文字列なので、マイナスは使えません。
files = [
    ("report.txt", "2026-10-01"),
    ("memo.txt", "2026-10-03"),
    ("data.csv", "2026-10-01"),
    ("plan.txt", "2026-10-03"),
]
# 日付の新しい順、同じ日付ならファイル名の昇順
step1 = sorted(files, key=lambda f: f[0])
print(step1)
step2 = sorted(step1, key=lambda f: f[1], reverse=True)
print(step2)
[('data.csv', '2026-10-01'), ('memo.txt', '2026-10-03'), ('plan.txt', '2026-10-03'), ('report.txt', '2026-10-01')]
[('memo.txt', '2026-10-03'), ('plan.txt', '2026-10-03'), ('data.csv', '2026-10-01'), ('report.txt', '2026-10-01')]2 回目では日付しか見ていないのに、同じ日付の中は 1 回目の名前順のままです。これが次に説明する「安定ソート」のおかげです。公式ドキュメントの Sorting Techniques にも同じ手順が載っています。
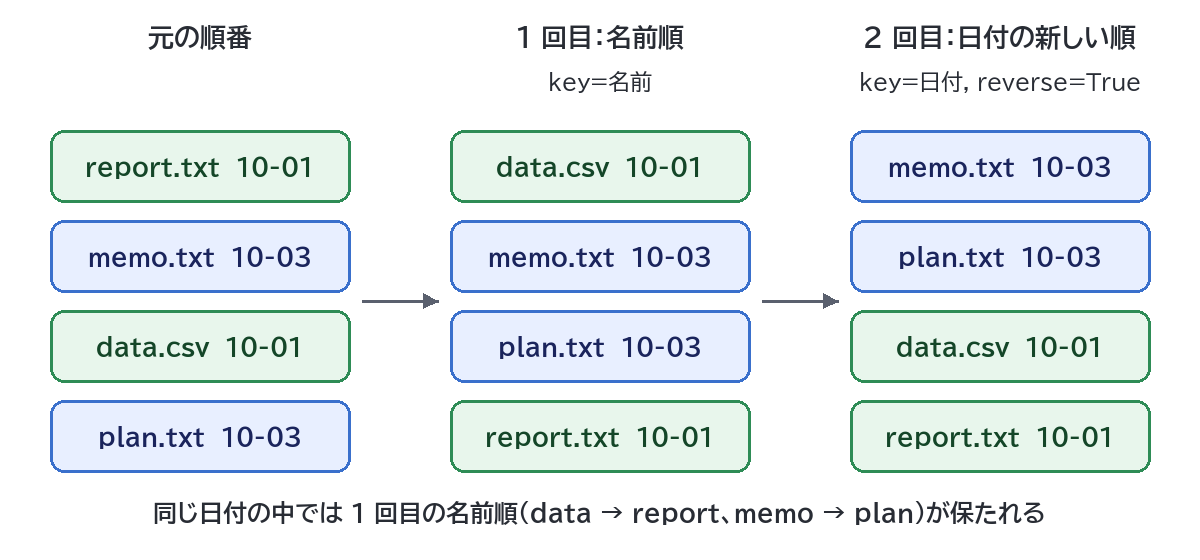
Python の並べ替えは安定ソート(stable sort)であることが保証されています。安定ソートとは、「キーが同じ要素どうしは、元の順番を変えない」並べ替えのことです。公式ドキュメントの sorted の説明にも「安定であることが保証されている」と書かれています。
scores = [("田中", 72), ("鈴木", 88), ("佐藤", 72), ("高橋", 88), ("伊藤", 60)]
print(sorted(scores, key=lambda s: s[1]))
[('伊藤', 60), ('田中', 72), ('佐藤', 72), ('鈴木', 88), ('高橋', 88)]72 点の田中さんと佐藤さん、88 点の鈴木さんと高橋さんは、どれも元のリストと同じ順番です。
reverse=True を使っても安定性は保たれます。一方、昇順に並べてから [::-1] で逆にすると、同じ値の順番まで逆になります。
data = [("b", 2), ("a", 2), ("c", 1)]
print(sorted(data, key=lambda x: x[1], reverse=True))
print(sorted(data, key=lambda x: x[1])[::-1])
[('b', 2), ('a', 2), ('c', 1)]
[('a', 2), ('b', 2), ('c', 1)]「2 回並べる」方法で降順にするときは、[::-1] ではなく reverse=True を使いましょう。
辞書をそのまま sorted に渡すとキーの順になります。値の順にしたいときは、key=辞書.get(キーを渡すと値を返す関数)を使うか、items() で (キー, 値) の組にしてから並べます。
stock = {"りんご": 12, "みかん": 30, "ぶどう": 5, "もも": 30}
print(sorted(stock))
print(sorted(stock, key=stock.get))
print(sorted(stock.items(), key=lambda kv: kv[1], reverse=True))
print(dict(sorted(stock.items(), key=lambda kv: kv[1])))
['ぶどう', 'みかん', 'もも', 'りんご']
['ぶどう', 'りんご', 'みかん', 'もも']
[('みかん', 30), ('もも', 30), ('りんご', 12), ('ぶどう', 5)]
{'ぶどう': 5, 'りんご': 12, 'みかん': 30, 'もも': 30}最後の行のように dict() で囲むと、値の順に並んだ新しい辞書になります(辞書は入れた順番を覚えています)。単語の出現回数を数えて多い順に並べるだけなら、collections.Counter の most_common() も便利です(「Pythonのcollections入門」で説明しています)。
いちばん大きいもの 1 つだけなら、並べ替えずに max() と min() を使います。key も使えます。
words = ["banana", "kiwi", "cherry", "fig"]
print(max(words, key=len))
print(min(words, key=len))
stock = {"りんご": 12, "みかん": 30, "ぶどう": 5, "もも": 30}
print(max(stock, key=stock.get))
print(max([], default=0))
banana
fig
みかん
0banana と cherry はどちらも 6 文字ですが、max は最初に見つかったほう(banana)を返します。みかんとももも同じです(公式ドキュメントにもそう書かれています)。空のリストを渡すと ValueError: max() iterable argument is empty になるので、空になりうるときは default= で代わりの値を指定します。
「上位 3 件」のように少しだけ取り出したいときは、heapq モジュールの nlargest() / nsmallest() も使えます。公式ドキュメントでは sorted(並び, key=key, reverse=True)[:n] と同じ結果になる、と説明されています。
import heapq
scores = [72, 95, 88, 60, 99, 81, 77]
print(heapq.nlargest(3, scores))
print(heapq.nsmallest(2, scores))
print(sorted(scores, reverse=True)[:3])
[99, 95, 88]
[60, 72]
[99, 95, 88]公式ドキュメントによると、nlargest が向いているのは n が小さいときで、1 件だけなら max・min のほうが効率的です。
CSV やファイル名から読み込んだ数字は、多くの場合文字列です。文字列は先頭の文字から 1 文字ずつ比べるため、”10″ の 1 文字目「1」が “9” の「9」より小さく、”10″ が先になります。数値として並べるには key=int を指定します。
nums = ["10", "9", "100", "2"]
print(sorted(nums))
print(sorted(nums, key=int))
files = ["img10.png", "img9.png", "img2.png"]
print(sorted(files))
print(sorted(files, key=lambda f: int(f[3:-4])))
['10', '100', '2', '9']
['2', '9', '10', '100']
['img10.png', 'img2.png', 'img9.png']
['img2.png', 'img9.png', 'img10.png']ファイル名の例では、f[3:-4] で「img」と「.png」の間の数字だけを取り出して int にしています。表示は元の文字列のままで、並べる基準だけが数値になります。日付は “2026-10-01” のように桁をそろえておけば、文字列のままでも正しい順になります。
Python の並べ替えは <(小なり)で要素を比べます。None と数値、文字列と数値のように、< で比べられない組み合わせがあるとエラーで止まります。
prices = [300, None, 120, 450]
print(sorted(prices))
TypeError: '<' not supported between instances of 'NoneType' and 'int'文字列と数値が混ざっている場合も、同じように 'str' and 'int' の TypeError になります。None を最後(または最初)に回したいときは、key で「None かどうか」と値のタプルを返します。
prices = [300, None, 120, 450]
print(sorted(prices, key=lambda p: (p is None, p)))
print(sorted(p for p in prices if p is not None))
[120, 300, 450, None]
[120, 300, 450]p is None は None のとき True、それ以外は False です。False は True より小さいものとして比べられるので、None 以外が先に来ます(None を先にしたいなら p is not None にします)。タプルは前の要素で順番が決まれば後ろを比べないため、None と数値を直接比べることはありません。None を除いてよいなら、2 つ目のように先に取り除くのがいちばん簡単です。
文字列は文字の番号(Unicode のコードポイント)の順に並ぶため、日本語は「読みの順」になりません。ひらがな → カタカナ → 漢字の順に分かれ、漢字は読みと関係のない番号順になります。
words = ["りんご", "バナナ", "みかん", "柿", "いちご", "アボカド"]
print(sorted(words))
names = ["田中", "佐藤", "鈴木", "伊藤", "高橋"]
for n in sorted(names):
    print(n, hex(ord(n[0])))
['いちご', 'みかん', 'りんご', 'アボカド', 'バナナ', '柿']
伊藤 0x4f0a
佐藤 0x4f50
田中 0x7530
鈴木 0x9234
高橋 0x9ad8ひらがなは U+3040〜309F、カタカナは U+30A0〜30FF、よく使う漢字は U+4E00 以降に割り当てられているため、アボカドはひらがなの後ろ、柿は最後です。名字は「伊藤・佐藤・田中・鈴木・高橋」となり、読みの順(いとう・さとう・すずき・たかはし・たなか)とは違います。文字の番号の考え方は「文字コードとは?UTF-8・Shift_JIS・EUC-JPの違い」の記事も参考にしてください。
漢字の読みはプログラムから正しく決められないので、読みの項目を用意して、それで並べるのが確実です。名簿や商品データなら「ふりがな」の列を持っておくのが一般的です。
fruits = [
    {"name": "りんご", "yomi": "りんご"},
    {"name": "バナナ", "yomi": "ばなな"},
    {"name": "柿", "yomi": "かき"},
    {"name": "アボカド", "yomi": "あぼかど"},
]
print([f["name"] for f in sorted(fruits, key=lambda f: f["yomi"])])
['アボカド', '柿', 'バナナ', 'りんご']読みはひらがなかカタカナのどちらかにそろえておきます。
公式ドキュメントでは、国や言語に合わせた並べ替えには locale.strxfrm を key に使う方法が紹介されています。この PC(Windows 11)で試した範囲では、次のようになりました。
import locale
print(locale.setlocale(locale.LC_COLLATE, "ja_JP"))
words = ["りんご", "バナナ", "みかん", "柿", "いちご", "アボカド"]
print(sorted(words, key=locale.strxfrm))
names = ["田中", "佐藤", "鈴木", "伊藤", "高橋"]
print(sorted(names, key=locale.strxfrm))
ja_JP
['アボカド', 'いちご', 'バナナ', 'みかん', 'りんご', '柿']
['伊藤', '高橋', '佐藤', '田中', '鈴木']ひらがなとカタカナは混ざって五十音順に並びましたが、柿は最後のままで、名字も読みの順(伊藤・佐藤・鈴木・高橋・田中)にはなりませんでした。使えるロケール名は OS によって違い、Linux や macOS では確認していません。setlocale はプログラム全体の設定を変える点にも注意が必要です。読み順にしたいときは、読みの項目を使う方法をおすすめします。
並べ替えは < だけで比べるので、クラスに __lt__() メソッドを定義すれば key なしで並べられます。ただし公式ドキュメントでは、ほかの道具(max など)との食い違いを避けるため、比較のメソッドを 6 つすべて用意することがすすめられています。dataclass なら @dataclass(order=True) で比較のメソッドがまとめて作られます。
sorted() は新しいリストを返し、sort() は元を書き換えて None を返す(x = x.sort() と書かない)len・str.lower・int や lambda、itemgetter / attrgetter が使えるkey=int、None は key で後ろに回す、日本語は読みの項目で並べる