Pythonのargparseの使い方|コマンドライン引数の受け取り方を実例で解説
hr
ENG LIFE BLOG
Python から git や cmd のコマンドを動かして、その結果をプログラムで使いたい。そんなときに使うのが標準ライブラリの subprocess です。使い方はシンプルですが、「出力が取れない」「日本語でエラーになる」「dir が見つからないと言われる」「shell=True は危ないと言われた」など、つまずきやすい点がいくつもあります。
この記事では、Windows 11 の Python 3.12 で実際に動かした結果つきで、次のことを解説します。
subprocess.run() の基本と、引数を「リスト」で渡す理由capture_output=True と text=True で出力を文字列として受け取る方法returncode と check=True で失敗を見つける方法、timeout で時間を区切る方法encoding の指定shell=True の危険(コマンドインジェクション)と、dir などの組み込みコマンドの動かし方shlex.split と Popen の使いどころサンプルは sample.py などの名前で保存し、PowerShell で py sample.py のように実行してください。出力中のファイルの場所は C:\work\ などに置き換えています。Linux・macOS は実機で確かめていないため、公式ドキュメントの範囲だけを紹介します。
動いているプログラムのことをプロセスと呼びます。Python から git などの別のプログラムを起動すると、Python が親プロセス、起動されたプログラムが子プロセスになります。subprocess は、この子プロセスを起動し、次の 3 つを受け取るためのモジュールです。
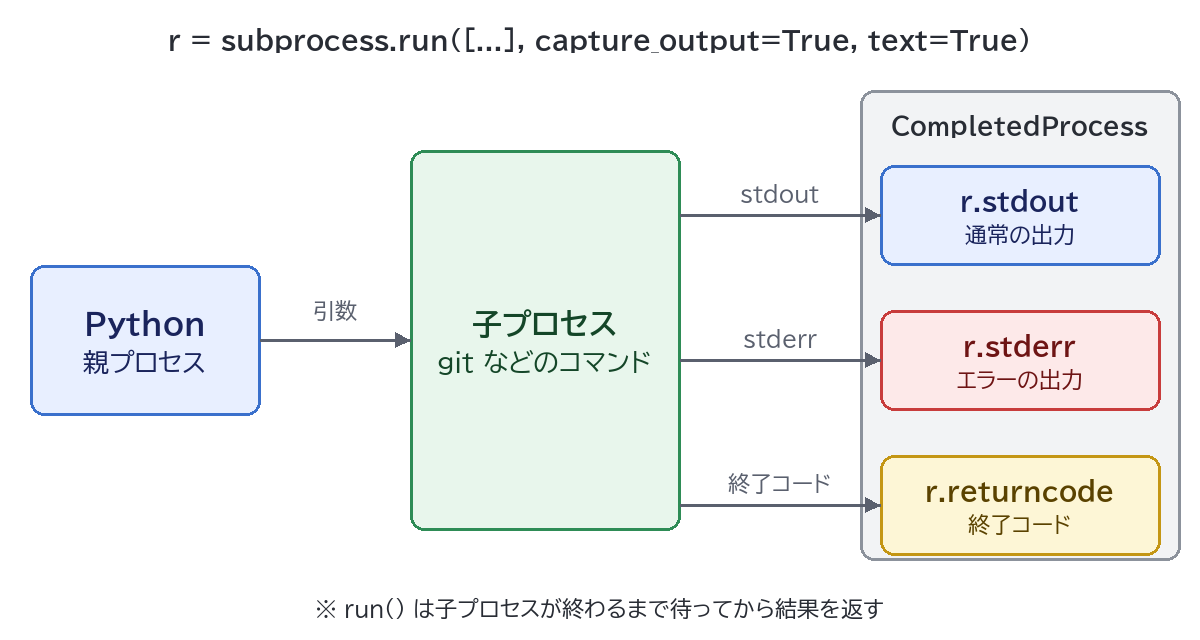
標準出力と標準エラー出力の違いは「標準出力・標準エラーとリダイレクト」、プロセスそのものの考え方は「Linuxのプロセス管理」で詳しく解説しています。
公式ドキュメントは、子プロセスを動かすには「できることはすべて run() 関数で行う」のがおすすめで、より細かい制御が必要なときだけ Popen を直接使う、としています。この記事も run() を中心に説明します。
いちばん簡単な例として、git --version を実行してみます。コマンドと引数を、1 つずつ分けたリストにして渡すのが基本です。
import subprocess

result = subprocess.run(["git", "--version"])
print("戻り値:", result.returncode)
print(result)
git version 2.49.0.windows.1
戻り値: 0
CompletedProcess(args=['git', '--version'], returncode=0)1 行目は git 自身が画面に出したものです。何も指定しないと、子プロセスの出力はそのまま画面に流れ、Python の変数には入りません。run() はコマンドが終わるまで待ってから、結果を CompletedProcess というオブジェクトで返します。returncode が 0 なので成功です。
リストで渡すと、要素の 1 つ 1 つがそのまま 1 つの引数として子プロセスに届きます。スペースを含むファイル名も、自分で引用符を付ける必要はありません。受け取った引数を表示するだけの show_args.py を用意して確かめます。
import sys

print(sys.argv[1:])
import subprocess
import sys
subprocess.run([sys.executable, "show_args.py", "data/memo 2026.txt", "--mode", "fast"])['data/memo 2026.txt', '--mode', 'fast']スペース入りのファイル名が分割されず、1 つの引数として届いています。公式ドキュメントも、引数の引用符付けなどをモジュールに任せられるので、リスト(シーケンス)で渡すほうがよいとしています。
sys.executable は、いま動いている Python の実行ファイルの場所です。子プロセスでも Python を動かしたいときは、"python" や "py" と書くより確実に同じ Python(仮想環境ならその Python)を使えます。
出力を変数に入れるには capture_output=True を付けます。さらに text=True を付けると、バイト列(bytes)ではなく文字列(str)で受け取れます。違いを比べてみます。
import subprocess

r1 = subprocess.run(["git", "--version"], capture_output=True)
print(repr(r1.stdout))

r2 = subprocess.run(["git", "--version"], capture_output=True, text=True)
print(repr(r2.stdout))
print(r2.stdout.strip())
b'git version 2.49.0.windows.1\n'
'git version 2.49.0.windows.1\n'
git version 2.49.0.windows.1text=True がないと、先頭に b の付いたバイト列になります。文字列として比べたり分割したりするなら text=True を付けます。末尾には改行が入っているので、1 行の値として使うときは .strip() で取り除きます。
出力の受け取り方には、ほかにも次の指定があります(どれも試した結果です)。なお、input= で標準入力に文字列を渡す、cwd= で動かすフォルダーを変える、といった指定もできます。
| 書き方 | 動き |
|---|---|
| 何も指定しない | 出力は画面に出る。r.stdout は None |
capture_output=True | stdout と stderr を別々に受け取る |
stdout=subprocess.PIPE, stderr=subprocess.STDOUT | エラー出力も r.stdout にまとめて受け取る |
stdout=subprocess.DEVNULL | 出力を捨てる(画面にも出さない) |
subprocess.check_output([...], text=True) | 標準出力だけを戻り値として返す。失敗すると例外 |
コマンドが失敗しても、run() は例外を出さずに普通に戻ってきます。失敗に気づくには、終了コードを自分で確かめる必要があります。わざと失敗する子プロセス child.py を用意します。
import sys

print("処理を開始します")
print("設定ファイルが見つかりません", file=sys.stderr)
sys.exit(3)
import subprocess
import sys
r = subprocess.run([sys.executable, "child.py"], capture_output=True, text=True)
print("returncode:", r.returncode)
print("stdout:", repr(r.stdout))
print("stderr:", repr(r.stderr))returncode: 3
stdout: '処理を開始します\n'
stderr: '設定ファイルが見つかりません\n'終了コードは 3 で、通常の出力とエラー出力が別々に入っています。if r.returncode != 0: と書いて判定してもよいのですが、確かめ忘れが起きやすいので、check=True を付けて「0 以外なら例外にする」のがおすすめです。付けると、この例では subprocess.CalledProcessError: Command '[...]' returned non-zero exit status 3. という例外で止まります([…] の部分には実行したコマンドが入ります)。
止めずに対処したいときは try・except で捕まえます。CalledProcessError の例外オブジェクトには、終了コード(returncode)、実行したコマンド(cmd)、受け取った出力(stdout・stderr)が入っています。
import subprocess
import sys

try:
    subprocess.run([sys.executable, "child.py"], capture_output=True, text=True, check=True)
except subprocess.CalledProcessError as e:
    print("失敗しました。戻り値:", e.returncode)
    print("コマンド:", e.cmd)
    print("エラー出力:", e.stderr.strip())
失敗しました。戻り値: 3
コマンド: ['C:\\...\\python.exe', 'child.py']
エラー出力: 設定ファイルが見つかりませんエラー出力は capture_output=True を付けたときだけ e.stderr に入ります(付けないと None)。失敗の理由をログに残したいなら、両方を付けておきましょう。try・except の書き方は「Pythonの例外処理入門」で解説しています。なお、コマンドそのものが見つからないときは、check=True がなくても起動の時点で FileNotFoundError: [WinError 2] 指定されたファイルが見つかりません。 になります。
ネットワークを使うコマンドなどは、いつまでも終わらないことがあります。timeout=秒数 を付けると、時間切れで TimeoutExpired が起きます。10 秒かかる子プロセスを 2 秒で打ち切ってみます。
import subprocess
import sys
import time

start = time.perf_counter()
try:
    subprocess.run([sys.executable, "-c", "import time; time.sleep(10)"], timeout=2)
except subprocess.TimeoutExpired as e:
    print("時間切れ:", e.timeout, "秒")
print(f"経過: {time.perf_counter() - start:.1f} 秒")
時間切れ: 2.0 秒
経過: 2.0 秒10 秒待たずに 2 秒で戻ってきました。公式ドキュメントによると、run() では時間切れになると子プロセスを強制終了し、終わるのを待ってから TimeoutExpired を出し直します。そのため、止まった子プロセスが残り続けることはありません。
text=True のとき、出力は OS の標準の文字コードで文字列に直されます。この PC(日本語の Windows 11)では locale.getpreferredencoding(False) が cp932(Shift_JIS を Microsoft が拡張したもの)でした。ところが git の git log は、コミットメッセージを UTF-8 で出力します。日本語のコミットメッセージがあるリポジトリで試すと、次のようになりました。
import subprocess

r = subprocess.run(["git", "log", "-1", "--format=%s"], capture_output=True, text=True)
print(repr(r.stdout))
Exception in thread Thread-1 (_readerthread):
Traceback (most recent call last):
(途中省略)
UnicodeDecodeError: 'cp932' codec can't decode byte 0x81 in position 10: illegal multibyte sequence
NoneUTF-8 のバイト列を cp932 として読もうとして UnicodeDecodeError が出ています。注意したいのは、このエラーが出力を読む裏方のスレッドの中で起きているため、プログラムは止まらず、r.stdout が黙って None になっていることです。最後の None がそれです。「出力が空になる」と思ったら、上にこのメッセージが出ていないか確かめてください。
直し方は、コマンドが出す文字コードを encoding= で指定することです(encoding を指定すると、text=True を書かなくても文字列になります)。
import subprocess

r = subprocess.run(["git", "log", "-1", "--format=%s"], capture_output=True, encoding="utf-8")
print(repr(r.stdout))'日本語のコミットメッセージ\n'逆に、cmd の組み込みコマンドの出力は cp932 でした。echo こんにちは をバイト列で受け取ると b'\x82\xb1\x82\xf1\x82\xc9\x82\xbf\x82\xcd\r\n' となり、先頭の \x82\xb1 は cp932 の「こ」です。こちらは text=True だけで正しく読めます。子プロセスとして動かした Python の print も cp932 でした。
文字コードはコマンドや設定によって変わります。迷ったら、いったん text=True なしでバイト列を受け取り、.decode("utf-8") と .decode("cp932") のどちらで読めるか試すと確実です。文字コードの基本は「文字コードとは?」で、すでに文字化けしてしまった文字列は文字化け復元ツールで元の文字を推測できることがあります。
shell=True を付けると、コマンドを 1 つの文字列で書き、シェル(Windows では cmd.exe)に解釈させて実行します。手軽に見えますが、利用者の入力を文字列でつないで shell=True で実行すると、入力に紛れ込んだ別のコマンドまで実行されてしまいます。これをコマンドインジェクションといいます。
無害な echo だけで確かめます。cmd.exe では & が「コマンドの区切り」の意味を持ちます。
import subprocess

# 利用者がフォームなどに入力した値のつもり
name = "Tanaka & echo INJECTED"

subprocess.run(f"echo Hello, {name}", shell=True)
Hello, Tanaka
INJECTED名前を表示するだけのつもりが、2 つ目の echo INJECTED まで実行されました。ここが echo ではなくファイルを消すコマンドだったら、その操作も実行されてしまいます。同じ値を、shell を使わずリストで渡すと次のようになります(show_args.py は先ほどの引数を表示するスクリプトです)。
import subprocess
import sys

name = "Tanaka & echo INJECTED"

subprocess.run([sys.executable, "show_args.py", name])
['Tanaka & echo INJECTED']& を含めた全体が、ただの文字として 1 つの引数で届きました。
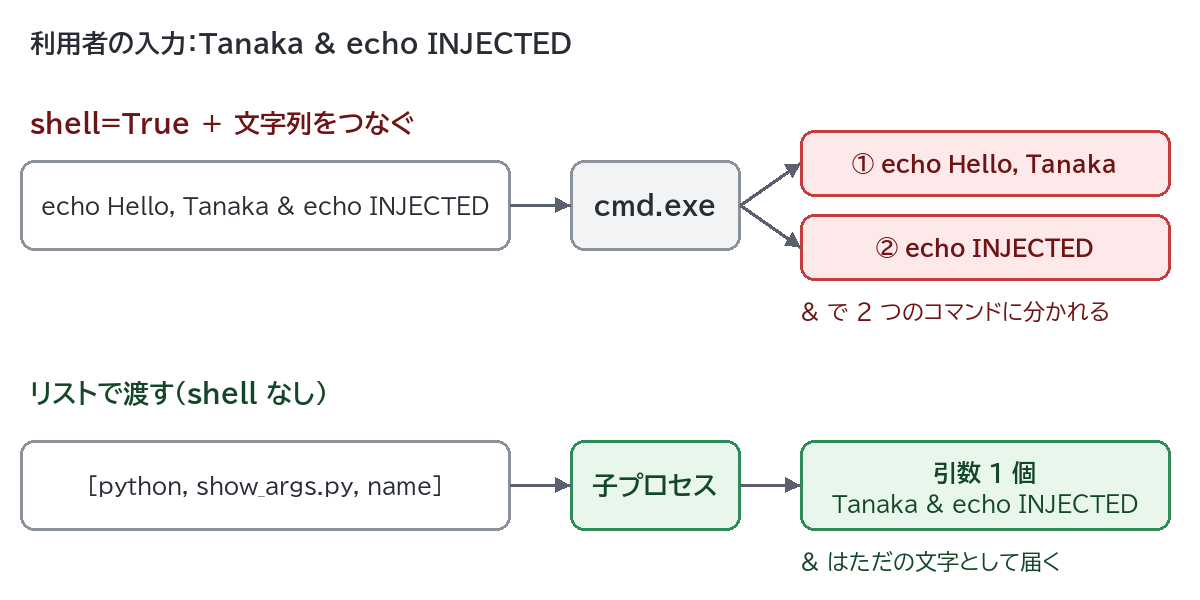
公式ドキュメントの「Security Considerations(セキュリティ上の注意)」では、subprocess は自分からシェルを呼ばないのでシェルの特殊文字も安全に子プロセスに渡せること、shell=True を明示した場合は、空白や特殊文字を正しく引用符で囲んでインジェクションを防ぐのはアプリケーションの責任であることが書かれています。原則は次の 3 つです。
shell=True は使わず、リストで渡す入力を文字列でつないで命令を組み立てると危ない、という構造は SQL でも同じです。「SQLインジェクションとは?」もあわせて読むと理解が深まります。
Windows で dir を実行しようとして、次のように書くとエラーになります。
import subprocess

subprocess.run(["dir", "data"])
(途中省略)
FileNotFoundError: [WinError 2] 指定されたファイルが見つかりません。dir や copy は dir.exe のような独立したプログラムではなく、cmd.exe の中に組み込まれたコマンドだからです。公式ドキュメントにも、Windows で shell=True が必要なのは dir や copy のようなシェルの組み込みコマンドを実行するときだけで、バッチファイルやコンソールのプログラムには不要だと書かれています。動かし方は 2 つあります。
import subprocess

r = subprocess.run(["cmd", "/c", "dir", "/b", "data"], capture_output=True, text=True)
print(r.stdout)
import subprocess
r = subprocess.run("dir /b data", shell=True, capture_output=True, text=True)
print(r.stdout)memo 2026.txt
report.txtどちらも同じ結果になりました。cmd /c は「cmd.exe を起動して、続くコマンドを実行したら終了する」という意味です。どちらの書き方でも最終的には cmd.exe が解釈するので、利用者の入力を混ぜないという注意は同じです。ファイルの一覧やコピーなら、そもそも Python の pathlib や shutil で書くほうが OS に左右されず安全です。
なお、同じ ["dir", "data"] を Git Bash から起動した Python で実行すると、エラーにならずに一覧が出ました。Git for Windows に入っている Linux 風の dir コマンドが PATH から見つかったためです。起動するターミナルによって、同じ名前で別のコマンドが動くことがあります。
設定ファイルなどに書かれたコマンドの文字列を、リストに分けたいことがあります。そのときは shlex.split が使えます。引用符で囲んだ部分は 1 つの要素になります。
import shlex

print(shlex.split('git commit -m "first commit"'))
print(shlex.split(r'type C:\work\memo.txt'))
print(shlex.split(r'type C:\work\memo.txt', posix=False))
['git', 'commit', '-m', 'first commit']
['type', 'C:workmemo.txt']
['type', 'C:\\work\\memo.txt']2 行目に注目してください。shlex.split は既定で Linux などのシェル(POSIX)の規則で分けるため、\ が「次の文字をそのまま扱う」記号として消え、Windows のパスが C:workmemo.txt に壊れました。posix=False なら \ は残ります。公式ドキュメントにも「shlex モジュールは Unix のシェルのためだけに設計されている」と警告があり、shlex.quote() も Windows のシェルでは正しさが保証されません。Windows では最初からリストで書くのが確実です。
run() は子プロセスが終わるまで待つので、時間のかかる処理の途中経過は表示できません。少しずつ読みたいときは、run() の土台になっている Popen を使います。1 秒ごとに 1 行出す slow.py を用意します。
import time

for i in range(1, 4):
    print(f"step {i}", flush=True)
    time.sleep(1)
import subprocess
import sys
import time
start = time.perf_counter()
with subprocess.Popen([sys.executable, "slow.py"], stdout=subprocess.PIPE, text=True) as proc:
for line in proc.stdout:
print(f"{time.perf_counter() - start:.1f}秒: {line}", end="")
print("戻り値:", proc.returncode)0.0秒: step 1
1.0秒: step 2
2.0秒: step 3
戻り値: 01 行ずつ、出たそばから読めています。with を使うと、ブロックを抜けるときに子プロセスの終了を待ち、パイプも閉じてくれます。slow.py の flush=True は、子プロセス側で出力をためこまずにすぐ送るための指定です(理由は次の「よくある間違い」で説明します)。
注意点として、公式ドキュメントは stdout=PIPE のまま proc.wait() で待つと、出力が多いときにデッドロック(お互いに待ち続けて止まる)すると警告しています。まとめて受け取るなら communicate() か run() を使いましょう。
| 症状 | 原因 | 直し方 |
|---|---|---|
r.stdout が None | capture_output=True がない | 付ける |
| 失敗しているのに処理が先に進む | run() は失敗しても例外を出さない | check=True を付ける |
| FileNotFoundError | コマンド名の間違い、PATH にない、dir などの組み込みコマンド | PATH を確認する。組み込みコマンドは cmd /c |
UnicodeDecodeError のあと None | 出力の文字コードと読む側の文字コードが違う | encoding="utf-8" などを指定する |
| 出力とエラーの順番が入れ替わる | 子プロセス側で標準出力がためこまれている | 子が Python なら -u を付ける |
| 想定外のコマンドが動く | 入力を文字列でつないで shell=True | リストで渡す |
表の「順番が入れ替わる」を実際に見てみます。先ほどの child.py は「処理を開始します」を先に出していますが、エラー出力をまとめて受け取ると順番が逆になりました。
import subprocess
import sys

r = subprocess.run([sys.executable, "child.py"], stdout=subprocess.PIPE, stderr=subprocess.STDOUT, text=True)
print(repr(r.stdout))'設定ファイルが見つかりません\n処理を開始します\n'Python の公式ドキュメントによると、標準出力は画面(対話的な出力先)以外に出すときはためこまれ(ブロックバッファリング)、標準エラー出力は常に 1 行ごとに送られます。そのため、ためこまれていた標準出力が最後に出てきたのです。子プロセスの Python に -u オプションを付けて [sys.executable, "-u", "child.py"] にすると、'処理を開始します\n設定ファイルが見つかりません\n' と元の順番になりました。
os.system() は文字列のコマンドをシェルで実行し、終了の状態だけを返します。出力を変数で受け取れず、常にシェルを通るので、先ほどのインジェクションにも注意が必要です。公式ドキュメントの os.system() の説明でも、より強力な subprocess モジュールを使うことがすすめられています。
この記事の出力は Windows 11 で確かめたもので、Linux・macOS の実機では試していません。公式ドキュメントに書かれている主な違いは次のとおりです。
shell=True を付けたときのシェルは /bin/sh(Windows では環境変数 COMSPEC が指すシェル。通常は cmd.exe)shell=True なしで文字列を渡すとプログラム名として扱われ、引数を付けられない(Windows では run("git --version") も動いたが、リストで書くのが無難)-N のときは、子プロセスがシグナル N で終了したことを表す(POSIX のみ)dir や cmd /c は Windows だけのものです。別の OS で動かすときは、文字コードも含めて実際に出力を確かめてください。
基本の形は subprocess.run(["コマンド", "引数"], capture_output=True, text=True, check=True) で、必要に応じて timeout と encoding を足します。shell=True は使わず、利用者の入力をコマンドの文字列に埋め込まないようにしましょう。