PythonのEnum(列挙型)の使い方|name・value・StrEnumを実例で解説
hr
ENG LIFE BLOG
Web API を 3 回呼ぶプログラムで、1 回の応答に 1 秒かかるなら、順番に呼ぶと合計 3 秒かかります。でも、その 3 秒のほとんどは「相手の返事を待っているだけ」の時間です。待っている間に次の呼び出しを始めておけば、全体はもっと早く終わるはずです。これを Python で書くための標準ライブラリが asyncio(エイシンク・アイオー)です。
この記事では、async def・await・asyncio.run() の基本から、asyncio.gather() と TaskGroup で複数の待ちを重ねる方法、create_task()、タイムアウト、初心者がつまずきやすい間違い(await の付け忘れ、async の中での time.sleep())までを、実際に動かした出力つきで説明します。通信の代わりに asyncio.sleep()(指定した秒数だけ待つ)を使うので、ネットワークなしで試せます。
載せている出力は、Windows 11・Python 3.12.6 で実際に実行したものです。経過時間(「合計 2.01 秒」など)は PC の性能や負荷で少し変わります。コードは sample.py などの名前で保存し、PowerShell でそのフォルダーに移動してから次のコマンドで実行できます。
py sample.py料理にたとえると分かりやすくなります。お湯を沸かす(5 分)、ご飯を炊く(30 分)、野菜を切る(5 分)という 3 つの仕事があるとき、お湯が沸くのをじっと見てから炊飯器のスイッチを入れる人はいません。スイッチを入れたら、炊ける間に野菜を切ります。料理をする人は 1 人のままですが、「待つだけの時間」を重ねることで全体が早く終わります。
asyncio も同じ考え方です。プログラムを動かす人(スレッド)は 1 人のまま、ある処理が通信の返事やファイルの読み込みを待っている間に、別の処理を進めます。この「待ちを重ねて進める」書き方を非同期処理と呼びます。逆に、1 つ終わるまで次に進まない書き方は同期処理です。
「A・B・C の 3 つのデータをダウンロードする」処理を、通信の代わりに time.sleep() で待つ形で書きます。A は 1 秒、B は 2 秒、C は 1 秒かかるとします。
import time

def download(name, seconds):
    print(f"{name} 開始")
    time.sleep(seconds)  # 待ち時間(通信の代わり)
    print(f"{name} 終了")
    return f"{name} のデータ"

start = time.perf_counter()
download("A", 1)
download("B", 2)
download("C", 1)
print(f"合計 {time.perf_counter() - start:.2f} 秒")
A 開始
A 終了
B 開始
B 終了
C 開始
C 終了
合計 4.00 秒1 + 2 + 1 で、ちょうど 4 秒です。time.perf_counter() は時間を正確に測るための関数で、終わりの値から始めの値を引くと経過秒数が分かります。
同じ処理を asyncio で書き直します。細かい書き方は次の章で説明するので、まずは結果を見てください。
import asyncio
import time

async def download(name, seconds):
    print(f"{name} 開始")
    await asyncio.sleep(seconds)  # 待ち時間(通信の代わり)
    print(f"{name} 終了")
    return f"{name} のデータ"

async def main():
    start = time.perf_counter()
    results = await asyncio.gather(
        download("A", 1),
        download("B", 2),
        download("C", 1),
    )
    print(results)
    print(f"合計 {time.perf_counter() - start:.2f} 秒")

asyncio.run(main())
A 開始
B 開始
C 開始
A 終了
C 終了
B 終了
['A のデータ', 'B のデータ', 'C のデータ']
合計 2.01 秒A・B・C が続けて「開始」し、1 秒後に A と C、2 秒後に B が終わりました。合計は一番長い B の 2 秒とほぼ同じです。終わった順番は A・C・B ですが、results のリストは渡した順(A・B・C)に並んでいます。これは公式ドキュメントにも「結果の値の順番は、渡したものの順番に対応する」と書かれている gather の決まりです。
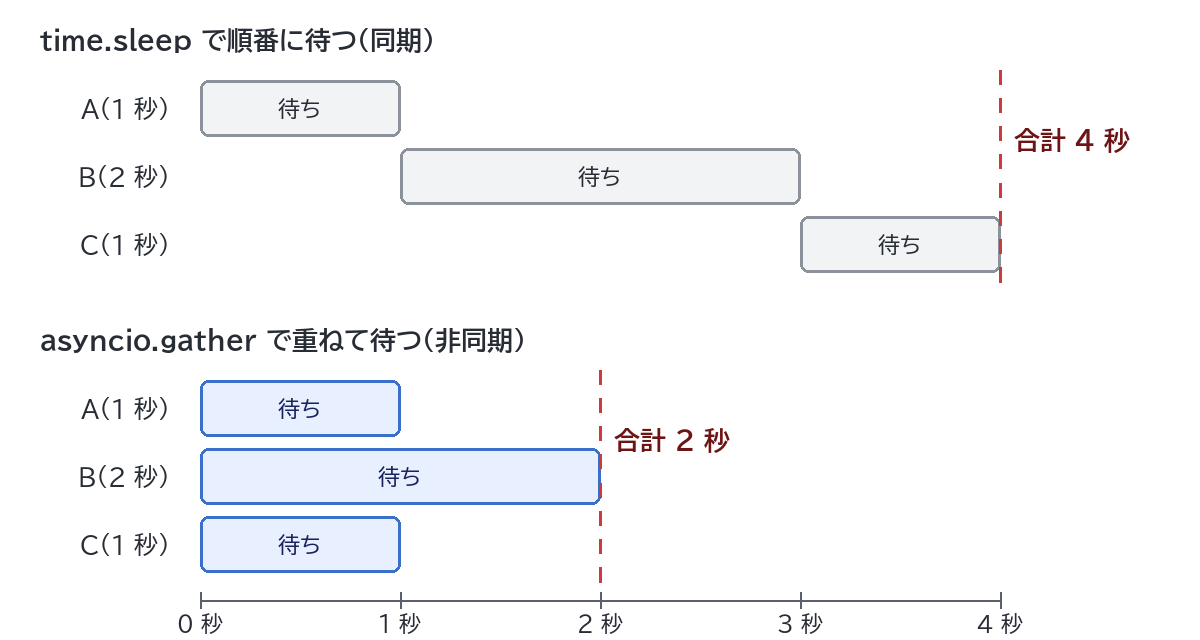
注意したいのは、asyncio は待ち時間を重ねるだけで、計算そのものを速くするわけではないことです。CPU で重い計算をする処理には効果がありません(後の「よくある間違い」で実測します)。
| 書き方 | 意味 |
|---|---|
async def 関数名(): | コルーチン関数を作る。呼ぶと、すぐには動かず「コルーチン」というオブジェクトが返る |
await 式 | その処理が終わるまで待つ。待っている間は、ほかの処理に順番をゆずる。async def の中でだけ書ける |
asyncio.run(main()) | 非同期処理を動かす仕組み(イベントループ)を用意して main() を最後まで動かす。プログラムの入り口で 1 回だけ使う |
コルーチンは「途中で一時停止して、あとで続きから再開できる関数」のことです。await のところで一時停止し、待っている間にほかのコルーチンが動きます。どのコルーチンをいつ動かすかを管理しているのがイベントループで、asyncio.run() がこれを用意してくれます。いちばん小さな例です。
import asyncio

async def hello():
    print("こんにちは")
    await asyncio.sleep(1)
    print("1 秒たちました")
    return 42

result = asyncio.run(hello())
print(result)
こんにちは
1 秒たちました
42return した値は、asyncio.run() や await の結果として受け取れます。ふつうの関数と同じ感覚で値を返せます。
初心者が最初につまずくのがここです。async def の関数を、ふつうの関数のように呼んでみます。
import asyncio

async def hello():
    print("こんにちは")
    return 42

x = hello()
print(x)
print(type(x))
<coroutine object hello at 0x000001F68FB5D480>
<class 'coroutine'>
sys:1: RuntimeWarning: coroutine 'hello' was never awaited「こんにちは」は表示されず、42 も返ってきません。hello() は中身を実行せず、コルーチンオブジェクトを作って返しただけです(0x から始まる番号は実行のたびに変わります)。そして、一度も await されずに捨てられたため、最後に RuntimeWarning: coroutine 'hello' was never awaited(コルーチン hello は一度も await されなかった)という警告が出ました。公式ドキュメントにも「コルーチンを呼んだだけでは実行の予約はされない」と書かれています。
async def の中で await を付け忘れた場合も同じです。
import asyncio

async def hello():
    print("こんにちは")

async def main():
    hello()          # await を忘れた
    print("main 終了")

asyncio.run(main())
C:\...\sample.py:7: RuntimeWarning: coroutine 'hello' was never awaited
hello() # await を忘れた
RuntimeWarning: Enable tracemalloc to get the object allocation traceback
main 終了(1 行目のフォルダー名は省略しています。)エラーで止まるのではなく警告が出るだけで先に進むので、「なぜか処理が実行されていない」というバグになりがちです。この警告を見たら、await の付け忘れを探してください。hello() を await hello() に直すと「こんにちは」が表示されます。
もう 1 つの落とし穴です。async と await を使っても、1 つずつ await すると、前の処理が終わるまで次が始まりません。
import asyncio
import time

async def download(name, seconds):
    await asyncio.sleep(seconds)
    return f"{name} のデータ"

async def main():
    start = time.perf_counter()
    a = await download("A", 1)
    b = await download("B", 2)
    c = await download("C", 1)
    print(a, b, c)
    print(f"合計 {time.perf_counter() - start:.2f} 秒")

asyncio.run(main())
A のデータ B のデータ C のデータ
合計 4.03 秒同期処理と同じ 4 秒でした。await は「ここで終わるまで待つ」という意味なので、待ちを重ねたいときは、次の章の gather や TaskGroup でまとめて始めてから待つ必要があります。
最初の例で使った asyncio.gather(コルーチン1, コルーチン2, ...) は、渡したものを同時に動かし、全部終わったら結果をリストで返します。コルーチンを渡すと、gather が自動で「タスク」(イベントループに予約された実行単位)にしてくれます。
どれかが例外を出したときの動きは、return_exceptions 引数で変わります。初期値の False では、最初の例外がそのまま gather を await したところに伝わります(ほかの処理は取り消されずに動き続けます)。True にすると、例外も結果の 1 つとしてリストに入ります。
import asyncio

async def download(name, seconds, fail=False):
    await asyncio.sleep(seconds)
    if fail:
        raise ValueError(f"{name} でエラー")
    return f"{name} のデータ"

async def main():
    results = await asyncio.gather(
        download("A", 1, fail=True),
        download("B", 2),
        return_exceptions=True,
    )
    print(results)

asyncio.run(main())
[ValueError('A でエラー'), 'B のデータ']「失敗したものがあっても、成功した分は使いたい」ときに便利です。
Python 3.11 で追加された asyncio.TaskGroup は、async with のブロックの中で tg.create_task() したタスクを、ブロックを抜けるときに全部待ってくれる仕組みです。
import asyncio
import time

async def download(name, seconds):
    await asyncio.sleep(seconds)
    return f"{name} のデータ"

async def main():
    start = time.perf_counter()
    async with asyncio.TaskGroup() as tg:
        task_a = tg.create_task(download("A", 1))
        task_b = tg.create_task(download("B", 2))
        task_c = tg.create_task(download("C", 1))
    # async with を抜けた時点で、全部終わっている
    print(task_a.result(), task_b.result(), task_c.result())
    print(f"合計 {time.perf_counter() - start:.2f} 秒")

asyncio.run(main())
A のデータ B のデータ C のデータ
合計 2.01 秒gather と同じく 2 秒で終わりました。結果は各タスクの .result() で取り出します。gather との大きな違いは、どれかが失敗したら残りを取り消すことです。
import asyncio

async def download(name, seconds, fail=False):
    try:
        await asyncio.sleep(seconds)
        if fail:
            raise ValueError(f"{name} でエラー")
        print(f"{name} 終了")
    except asyncio.CancelledError:
        print(f"{name} は取り消された")
        raise

async def main():
    try:
        async with asyncio.TaskGroup() as tg:
            tg.create_task(download("A", 1, fail=True))
            tg.create_task(download("B", 3))
    except* ValueError as eg:
        print("つかまえた:", eg.exceptions)

asyncio.run(main())
B は取り消された
つかまえた: (ValueError('A でエラー'),)1 秒後に A が失敗した時点で、まだ待っていた B(3 秒)は取り消され、「B 終了」は表示されませんでした。公式ドキュメントでも、子タスクが例外を出したときに TaskGroup は残りのタスクを取り消すが gather は取り消さない、と比べて説明されています。TaskGroup の例外は、複数の例外をまとめた ExceptionGroup として出てくるため、except*(Python 3.11 からの書き方)で受け取っています。
| asyncio.gather | asyncio.TaskGroup | |
|---|---|---|
| 使える版 | 古くからある | Python 3.11 から |
| 結果の受け取り | 渡した順のリスト | 各タスクの .result() |
| 1 つが失敗したとき | 残りは動き続ける(初期値) | 残りを取り消す |
| 例外を結果に含める | return_exceptions=True でできる | できない(ExceptionGroup で受け取る) |
| 向いている場面 | 失敗があっても全部の結果がほしい | 1 つでも失敗したら全体を失敗にしたい |
例外の受け取り方(try・except)の基本は「Pythonの例外処理入門」で説明しています。
asyncio.create_task() は、コルーチンをタスクにしてイベントループに予約します。予約したタスクは、自分のコードが await で一時停止したときに動き始めます。
import asyncio
import time

async def download(name, seconds):
    print(f"{name} 開始")
    await asyncio.sleep(seconds)
    print(f"{name} 終了")
    return f"{name} のデータ"

async def main():
    start = time.perf_counter()
    task = asyncio.create_task(download("A", 2))  # ここで予約される
    print("ほかの仕事をする")
    await asyncio.sleep(1)
    print(f"{time.perf_counter() - start:.2f} 秒:まだ A を待っている途中")
    result = await task
    print(result)
    print(f"合計 {time.perf_counter() - start:.2f} 秒")

asyncio.run(main())
ほかの仕事をする
A 開始
1.01 秒:まだ A を待っている途中
A 終了
A のデータ
合計 2.01 秒「ほかの仕事をする」が「A 開始」より先に表示されている点に注目してください。create_task() は予約するだけで、main が await asyncio.sleep(1) で一時停止したときに A が動き始めました。main の 1 秒と A の 2 秒が重なったので、合計は 3 秒ではなく 2 秒です。
公式ドキュメントには「create_task() の戻り値への参照を保存しておくこと」という重要な注意があります。イベントループはタスクを弱い参照(それだけでは消えるのを止められない参照)でしか持っていないため、変数に入れずに放っておくと、終わる前にタスクが消えてしまうことがあるからです。上の例のように task = ... と変数に入れて、最後に await しましょう。複数のタスクを扱うなら TaskGroup を使うと、この心配がありません。
通信相手が応答しないと、いつまでも待ち続けてしまいます。Python 3.11 からは asyncio.timeout() で、ブロック全体に制限時間を付けられます。
import asyncio
import time

async def slow():
    await asyncio.sleep(5)
    return "終わった"

async def main():
    start = time.perf_counter()
    try:
        async with asyncio.timeout(1):
            result = await slow()
            print(result)
    except TimeoutError:
        print("1 秒で打ち切りました")
    print(f"経過 {time.perf_counter() - start:.2f} 秒")

asyncio.run(main())
1 秒で打ち切りました
経過 1.01 秒5 秒かかる slow() が、1 秒で取り消されました。公式ドキュメントによると、timeout() は時間切れになると中の処理を取り消し、それを TimeoutError に変えて外に出します。そのため、TimeoutError は async with の外側で受け取ります(上の例のように try で async with を囲みます)。
1 つの処理だけに制限時間を付けるなら、昔からある asyncio.wait_for() も使えます。
import asyncio

async def slow():
    await asyncio.sleep(5)
    return "終わった"

async def main():
    try:
        result = await asyncio.wait_for(slow(), timeout=1)
        print(result)
    except TimeoutError:
        print("1 秒で打ち切りました")

asyncio.run(main())
1 秒で打ち切りましたPython 3.10 以前では、時間切れのときに出る例外は asyncio.TimeoutError という別のクラスでした。3.11 から組み込みの TimeoutError になったので、古い記事のコードと違って見えることがあります。
最初の gather の例で、await asyncio.sleep(seconds) を time.sleep(seconds) にしてしまった場合です。
import asyncio
import time

async def download(name, seconds):
    print(f"{name} 開始")
    time.sleep(seconds)  # 間違い:asyncio.sleep ではない
    print(f"{name} 終了")

async def main():
    start = time.perf_counter()
    await asyncio.gather(
        download("A", 1),
        download("B", 2),
        download("C", 1),
    )
    print(f"合計 {time.perf_counter() - start:.2f} 秒")

asyncio.run(main())
A 開始
A 終了
B 開始
B 終了
C 開始
C 終了
合計 4.00 秒エラーも警告も出ないまま、同期処理と同じ 4 秒かかりました。asyncio では、コルーチンが await で一時停止したときだけほかのコルーチンに順番が回ります。time.sleep() は await できない「普通の待ち」なので、待っている間イベントループごと止まってしまい、ほかの処理は 1 つも進みません。async def の中では、待つ処理を asyncio に対応したもの(asyncio.sleep() や、async に対応した通信ライブラリ)にする必要があります。標準の urllib.request や requests ライブラリ(PythonでHTTPリクエストを送る方法)も、time.sleep と同じく止まる側の処理です。
1,000 万回の掛け算と足し算をする関数を、gather で 3 つ同時に動かしてみます。
import asyncio
import time

def heavy(n):
    total = 0
    for i in range(n):
        total += i * i
    return total

async def calc(n):
    return heavy(n)

async def main():
    start = time.perf_counter()
    heavy(10_000_000)
    print(f"1 回だけ:{time.perf_counter() - start:.2f} 秒")

    start = time.perf_counter()
    await asyncio.gather(calc(10_000_000), calc(10_000_000), calc(10_000_000))
    print(f"gather で 3 回:{time.perf_counter() - start:.2f} 秒")

asyncio.run(main())
1 回だけ:0.32 秒
gather で 3 回:0.93 秒3 回分で約 3 倍の時間がかかりました。計算している間は「待ち時間」がないので、重ねるものがありません。asyncio が速くするのは、通信・ファイル・データベースの応答など待ち時間が長い処理(I/O 待ち)だけです。重い計算を並列に動かしたいときは、標準ライブラリの concurrent.futures.ProcessPoolExecutor などで、複数のプロセスに分ける方法を検討します。
使いたいライブラリが async に対応していない(中で time.sleep のように止まる)場合は、Python 3.9 で追加された asyncio.to_thread() で、別のスレッドで動かせます。スレッドは同じプログラムの中で並んで動く「もう 1 人の作業者」のようなものです。
import asyncio
import time

def old_download(name, seconds):
    # async に対応していない、待ち時間のある関数(の代わり)
    time.sleep(seconds)
    return f"{name} のデータ"

async def main():
    start = time.perf_counter()
    results = await asyncio.gather(
        asyncio.to_thread(old_download, "A", 1),
        asyncio.to_thread(old_download, "B", 2),
        asyncio.to_thread(old_download, "C", 1),
    )
    print(results)
    print(f"合計 {time.perf_counter() - start:.2f} 秒")

asyncio.run(main())
['A のデータ', 'B のデータ', 'C のデータ']
合計 2.00 秒time.sleep を使う関数でも、待ちが重なって 2 秒になりました。to_thread には、関数そのもの(old_download)と引数を分けて渡します。old_download("A", 1) と書くと、その場で実行されて止まってしまうので注意してください。なお公式ドキュメントには、GIL(Python が同時に 1 つのスレッドしか Python のコードを実行しないようにする仕組み)のため、to_thread は基本的に I/O 待ちの処理向けだと書かれています。重い計算を to_thread に渡しても、通常は速くなりません。
ふつうの def の中で await を書くと、実行前に文法エラーになります。
SyntaxError: 'await' outside async function関数の定義を async def に変えてください。また、async def の中から asyncio.run() を呼ぶと、次のエラーになります。
RuntimeError: asyncio.run() cannot be called from a running event loop「イベントループがすでに動いている中では asyncio.run() は呼べない」という意味です。asyncio.run() はプログラムの入り口で 1 回だけ使い、その内側では await で呼び出します。
Python 3.11 以降で、「1 つでも失敗したら全体を失敗として扱いたい」なら TaskGroup が安全です。失敗したものがあっても成功した結果を集めたいなら、gather に return_exceptions=True を付けるのが手軽です。3.10 以前でも動かす必要があるなら gather を使います。
asyncio.sleep のような待ちなら数千個でも動きますが、実際の通信では、相手のサーバーに一度に大量のリクエストを送ると負担をかけたり、アクセスを制限されたりします。asyncio.Semaphore で同時に動く数を制限するなど、相手のルールに合わせた数にしてください。