SQLのサブクエリとWITH句(CTE)|IN・EXISTS・再帰CTEを実行結果で解説
hr
ENG LIFE BLOG
データベースの表を自分で設計し始めると、「顧客名や住所を注文のたびに書くと、何がいけないのか」「表はどこまで分ければいいのか」で迷います。その答えになる考え方が正規化(せいきか)です。この記事では、ネットショップの注文表を例に、正規化していない表で実際に起きる困りごとを SQLite で再現し、第 1 正規形から第 3 正規形まで順番に表を分けていきます。
SQL の結果とエラー文は、すべて Python 3.12・SQLite 3.45.3 で実際に実行したものです。
正規化とは、表の中の重複したデータをなくすように、表を分けていく作業です。高知工科大学のデータベースの講義資料では、正規化の目的として「データの重複を減少させること」「データ操作を,内容の矛盾を起こさずに,正確に実行できるようにすること」などが挙げられています。IPA の基本情報技術者試験のシラバス(Ver.9.2)にも、データ中心設計の用語例として「正規化,一事実一箇所」が載っています。
同じ住所が 10 行に書いてあれば、引っ越しのときに 10 行すべてを直す必要があり、1 行でも直し忘れると「どれが正しい住所か分からない」状態になります。正規化は、こうした更新の食い違いを表の形そのもので防ぐための考え方です。手順は次の 3 段階で進めます(同じ講義資料の「正規化の手順」をもとにまとめました)。
| 段階 | やること |
|---|---|
| 第 1 正規形 | 1 つの欄(セル)に 1 つの値だけを入れる。繰り返しのグループをなくす |
| 第 2 正規形 | 主キーの一部だけで決まる列を、別の表に分ける |
| 第 3 正規形 | 主キー以外の列で決まる列を、別の表に分ける |
正規化は、基本情報技術者試験と応用情報技術者試験の出題範囲にも入っています(後の「よくある質問」で説明します)。
Python に標準で入っている SQLite を使います。次のコードを sql_normalize_practice.py という名前で保存してください。正規化していない注文表(order_sheet)と、それを 1 行 1 商品に直した表(order_lines)をメモリー上に作ります。「;」で終わるまで何行でも入力でき、終了するとデータは消えます。
import sqlite3

con = sqlite3.connect(":memory:", isolation_level=None)
con.execute("PRAGMA foreign_keys = ON")
con.executescript("""
CREATE TABLE order_sheet (
  order_id         INTEGER PRIMARY KEY,
  ordered_on       TEXT    NOT NULL,
  customer_id      INTEGER NOT NULL,
  customer_name    TEXT    NOT NULL,
  customer_address TEXT    NOT NULL,
  items            TEXT    NOT NULL
);
INSERT INTO order_sheet VALUES
  (1, '2026-10-01', 1, '佐藤', '東京都港区', 'マウス×2,キーボード×1'),
  (2, '2026-10-03', 2, '鈴木', '大阪府大阪市', 'ワイヤレスマウス×1'),
  (3, '2026-10-05', 1, '佐藤', '東京都港区', 'USBメモリ×3'),
  (4, '2026-10-08', 3, '高橋', '福岡県福岡市', 'マウス×1,USBメモリ×2'),
  (5, '2026-10-10', 2, '鈴木', '大阪府大阪市', 'キーボード×1,マウス×1');

CREATE TABLE order_lines (
  order_id         INTEGER NOT NULL,
  ordered_on       TEXT    NOT NULL,
  customer_id      INTEGER NOT NULL,
  customer_name    TEXT    NOT NULL,
  customer_address TEXT    NOT NULL,
  product_id       INTEGER NOT NULL,
  product_name     TEXT    NOT NULL,
  price            INTEGER NOT NULL,
  qty              INTEGER NOT NULL,
  PRIMARY KEY (order_id, product_id)
);
INSERT INTO order_lines VALUES
  (1, '2026-10-01', 1, '佐藤', '東京都港区',   1, 'マウス',           2980, 2),
  (1, '2026-10-01', 1, '佐藤', '東京都港区',   2, 'キーボード',       6480, 1),
  (2, '2026-10-03', 2, '鈴木', '大阪府大阪市', 3, 'ワイヤレスマウス', 3980, 1),
  (3, '2026-10-05', 1, '佐藤', '東京都港区',   4, 'USBメモリ',        1280, 3),
  (4, '2026-10-08', 3, '高橋', '福岡県福岡市', 1, 'マウス',           2980, 1),
  (4, '2026-10-08', 3, '高橋', '福岡県福岡市', 4, 'USBメモリ',        1280, 2),
  (5, '2026-10-10', 2, '鈴木', '大阪府大阪市', 2, 'キーボード',       6480, 1),
  (5, '2026-10-10', 2, '鈴木', '大阪府大阪市', 1, 'マウス',           2980, 1);
""")

print("SQL を入力して Enter(; で終わるまで複数行で入力できます。終了は exit)")
buf = ""
while True:
    line = input("sql> " if not buf else "...> ")
    if not buf and line.strip().lower() in ("exit", "quit"):
        break
    buf += line + "\n"
    if not sqlite3.complete_statement(buf):
        continue
    sql, buf = buf, ""
    try:
        cur = con.execute(sql)
    except sqlite3.Error as e:
        print("エラー:", e)
        continue
    if cur.description is None:
        print("OK")
        continue
    print(" | ".join(d[0] for d in cur.description))
    rows = cur.fetchall()
    for row in rows:
        print(" | ".join("NULL" if v is None else str(v) for v in row))
print(f"({len(rows)} 行)")保存したフォルダーで次のコマンドを実行すると「sql>」と表示されます。記事の SQL は上から順に、同じ画面で続けて入力する前提です。
py sql_normalize_practice.pyまず、正規化していない注文表を見てみます。
SELECT * FROM order_sheet;order_id | ordered_on | customer_id | customer_name | customer_address | items
1 | 2026-10-01 | 1 | 佐藤 | 東京都港区 | マウス×2,キーボード×1
2 | 2026-10-03 | 2 | 鈴木 | 大阪府大阪市 | ワイヤレスマウス×1
3 | 2026-10-05 | 1 | 佐藤 | 東京都港区 | USBメモリ×3
4 | 2026-10-08 | 3 | 高橋 | 福岡県福岡市 | マウス×1,USBメモリ×2
5 | 2026-10-10 | 2 | 鈴木 | 大阪府大阪市 | キーボード×1,マウス×1
(5 行)1 行が 1 回の注文で、items の欄には商品がカンマ区切りで並び、佐藤さん・鈴木さんの名前と住所は注文のたびに書かれています。紙の注文票なら自然な形ですが、データベースでは次の 3 つの異常が起きます。この記事では、UPDATE で起きるものを「更新時異常」、INSERT・DELETE で起きるものを「挿入時異常」「削除時異常」と呼びます。資料によっては「修正異状」のように「異状」と書いたり、3 つをまとめて「更新時異状」と呼んだりします。
佐藤さんが品川区に引っ越したので、住所を直します。ところが、注文 3 の行だけを直してしまいました。
UPDATE order_sheet SET customer_address = '東京都品川区' WHERE order_id = 3;
SELECT order_id, customer_name, customer_address FROM order_sheet WHERE customer_id = 1;
order_id | customer_name | customer_address
1 | 佐藤 | 東京都港区
3 | 佐藤 | 東京都品川区
(2 行)同じ佐藤さん(customer_id 1)に住所が 2 つできました。データベースはエラーを出さないので、どちらが正しいかは表を見ても分かりません。WHERE customer_id = 1 で全行を直せば防げますが、「直す人が毎回気を付ける」ことに頼る設計です。
会員登録だけ済ませた田中さんを、注文より先に登録しようとします。
INSERT INTO order_sheet (customer_id, customer_name, customer_address) VALUES (4, '田中', '北海道札幌市');エラー: NOT NULL constraint failed: order_sheet.ordered_onこの表は「注文の表」なので、注文日や商品がないと 1 行になりません。NOT NULL を外せば入りますが、それは「商品も日付もない架空の注文」を作ることになり、注文件数を数えたときに 1 件多くなります。
高橋さんの注文 4 がキャンセルになったので削除します。
DELETE FROM order_sheet WHERE order_id = 4;
SELECT * FROM order_sheet WHERE customer_name = '高橋';
order_id | ordered_on | customer_id | customer_name | customer_address | items
(0 行)高橋さんの注文は 1 件だけだったので、注文と一緒に高橋さんの名前と住所も消えました。消したかったのは注文だけです。
3 つとも、原因は「顧客の情報」と「注文の情報」が 1 つの行に同居していることです。ここから、表を正規化して直していきます。
order_sheet の items の欄には「マウス×2,キーボード×1」のように値が複数入っています。この状態だと、「マウスが入った注文」を探すにも LIKE で文字列を探すしかありません(注文 4 は先ほど削除したので出てきません)。
SELECT order_id, items FROM order_sheet WHERE items LIKE '%マウス%';order_id | items
1 | マウス×2,キーボード×1
2 | ワイヤレスマウス×1
5 | キーボード×1,マウス×1
(3 行)「ワイヤレスマウス」の注文 2 まで混ざりました。さらに「マウスが合計何個売れたか」は、文字列を分解しないと SQL では計算できません。検索の速さも問題で、先頭に % を付けた LIKE は、EXPLAIN QUERY PLAN で調べると「SCAN order_sheet」(全行を順に調べる)になり、インデックスで速くできません(詳しくは「SQLのLIKEとワイルドカード」)。
そこで、1 つのセルには 1 つの値だけを入れるように直します。注文の中の商品 1 つを 1 行にし、商品名・価格・数量をそれぞれ別の列にした形が、スクリプトで用意した order_lines です。これが第 1 正規形です。「商品コード 1・商品コード 2…」のように同じ種類の列を横に並べる形も、繰り返しのグループなので第 1 正規形ではありません。
SELECT * FROM order_lines;order_id | ordered_on | customer_id | customer_name | customer_address | product_id | product_name | price | qty
1 | 2026-10-01 | 1 | 佐藤 | 東京都港区 | 1 | マウス | 2980 | 2
1 | 2026-10-01 | 1 | 佐藤 | 東京都港区 | 2 | キーボード | 6480 | 1
2 | 2026-10-03 | 2 | 鈴木 | 大阪府大阪市 | 3 | ワイヤレスマウス | 3980 | 1
3 | 2026-10-05 | 1 | 佐藤 | 東京都港区 | 4 | USBメモリ | 1280 | 3
4 | 2026-10-08 | 3 | 高橋 | 福岡県福岡市 | 1 | マウス | 2980 | 1
4 | 2026-10-08 | 3 | 高橋 | 福岡県福岡市 | 4 | USBメモリ | 1280 | 2
5 | 2026-10-10 | 2 | 鈴木 | 大阪府大阪市 | 2 | キーボード | 6480 | 1
5 | 2026-10-10 | 2 | 鈴木 | 大阪府大阪市 | 1 | マウス | 2980 | 1
(8 行)これなら SELECT SUM(qty) FROM order_lines WHERE product_name = 'マウス'; で、ワイヤレスマウスを含めずに「4」と正しく数えられます。ただし、佐藤さんの住所は 3 行に、マウスの価格も 3 行に書かれたままです。先ほどの 3 つの異常は、第 1 正規形でもまだ起きます。
第 2・第 3 正規形に進む前に、関数従属という考え方を押さえます。「列 X の値が決まると、列 Y の値が 1 つに決まる」関係のことで、「X → Y」と書きます。たとえば product_id が 1 なら product_name は必ず「マウス」なので、product_id → product_name です。
主キーは、行を 1 つに特定できる列(または列の組)です。order_lines では、注文番号だけでは行が決まらず(注文 1 には 2 行ある)、商品番号だけでも決まらないので、order_id と product_id の組が主キーです。この表の関数従属を図にすると次のようになります。
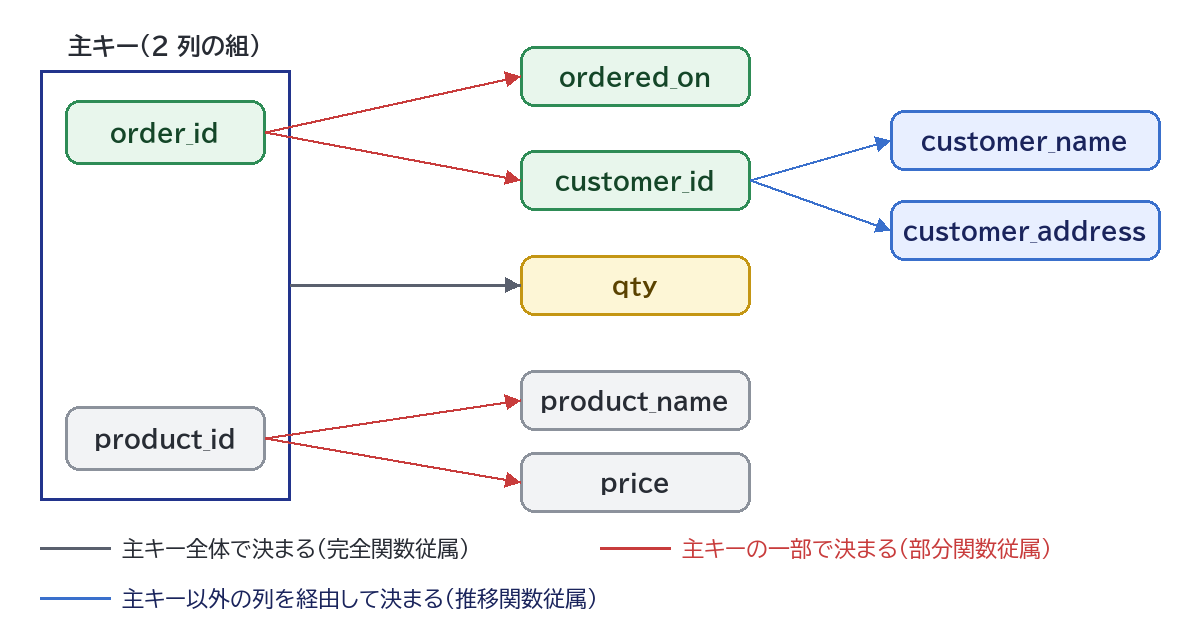
IPA のシラバスに用語例として載っている 3 つの関数従属は、この図の矢印の種類にあたります。
| 用語 | 意味 | order_lines の例 |
|---|---|---|
| 完全関数従属 | 主キー全体で決まり、一部だけでは決まらない | (order_id, product_id) → qty |
| 部分関数従属 | 主キーの一部だけで決まる | order_id → ordered_on、product_id → price |
| 推移関数従属 | 主キー → 別の列 → さらに別の列、と間接的に決まる | order_id → customer_id → customer_address |
関数従属は、今入っているデータの見た目ではなく意味(業務のルール)で判断します。今のデータでは名前と住所が 1 対 1 でも、同姓の別人がいれば customer_name → customer_address は成り立たないので、顧客は customer_id で区別します。
第 2 正規形は、第 1 正規形の表から部分関数従属をなくした形です。主キーの一部(order_id だけ、product_id だけ)で決まる列を、その列を主キーにした別の表に移します。
customer_name と customer_address も、order_id が決まれば(customer_id を通して)決まるので、注文の表に入ります。商品の表になる部分を取り出してみます。
SELECT DISTINCT product_id, product_name, price FROM order_lines;product_id | product_name | price
1 | マウス | 2980
2 | キーボード | 6480
3 | ワイヤレスマウス | 3980
4 | USBメモリ | 1280
(4 行)8 行に散らばっていた価格が、商品ごとに 1 行になりました。値上げのときに直すのは 1 行だけです。
第 2 正規形にした注文の表を取り出すと、まだ重複が残っています。
SELECT DISTINCT order_id, ordered_on, customer_id, customer_name, customer_address FROM order_lines;order_id | ordered_on | customer_id | customer_name | customer_address
1 | 2026-10-01 | 1 | 佐藤 | 東京都港区
2 | 2026-10-03 | 2 | 鈴木 | 大阪府大阪市
3 | 2026-10-05 | 1 | 佐藤 | 東京都港区
4 | 2026-10-08 | 3 | 高橋 | 福岡県福岡市
5 | 2026-10-10 | 2 | 鈴木 | 大阪府大阪市
(5 行)佐藤さん・鈴木さんの住所が 2 回ずつ出ています。customer_name と customer_address は、主キーの order_id ではなく、主キーではない customer_id で決まる列だからです(推移関数従属)。第 3 正規形は、第 2 正規形の表からこの推移関数従属をなくした形です。顧客の表(customer_id, name, address)を作り、注文の表には customer_id だけを残します。
これで、1 つの表が顧客・注文・注文明細・商品の 4 つに分かれました。表どうしは、相手の主キーの値を持つ列(外部キー)でつながります。
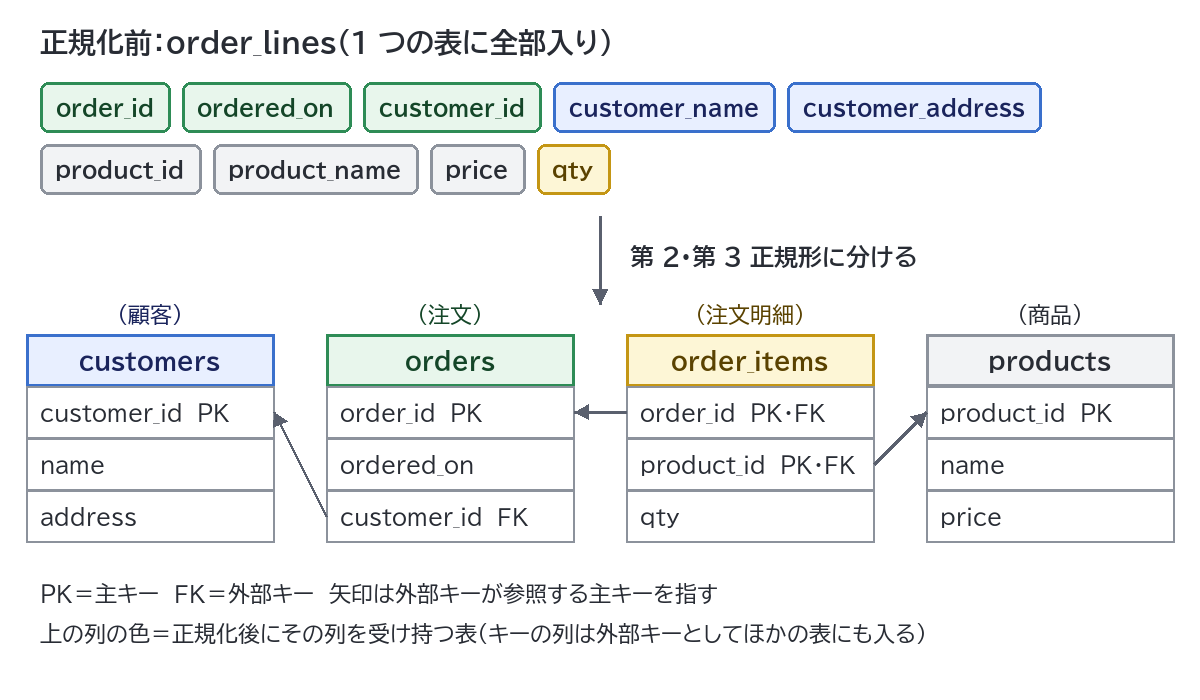
図 2 のとおりに表を作ります。REFERENCES が外部キーの指定です(スクリプトの最初で PRAGMA foreign_keys = ON を実行しているので、SQLite でも外部キーのチェックが効きます。制約の書き方は「SQLのCREATE TABLE入門」で解説しています)。1 つずつ入力し、それぞれ「OK」と表示されれば成功です。
CREATE TABLE customers (
  customer_id INTEGER PRIMARY KEY,
  name        TEXT    NOT NULL,
  address     TEXT    NOT NULL
);
CREATE TABLE products (
  product_id INTEGER PRIMARY KEY,
  name       TEXT    NOT NULL,
  price      INTEGER NOT NULL
);
CREATE TABLE orders (
  order_id    INTEGER PRIMARY KEY,
  ordered_on  TEXT    NOT NULL,
  customer_id INTEGER NOT NULL REFERENCES customers (customer_id)
);
CREATE TABLE order_items (
  order_id   INTEGER NOT NULL REFERENCES orders (order_id),
  product_id INTEGER NOT NULL REFERENCES products (product_id),
  qty        INTEGER NOT NULL,
  PRIMARY KEY (order_id, product_id)
);
データは order_lines から INSERT ... SELECT DISTINCT で移せます。外部キーのチェックがあるので、参照される側(顧客・商品)から先に入れます。
INSERT INTO customers SELECT DISTINCT customer_id, customer_name, customer_address FROM order_lines;
INSERT INTO products SELECT DISTINCT product_id, product_name, price FROM order_lines;
INSERT INTO orders SELECT DISTINCT order_id, ordered_on, customer_id FROM order_lines;
INSERT INTO order_items SELECT order_id, product_id, qty FROM order_lines;
SELECT * FROM customers; は 3 行(佐藤・鈴木・高橋が 1 行ずつ)、orders は 5 行、order_items は 8 行、products は 4 行になりました。重複していた住所と価格は、それぞれ 1 か所にだけ書かれています。
表を分けると、注文一覧を見るたびに表をつなぐ必要があります。これは JOIN で行います。正しく正規化した表は、JOIN すれば元の表と同じ情報に戻せます。確かめるため、4 つの表を JOIN した結果と order_lines を比べます。
SELECT o.order_id, o.ordered_on, c.customer_id, c.name, c.address,
       p.product_id, p.name, p.price, i.qty
FROM order_items AS i
JOIN orders    AS o ON o.order_id    = i.order_id
JOIN customers AS c ON c.customer_id = o.customer_id
JOIN products  AS p ON p.product_id  = i.product_id
EXCEPT
SELECT * FROM order_lines;
EXCEPT は「上の結果から、下の結果にある行を取り除く」命令です。結果は 0 行で、上下を入れ替えても 0 行でした。つまり、4 つの表を JOIN した 8 行は、order_lines の 8 行と完全に一致します。JOIN の種類と書き方は「SQLのJOINの種類と使い分け」、毎回の JOIN を短く書くには「SQLのビュー(VIEW)」が役立ちます。JOIN の SQL が長くて読みにくいときは、SQL整形ツールに貼ると改行とインデントを付けて読みやすくできます。
最初に order_sheet で試した 3 つの操作を、分けた表で行います。
UPDATE customers SET address = '東京都品川区' WHERE customer_id = 1;
INSERT INTO customers VALUES (4, '田中', '北海道札幌市');
DELETE FROM order_items WHERE order_id = 4;
DELETE FROM orders WHERE order_id = 4;
SELECT * FROM customers;
customer_id | name | address
1 | 佐藤 | 東京都品川区
2 | 鈴木 | 大阪府大阪市
3 | 高橋 | 福岡県福岡市
4 | 田中 | 北海道札幌市
(4 行)住所の変更は 1 行で済み(更新時異常の解消)、注文のない田中さんも登録でき(挿入時異常の解消)、注文 4 を消しても高橋さんは残りました(削除時異常の解消)。
外部キーは、表の間の食い違いも防ぎます。存在しない顧客 9 の注文を入れる INSERT INTO orders VALUES (6, '2026-10-12', 9);、注文が残っている鈴木さんを消す DELETE FROM customers WHERE customer_id = 2; は、どちらも「エラー: FOREIGN KEY constraint failed」になりました。注文と明細のように複数の表をまとめて書き換えるときは、途中で失敗しても半端に残らないようトランザクションを使います。
マウスを 3280 円に値上げしてから、マウスが入った注文の小計(price × qty)を JOIN で計算してみます。
UPDATE products SET price = 3280 WHERE product_id = 1;
SELECT i.order_id, p.price, i.qty, p.price * i.qty AS subtotal FROM order_items AS i JOIN products AS p ON p.product_id = i.product_id WHERE p.product_id = 1;
order_id | price | qty | subtotal
1 | 3280 | 2 | 6560
5 | 3280 | 1 | 3280
(2 行)2026 年 10 月 1 日に 2980 円で売った注文 1 まで、新しい価格で計算されてしまいました。
「商品の今の価格」と「その注文で売ったときの価格」は、別の事実です。注文時の価格は注文と商品の組で決まるので、order_items に unit_price のような列を持たせて記録します。これは重複ではありません。正規化は「同じ事実を 2 か所に書かない」ことで、違う事実まで 1 つにまとめることではないと覚えておきましょう。
顧客名を主キーや外部キーにすると、同姓の別人を区別できず、名前が変わったときはつながっている全部の表を直すことになります。変わる可能性がある値は、行を特定する鍵には向きません。顧客番号のような、意味を持たせない番号を主キーにするのが安全です。
表を分けるほど、読むときの JOIN が増えます。Microsoft の解説記事「データベース正規化の説明」でも、第 3 正規形がほとんどのアプリケーションで必要な最高レベルとされ、都市や郵便番号まで別の表にするような分割は実用的とは限らない、という趣旨の注意が書かれています。
逆に、集計や表示を速くするために、あえて重複を持たせることもあります。これを非正規化と呼び、IPA の応用情報技術者試験のシラバス(Ver.7.2)にも「処理の高速化のためにあえて正規化を行わず,表の結合にかかる時間を短縮するなど,パフォーマンスを考慮したデータベース設計の考え方」として載っています。たとえば、毎日の売上集計を別の表に保存しておく方法です。非正規化した表は元の表と食い違う可能性があるので、「いつ・何から作り直すか」を決めておきます。最初は正規化した形で作り、遅さが実際に問題になってから検討する順番が安全です。
第 3 正規形の先には、ボイス・コッド正規形(BCNF)、第 4 正規形、第 5 正規形があります。まずは第 3 正規形までを確実に見分けられるようにするのがおすすめです。
2026 年 10 月 26 日に確認した IPA の公式情報(2026 年 10 月時点)では、基本情報技術者試験のシラバス Ver.9.2 に「正規化の目的と手順,第1 正規形,第2 正規形,第3 正規形を理解する」、用語例として「完全関数従属,部分関数従属,推移関数従属」が載っています。応用情報技術者試験のシラバス Ver.7.2 は「第 3 正規形など」に加え、設計案を更新のしやすさや性能から評価すること、非正規化も範囲に含めています。試験の形式や勉強の進め方は「基本情報技術者試験とは?」「応用情報技術者試験とは?」で解説しています。
「何で決まる列を追い出すか」で区別します。第 2 正規形は主キーの一部で決まる列、第 3 正規形は主キーではない列で決まる列を追い出します。主キーが 1 列だけの表では「主キーの一部で決まる列」は出てこないので、主キーが複数の列の組になっている表で特に第 2 正規形を意識します。