SQLのUNIONとUNION ALLの違い|重複・ORDER BYを実行結果で解説
hr
ENG LIFE BLOG
SQL のウィンドウ関数は、行をまとめずに、ほかの行の値を使った計算結果を各行の横に付け足す機能です。「売上の累計」「カテゴリごとの順位」「前回の注文からの間隔」といった集計を、1 つの SELECT で書けます。
この記事では、練習用のテーブルで実行した結果を見ながら、GROUP BY との違い、ROW_NUMBER・RANK・DENSE_RANK の違い、SUM() OVER の累計と移動平均、既定の枠(RANGE)で累計がずれる落とし穴、LAG・LEAD、グループごとの上位 N 件の取り出し方を解説します。GROUP BY は「SQLのGROUP BYと集計関数」、サブクエリと WITH 句は「SQLのサブクエリとWITH句(CTE)」で解説しています。
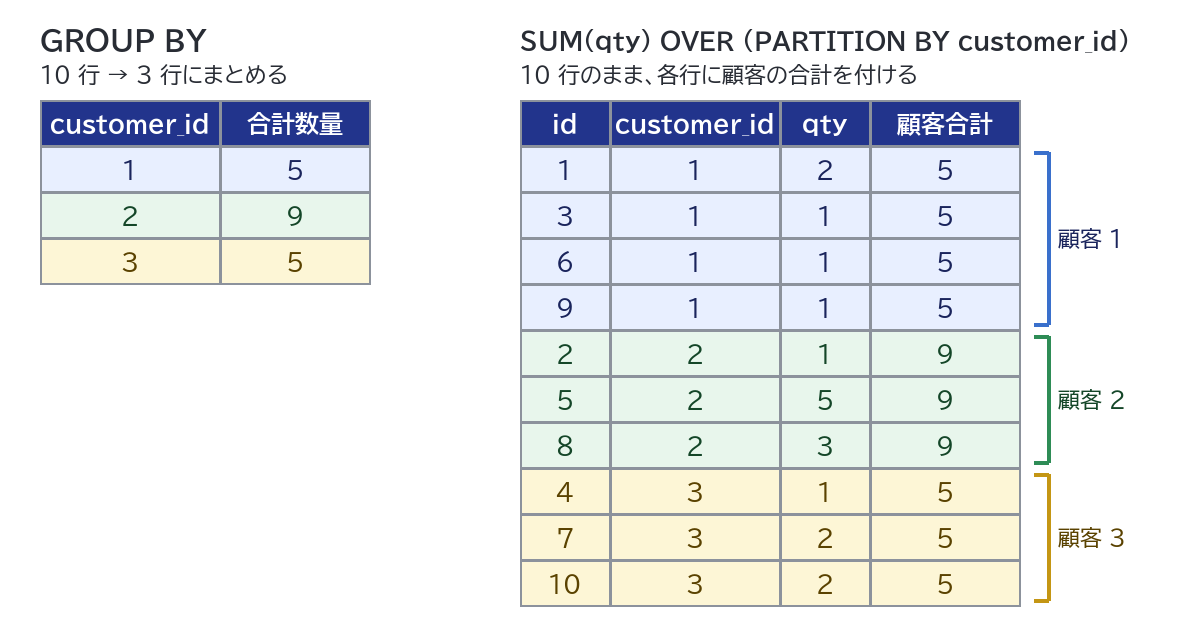
GROUP BY は、同じ値の行を 1 行にまとめて集計します。たとえば顧客ごとの注文数量の合計は、次のように 3 行になります。
SELECT customer_id, SUM(qty) AS 合計数量 FROM orders GROUP BY customer_id;customer_id | 合計数量
1 | 5
2 | 9
3 | 5
(3 行)ウィンドウ関数で同じ合計を出すと、注文の 10 行はそのまま残り、各行の横に「その顧客の合計」が付きます。
SELECT id, customer_id, qty, SUM(qty) OVER (PARTITION BY customer_id) AS 顧客合計 FROM orders;id | customer_id | qty | 顧客合計
1 | 1 | 2 | 5
3 | 1 | 1 | 5
6 | 1 | 1 | 5
9 | 1 | 1 | 5
2 | 2 | 1 | 9
5 | 2 | 5 | 9
8 | 2 | 3 | 9
4 | 3 | 1 | 5
7 | 3 | 2 | 5
10 | 3 | 2 | 5
(10 行)GROUP BY は行をまとめる、ウィンドウ関数は行をまとめない。これが一番大きな違いです。計算に使う行の範囲を「ウィンドウ(窓)」と呼ぶので、この名前が付いています。
書き方は「関数名() OVER (…)」です。OVER のかっこの中に、次の 3 つを必要なものだけ書きます。
| 書く場所 | 意味 | 例 |
|---|---|---|
| PARTITION BY 列 | この列の値ごとにグループを分けて計算する(省略すると全体で 1 グループ) | PARTITION BY customer_id |
| ORDER BY 列 | グループの中での並び順。順位・累計・前の行などの「順番」の基準になる | ORDER BY ordered_on |
| 枠(フレーム) | 計算に使う行の範囲。ROWS BETWEEN … AND … のように書く | ROWS BETWEEN 2 PRECEDING AND CURRENT ROW |
ROW_NUMBER・RANK・LAG などの専用の関数のほか、SUM・AVG・COUNT などの集計関数も、OVER を付けるとウィンドウ関数として動きます。
Python に標準で入っている SQLite(エスキューライト)を使います。次のコードを sql_window_practice.py という名前で保存してください。「GROUP BY の記事」と同じ、商品(products)・顧客(customers)・注文(orders)の 3 つのテーブルをメモリー上に作ります。データは終了すると消えます。
import sqlite3

con = sqlite3.connect(":memory:")
con.executescript("""
CREATE TABLE products (
  id       INTEGER PRIMARY KEY,
  name     TEXT    NOT NULL,
  category TEXT    NOT NULL,
  price    INTEGER
);
INSERT INTO products VALUES
  (1, 'ノートPC A',     'PC',         98000),
  (2, 'ノートPC B',     'PC',        128000),
  (3, 'マウス',         '周辺機器',    2980),
  (4, 'キーボード',     '周辺機器',    6480),
  (5, 'USBメモリ 32GB', '記録メディア', 1280),
  (6, '外付けSSD 1TB',  '記録メディア', 12800),
  (7, 'モニター 24型',  '周辺機器',   21800),
  (8, 'USBケーブル',    '周辺機器',    NULL);

CREATE TABLE customers (
  id   INTEGER PRIMARY KEY,
  name TEXT    NOT NULL
);
INSERT INTO customers VALUES
  (1, '佐藤'),
  (2, '鈴木'),
  (3, '高橋'),
  (4, '田中');

CREATE TABLE orders (
  id          INTEGER PRIMARY KEY,
  customer_id INTEGER NOT NULL,
  product_id  INTEGER NOT NULL,
  qty         INTEGER NOT NULL,
  ordered_on  TEXT    NOT NULL
);
INSERT INTO orders VALUES
  ( 1, 1, 3, 2, '2026-09-03'),
  ( 2, 2, 1, 1, '2026-09-10'),
  ( 3, 1, 4, 1, '2026-09-18'),
  ( 4, 3, 3, 1, '2026-09-25'),
  ( 5, 2, 5, 5, '2026-10-01'),
  ( 6, 1, 6, 1, '2026-10-02'),
  ( 7, 3, 7, 2, '2026-10-05'),
  ( 8, 2, 3, 3, '2026-10-08'),
  ( 9, 1, 2, 1, '2026-10-10'),
  (10, 3, 5, 2, '2026-10-12');
""")

print("SQL を入力して Enter(終了は exit)")
while True:
    sql = input("sql> ").strip()
    if sql.lower() in ("exit", "quit"):
        break
    if not sql:
        continue
    try:
        cur = con.execute(sql)
    except sqlite3.Error as e:
        print("エラー:", e)
        continue
    if cur.description is None:
        print("(結果の表はありません)")
        continue
    print(" | ".join(d[0] for d in cur.description))
    rows = cur.fetchall()
    for row in rows:
        print(" | ".join("NULL" if v is None else str(v) for v in row))
    print(f"({len(rows)} 行)")
保存したフォルダーで次のコマンドを実行すると「sql>」と表示されるので、この記事の SQL を 1 行で入力して Enter を押します(Python 3.12・SQLite 3.45.3 で確認しました)。
py sql_window_practice.py数量(qty)には 2 が 3 件、1 が 5 件のように同じ値が多いので、順位の付け方の違いを比べるのにちょうどよいデータです。
OVER のかっこを空にすると、テーブル全体が 1 つのウィンドウになります。SELECT id, qty, SUM(qty) OVER () AS 全体合計 FROM orders; を実行すると、10 行すべての「全体合計」に、全注文の数量の合計 19 が付きました。
行が残っているので、自分の行の値と合計を使った計算もできます。次は「その注文が、顧客の合計数量の何 % か」を出す例です(100.0 と小数で書くのは、SQLite では整数どうしの割り算の小数点以下が切り捨てられるためです)。
SELECT id, customer_id, qty, ROUND(qty * 100.0 / SUM(qty) OVER (PARTITION BY customer_id), 1) AS 割合 FROM orders ORDER BY customer_id, id;結果は 10 行のままで、鈴木さん(customer_id 2、合計 9)の注文は id 2 が 11.1、id 5 が 55.6、id 8 が 33.3 になりました。
順位を付ける関数は 3 つあり、同じ値(同順位)があったときの番号の付け方が違います。数量の多い順に、3 つの関数を並べて比べます。
SELECT id, qty, ROW_NUMBER() OVER (ORDER BY qty DESC, id) AS row_num, RANK() OVER (ORDER BY qty DESC) AS rnk, DENSE_RANK() OVER (ORDER BY qty DESC) AS dense FROM orders;id | qty | row_num | rnk | dense
5 | 5 | 1 | 1 | 1
8 | 3 | 2 | 2 | 2
1 | 2 | 3 | 3 | 3
7 | 2 | 4 | 3 | 3
10 | 2 | 5 | 3 | 3
2 | 1 | 6 | 6 | 4
3 | 1 | 7 | 6 | 4
4 | 1 | 8 | 6 | 4
6 | 1 | 9 | 6 | 4
9 | 1 | 10 | 6 | 4
(10 行)数量 2 の 3 件と、数量 1 の 5 件に注目してください。
| 関数 | 同じ値のとき | 数量 2 の 3 件 | その次(数量 1) |
|---|---|---|---|
| ROW_NUMBER() | 同じ値でも別の番号(1, 2, 3, …の連番) | 3・4・5 | 6〜10 |
| RANK() | 同じ番号にし、次は人数分とばす(1, 2, 3, 3, 3, 6) | すべて 3 | 6(4 と 5 はとばす) |
| DENSE_RANK() | 同じ番号にし、次はとばさない(1, 2, 3, 3, 3, 4) | すべて 3 | 4 |
スポーツの順位のように「3 位が 3 人いたら次は 6 位」としたいなら RANK、「何種類目の値か」を知りたいなら DENSE_RANK、同順位があっても必ず 1 行ずつ別の番号が欲しいなら ROW_NUMBER を使います。
ROW_NUMBER の OVER に id を足しているのは、同じ数量の行どうしの順番を決めるためです。ORDER BY で順番が決まらない行どうしの番号は、実行のたびに同じになるとは限りません(SQLite の公式ドキュメントでも、ORDER BY がなければ番号は「任意の順」とされています)。主キーなどの重ならない列を最後に足しておきましょう。
PARTITION BY を書くと、グループごとに 1 から数え直します。カテゴリごとに価格の高い順の順位を付けます。
SELECT name, category, price, RANK() OVER (PARTITION BY category ORDER BY price DESC) AS 順位 FROM products;PC はノートPC B が 1 位・ノートPC A が 2 位、周辺機器はモニター 24型・キーボード・マウスが 1〜3 位で、価格が NULL の USBケーブルは 4 位になりました。
SQLite の公式ドキュメントには「NULL はほかのどの値よりも小さいとみなす」とあるので、DESC では NULL が最後になります。一方、PostgreSQL の公式ドキュメントには「既定では NULL はどの値より大きいものとして並べる(DESC では NULLS FIRST が既定)」とあり、NULL が 1 位になります(PostgreSQL の実機での確認はしていません)。そろえたいときは ORDER BY price DESC NULLS LAST のように明示します(SQLite は 3.30.0 から使えます)。
OVER の中に ORDER BY を書くと、SUM は「最初の行から今の行まで」の合計、つまり累計になります。注文金額(数量 × 価格)を注文日の順に足していきます。
SELECT o.id, o.ordered_on, o.qty * p.price AS 金額, SUM(o.qty * p.price) OVER (ORDER BY o.ordered_on) AS 累計 FROM orders o JOIN products p ON p.id = o.product_id;結果は 10 行で、累計は 5960、103960(5960+98000)、110440 … と増え、最後の id 10 の行で 10 件すべての合計 315720 になりました。
PARTITION BY を足すと、顧客ごとの累計になります。
SELECT id, customer_id, ordered_on, qty, SUM(qty) OVER (PARTITION BY customer_id ORDER BY ordered_on) AS 顧客別累計 FROM orders;佐藤さん(customer_id 1)の 4 件は 2, 3, 4, 5、鈴木さんの 3 件は 1, 6, 9 と、顧客が変わるところで数え直しました。
計算に使う行の範囲(枠)は、ROWS BETWEEN 開始 AND 終了 で指定します。開始と終了には、UNBOUNDED PRECEDING(最初の行)・2 PRECEDING(2 行前)・CURRENT ROW(今の行)・1 FOLLOWING(1 行後)・UNBOUNDED FOLLOWING(最後の行)のように書きます。
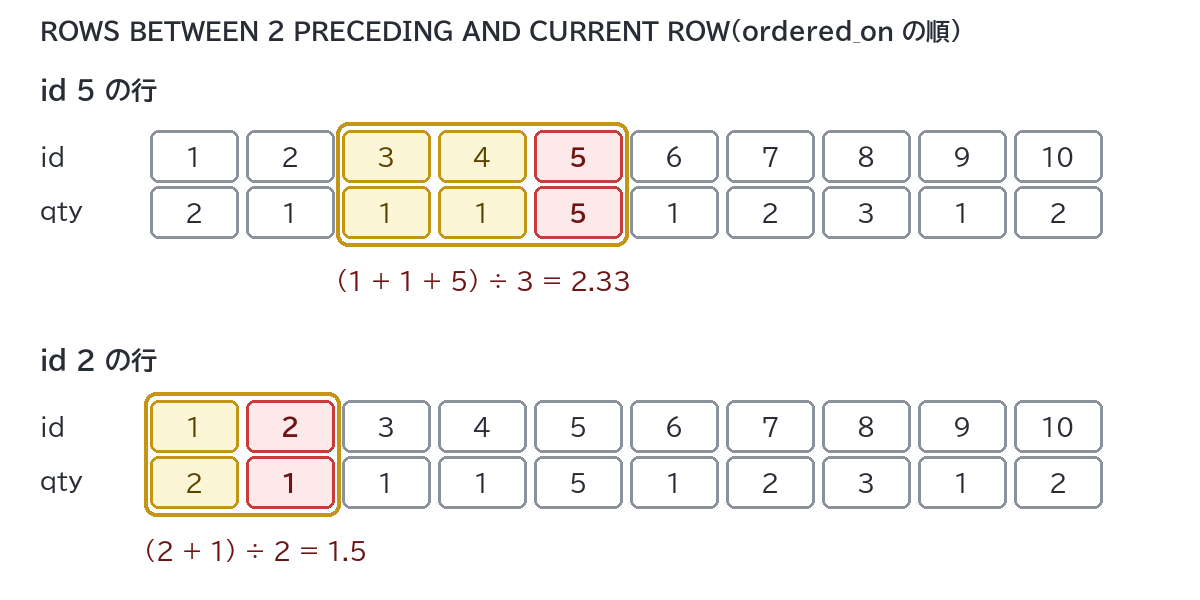
「今の行と、その前の 2 行」の 3 行で平均を取ると、3 件の移動平均になります。最初の 2 行は前の行が足りないので、あるだけの行で平均を取ります。件数も並べて確かめます。
SELECT id, ordered_on, qty, COUNT(*) OVER (ORDER BY ordered_on ROWS BETWEEN 2 PRECEDING AND CURRENT ROW) AS 件数, ROUND(AVG(qty) OVER (ORDER BY ordered_on ROWS BETWEEN 2 PRECEDING AND CURRENT ROW), 2) AS 移動平均 FROM orders;件数は 1 行目が 1、2 行目が 2、3 行目からは 3 になり、移動平均は 2.0、1.5、1.33、1.0、2.33 … となりました。
5 行目(id 5)の 2.33 は、id 3・4・5 の数量(1・1・5)の平均です。最初の 2 行が不要なら、件数が 3 の行だけを残します(絞り込み方は後述の上位 N 件と同じです)。
枠を書かずに ORDER BY だけを書いたときの既定の枠は、ROWS ではなく RANGE です。SQLite の公式ドキュメントには、既定の枠は RANGE BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW で、「最初の行から、今の行とその peer(ピア)までを読む」とあります。peer とは、ORDER BY の値が今の行と同じ行のことです。
ORDER BY の値がすべて違えば ROWS と同じ結果になるので、ここまでの累計は正しく出ていました。ところが、ORDER BY の値が重なると、同じ値の行がまとめて足されます。注文月(ordered_on の先頭 7 文字)の順に累計を出してみます。
SELECT id, ordered_on, qty, SUM(qty) OVER (ORDER BY substr(ordered_on, 1, 7)) AS 累計 FROM orders;id | ordered_on | qty | 累計
1 | 2026-09-03 | 2 | 5
2 | 2026-09-10 | 1 | 5
3 | 2026-09-18 | 1 | 5
4 | 2026-09-25 | 1 | 5
5 | 2026-10-01 | 5 | 19
6 | 2026-10-02 | 1 | 19
7 | 2026-10-05 | 2 | 19
8 | 2026-10-08 | 3 | 19
9 | 2026-10-10 | 1 | 19
10 | 2026-10-12 | 2 | 19
(10 行)9 月の 4 行はどれも「2026-09」で同じ値(peer)なので、4 行とも 9 月全体の合計 5 になりました。1 行ずつ足したいときは、枠を ROWS で書き、ORDER BY に重ならない列を足して順番を決めます。
SELECT id, ordered_on, qty, SUM(qty) OVER (ORDER BY substr(ordered_on, 1, 7), id ROWS BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW) AS 累計 FROM orders;今度は 2, 3, 4, 5, 10, 11, …, 19 と 1 行ずつ増える累計になりました。
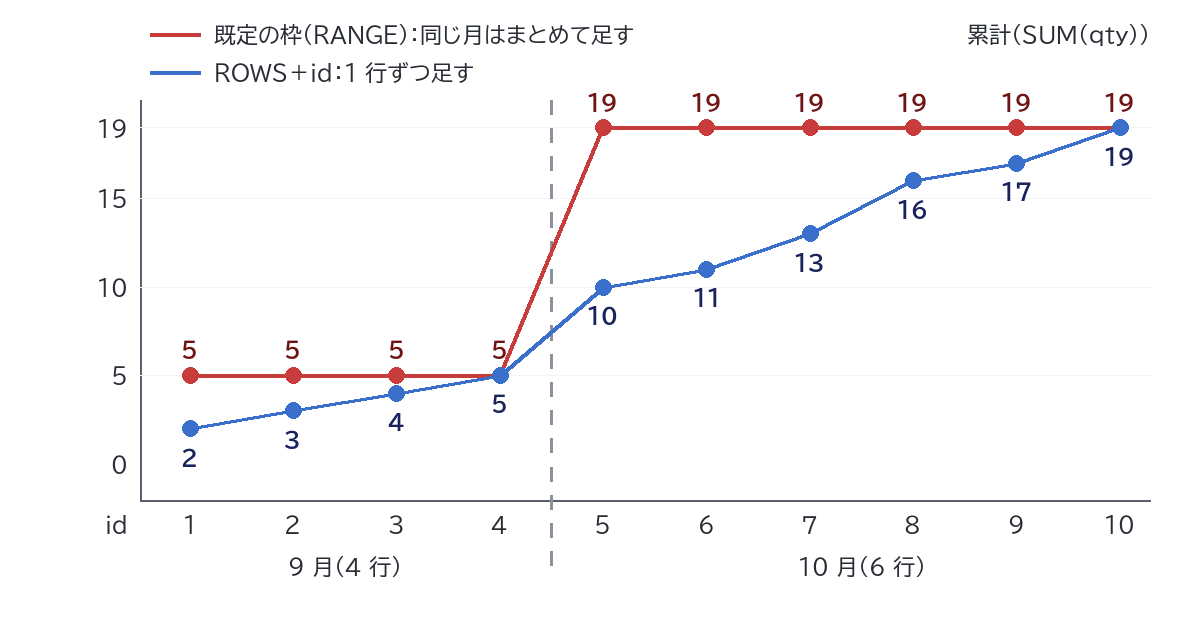
id を足さないと、同じ月の行どうしの順番はデータベースまかせになります。ROWS と「重ならない並び順」はセットで書きましょう。
MySQL 8.0 の公式マニュアルにも同じ規則があり、ORDER BY がないときは既定の枠がグループ全体になるので「ORDER BY を足すと SUM() などの値が変わることがある」と注意しています。SUM(qty) OVER () は 19 でしたが、SUM(qty) OVER (ORDER BY ordered_on) にすると累計(2, 3, 4, …)に変わります。PostgreSQL の公式ドキュメント(バージョン 18)も同じ内容です。
LAG(列) は 1 行前の値、LEAD(列) は 1 行後の値を返します。前回の注文との数量の差を出してみます。
SELECT id, ordered_on, qty, LAG(qty) OVER (ORDER BY ordered_on) AS 前回, qty - LAG(qty) OVER (ORDER BY ordered_on) AS 差, LEAD(qty) OVER (ORDER BY ordered_on) AS 次回 FROM orders;結果は 10 行で、2 行目(id 2)の前回は 2・差は -1、5 行目(id 5)の前回は 1・差は 4 のようになりました。
1 行目の前回と差、10 行目の次回は NULL でした。前の行・次の行がないと NULL になり、NULL との引き算も NULL です。LAG(qty, 1, 0) のように 3 つ目の引数を書くと、NULL の代わりの値(ここでは 0)を指定でき、実行すると id 1 の「前回」は 0 になりました。2 つ目の引数は何行前かを表します。
PARTITION BY と組み合わせると、顧客ごとの「前回の注文からの間隔」が出せます。julianday は SQLite で日付を日数の数値に変える関数です。
SELECT id, customer_id, ordered_on, LAG(ordered_on) OVER (PARTITION BY customer_id ORDER BY ordered_on) AS 前回の注文日, julianday(ordered_on) - julianday(LAG(ordered_on) OVER (PARTITION BY customer_id ORDER BY ordered_on)) AS 間隔日数 FROM orders;佐藤さんの注文は、前回の注文日が NULL・2026-09-03・2026-09-18・2026-10-02、間隔日数が NULL・15.0・14.0・8.0 になりました。
PARTITION BY customer_id があるので、顧客が変わると前の行は見えなくなり、各顧客の最初の注文は NULL になります。
ウィンドウ関数は GROUP BY の集計が終わった後に計算されるので、LAG(SUM(o.qty * p.price)) OVER (ORDER BY substr(o.ordered_on, 1, 7)) のように集計結果を渡して、前月との差も出せます。練習用のデータで月ごとに GROUP BY して試すと、2026-09 が 113420、2026-10 が 202300 で、10 月の行の前月差は 88880 になりました。
「カテゴリごとに価格の高い商品を 2 つずつ」のような、グループごとの上位 N 件はウィンドウ関数の代表的な使い道です。まず、よくある間違いから見ます。順位を WHERE で絞ろうとすると、エラーになります。
SELECT name, category, price FROM products WHERE ROW_NUMBER() OVER (PARTITION BY category ORDER BY price DESC) <= 2;エラー: misuse of window function ROW_NUMBER()SELECT で付けた別名 rn を WHERE rn <= 2 と書いても、「misuse of aliased window function rn」というエラーになりました。
理由は、SQL の処理の順番にあります。SQL は FROM → WHERE → GROUP BY → HAVING → SELECT → ORDER BY の順に処理され、ウィンドウ関数は SELECT の段階で計算されます。WHERE の時点では、まだ順位が決まっていないのです。SQLite の公式ドキュメントには「ウィンドウ関数は SELECT 文の結果の列と ORDER BY 句にしか書けない」、PostgreSQL の公式ドキュメントには「GROUP BY・HAVING・WHERE には書けない。これらの句の処理より後に実行されるため」とあります。
そこで、順位を付ける SELECT をサブクエリにして、外側の WHERE で絞り込みます(PostgreSQL の公式ドキュメントでも、この書き方が案内されています)。
SELECT name, category, price FROM (SELECT name, category, price, ROW_NUMBER() OVER (PARTITION BY category ORDER BY price DESC) AS rn FROM products) AS t WHERE rn <= 2;各カテゴリの価格の 1 位と 2 位、計 6 行(ノートPC B・ノートPC A・モニター 24型・キーボード・外付けSSD 1TB・USBメモリ 32GB)が返りました。
WITH 句で書くと、「① 順位を付ける → ② 2 位までを残す」と上から順に読めます。かっこが多くて読みにくいときは、SQL 整形ツールに貼り付けると、句ごとに改行して見やすく整形できます。
WITH ranked AS (SELECT name, category, price, ROW_NUMBER() OVER (PARTITION BY category ORDER BY price DESC) AS rn FROM products) SELECT category, rn, name, price FROM ranked WHERE rn <= 2 ORDER BY category, rn;category | rn | name | price
PC | 1 | ノートPC B | 128000
PC | 2 | ノートPC A | 98000
周辺機器 | 1 | モニター 24型 | 21800
周辺機器 | 2 | キーボード | 6480
記録メディア | 1 | 外付けSSD 1TB | 12800
記録メディア | 2 | USBメモリ 32GB | 1280
(6 行)上位 N 件で ROW_NUMBER と RANK のどちらを使うかは、同順位の扱いで決めます。「顧客ごとに数量がいちばん多い注文」で比べます。高橋さん(customer_id 3)は、id 7 と id 10 がどちらも数量 2 で同じです。
WITH ranked AS (SELECT id, customer_id, qty, RANK() OVER (PARTITION BY customer_id ORDER BY qty DESC) AS rnk FROM orders) SELECT id, customer_id, qty FROM ranked WHERE rnk = 1;結果は id 1・5・7・10 の 4 行で、高橋さんは同じ 1 位の id 7 と id 10 が両方残りました。RANK() を ROW_NUMBER() に変えると 3 行になり、高橋さんは id 7 だけが残りました。どちらが残るかは ORDER BY で決まっていないので、データベースやデータの入り方で変わり得ます。「同点は全部出したい」なら RANK、「必ず N 行ちょうど」なら ROW_NUMBER に、ORDER BY qty DESC, id のような決め手の列を足して使います。
NTILE(N) は、並べた行を N 個のグループにできるだけ均等に分けて、1〜N の番号を付けます。8 つの商品を価格の高い順に 3 つに分けると、1 が 3 行、2 が 3 行、3 が 2 行になりました(SQLite の公式ドキュメントにも「必要なら大きいグループが先に来る」とあります)。「上位・中位・下位」の区分けに使えます。
SELECT name, price, NTILE(3) OVER (ORDER BY price DESC) AS グループ FROM products;FIRST_VALUE(列) は枠の最初の行の値、LAST_VALUE(列) は枠の最後の行の値を返します。たとえば FIRST_VALUE(name) OVER (PARTITION BY category ORDER BY price DESC) と書くと、各行に「そのカテゴリで最も高い商品」が付き、PC の 2 行には「ノートPC B」が付きました。
同じ考えで LAST_VALUE(name) を使えば「最も安い商品」が出そうですが、そうはなりません(価格が NULL の行は WHERE price IS NOT NULL で除いています)。
SELECT name, category, price, LAST_VALUE(name) OVER (PARTITION BY category ORDER BY price DESC) AS 最安値の商品 FROM products WHERE price IS NOT NULL;結果は、どの行も自分自身の名前(ノートPC B の行なら「ノートPC B」)になりました。既定の枠は「最初の行から今の行まで」なので、枠の最後の行は今の行だからです。枠を UNBOUNDED FOLLOWING まで広げると、期待どおりになります。
SELECT name, category, price, LAST_VALUE(name) OVER (PARTITION BY category ORDER BY price DESC ROWS BETWEEN UNBOUNDED PRECEDING AND UNBOUNDED FOLLOWING) AS 最安値の商品 FROM products WHERE price IS NOT NULL;PC の行には「ノートPC A」、周辺機器の行には「マウス」、記録メディアの行には「USBメモリ 32GB」が付きました。
LAST_VALUE を使うより、FIRST_VALUE(name) OVER (PARTITION BY category ORDER BY price ASC) のように並びを逆にして FIRST_VALUE を使うほうが、枠を気にせずに済みます(WHERE price IS NOT NULL を付けたままで、同じ結果になりました。NULL を除かないと、SQLite では NULL が最も小さい値として先頭に来るので注意します)。
古いバージョンでは使えません。公式情報で確認できた対応バージョンは次のとおりです(2026 年 10 月時点)。
| データベース | 使えるようになったバージョン | 公式情報 |
|---|---|---|
| SQLite | 3.25.0(2018-09-15) | 公式ドキュメント「Window Functions」。EXCLUDE 句・GROUPS の枠などは 3.28.0 から |
| MySQL | 8.0 | リファレンスマニュアルの「What Is New in MySQL 8.0」に、ウィンドウ関数に対応したと記載 |
| PostgreSQL | 8.4 | 8.4.0 のリリースノートに「Add support for WINDOW functions」と記載 |
MySQL 8.0 のマニュアルの「Window Function Restrictions」には、GROUPS の枠・EXCLUDE 句・集計関数の DISTINCT に対応していないと書かれています。また julianday・substr などの関数はデータベースごとに違うので、ほかのデータベースでは書き換えてください(MySQL・PostgreSQL の実機での確認はしていません)。
SQLite のバージョンは SELECT sqlite_version(); で確かめられます(この記事の環境では 3.45.3)。
OVER の中の ORDER BY は、順位や累計を計算する順番を決めるだけで、結果の行の並び順は決めません。顧客別の累計を注文 id の順に表示してみます。
SELECT id, customer_id, qty, SUM(qty) OVER (PARTITION BY customer_id ORDER BY id) AS 顧客別累計 FROM orders ORDER BY id;結果は id 1, 2, 3, … の順に並び、顧客別累計は 2, 1, 3, 1, 6, … と、顧客ごとに正しく計算されたままでした。それまでの例がグループ順に並んでいたのは、SQLite がたまたまその順で返したからです。表示順が大切なら、必ず最後に ORDER BY を書きます。
「全体で何人の顧客が注文したか」を各行に付けようとして SELECT COUNT(DISTINCT customer_id) OVER () FROM orders; と書くと、SQLite では「DISTINCT is not supported for window functions」というエラーになりました。SQLite の公式ドキュメントにも「ウィンドウ関数では DISTINCT を使えない」とあります(MySQL も非対応)。重複を除いた件数は、サブクエリで先に数えてから JOIN します。
相関サブクエリ(外側の行の値を使うサブクエリ)で書けます。たとえば顧客別の累計は、(SELECT SUM(o2.qty) FROM orders o2 WHERE o2.customer_id = o.customer_id AND o2.id <= o.id) を SELECT に書くと、ウィンドウ関数と同じ結果(佐藤さんなら 2, 3, 4, 5)になりました。ただし行ごとにサブクエリを実行する書き方です。