Unicode正規化とは?NFC・NFKCの違いと全角半角をそろえる方法
hr
ENG LIFE BLOG
「金額の数字だけ取り出したいけど、円記号は結果に含めたくない」「debug を含まない行だけを探したい」「パスワードに英大文字・英小文字・数字が全部入っているかチェックしたい」。こうした場面で役に立つのが、正規表現の先読み・後読み(lookahead・lookbehind)です。
この記事では、先読み・後読みの 4 つの書き方と考え方を、実行結果つきで解説します。Python・JavaScript・grep・サクラエディタでの違いや、よくある間違いもまとめます。正規表現の記号そのものに自信がない人は、先に「正規表現の基本」を読むと理解しやすくなります。
この記事の実行結果は、Windows 11 の Python 3.12.6、Microsoft Edge 155(ヘッドレスモードで JavaScript を実行)、Git Bash の GNU grep 3.0、サクラエディタ 2.4.2(bregonig.dll 4.20)で確認したものです。
先読み・後読みは、「この位置の後ろ(または前)に〇〇がある」という条件だけを確かめる書き方です。ふつうの正規表現は文字そのものに一致しますが、先読み・後読みは文字と文字の間の「位置」に一致し、文字を結果に含めません。このことを「文字を消費しない」と言います。
書き方は次の 4 種類です。「先」はその位置より右(後ろの文字)、「後」はその位置より左(前の文字)を見る、と覚えると混乱しません。
| 書き方 | 名前 | 意味 | 例と一致する部分 |
|---|---|---|---|
(?=…) | 肯定先読み | 右側に … がある位置 | \d+(?=円) は「120円」の「120」 |
(?!…) | 否定先読み | 右側に … がない位置 | \d+(?![\d円]) は「80個」の「80」 |
(?<=…) | 肯定後読み | 左側に … がある位置 | (?<=¥)\d+ は「¥980」の「980」 |
(?<!…) | 否定後読み | 左側に … がない位置 | (?<![¥\d])\d+ は「税 98」の「98」 |
後読みは「戻り読み」と呼ばれることもあります(サクラエディタのヘルプはこの呼び方です)。英語では 4 つをまとめて lookaround(ルックアラウンド)と呼びます。
Python で、「数字+円」をふつうに探した場合と、肯定先読みで探した場合を比べます。
import re

text = "りんご 120円、みかん 80個、メロン 1500円"
print(re.findall(r"\d+円", text))
print(re.findall(r"\d+(?=円)", text))
['120円', '1500円']
['120', '1500']どちらも「円が後ろに付いた数字」を探していますが、先読みのほうは結果に「円」が入りません。「80個」は後ろが円ではないので、どちらでも一致しません。
先読みだけで検索すると、一致した部分が空(0 文字)になることも確かめられます。
import re

m = re.search(r"(?=円)", "120円")
print(m.span(), repr(m.group()))
(3, 3) ''(3, 3) は「3 文字目の後ろ(「0」と「円」の間)から始まり、同じ位置で終わる」という意味で、一致した文字は ''(空)です。先読み・後読みは、このように文字ではなく位置を指すものだと押さえておきましょう。^(行の先頭)や \b(単語の境目)も同じ「位置」の仲間です。
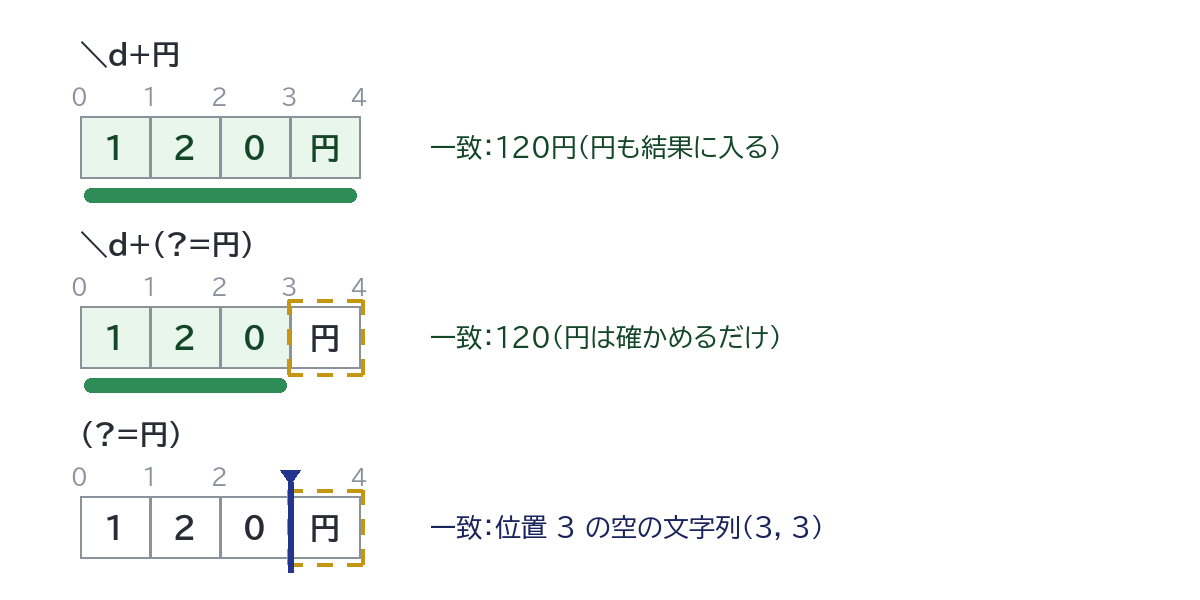
上の \d+(?=円) のように、「後ろに円が続く数字」を、円を含めずに取り出せます。Python の公式ドキュメントでも、Isaac (?=Asimov) は後ろに「Asimov」が続くときだけ「Isaac 」に一致する、という例で説明されています。
「後ろに円が続かない数字」を探してみます。ここには初心者がよくつまずく落とし穴があります。
import re

text = "りんご 120円、みかん 80個"
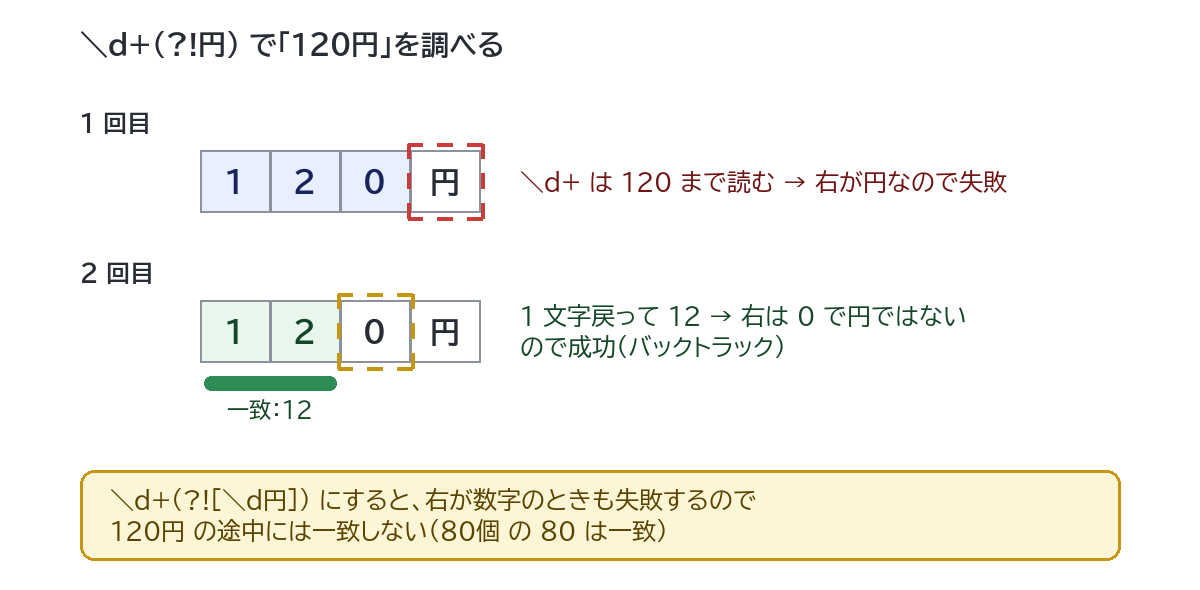
print(re.findall(r"\d+(?!円)", text))
print(re.findall(r"\d+(?![\d円])", text))
['12', '80']
['80']1 行目は「120円」から 12 を取り出してしまいました。\d+ はまず「120」まで読みますが、後ろが「円」なので否定先読みが失敗します。すると正規表現は 1 文字戻して「12」で試し、その後ろは「0」で円ではないので成功してしまうのです(この「戻ってやり直す」動きをバックトラックと言います)。
2 行目のように、(?![\d円])(後ろが数字でも円でもない)と書けば、数字の途中で止まることがなくなり、「80」だけが取れます。
import re

text = "定価 ¥1200 → 特価 ¥980(税 98)"
print(re.findall(r"(?<=¥)\d+", text))
print(re.findall(r"(?<![¥\d])\d+", text))
['1200', '980']
['98']1 行目の (?<=¥)\d+ は「直前が ¥ の数字」なので、円記号の付いた金額だけが、円記号なしで取れます。
上の 2 行目は「直前が ¥ でも数字でもない数字」です。否定先読みと同じ理由で、(?<!¥) だけにすると「¥1200」の途中の「200」などにも一致してしまうため、[¥\d] と数字も入れています。その結果、税額の「98」だけが残りました。
「8 文字以上で、英小文字・英大文字・数字をそれぞれ 1 つ以上含む」という条件は、先読みを並べると 1 つの正規表現で書けます。
import re

pattern = re.compile(r"(?=.*[a-z])(?=.*[A-Z])(?=.*\d).{8,}")
for pw in ["Passw0rd", "password1", "PASSWORD1", "Pass1", "abcDEFgh"]:
    print(pw, bool(pattern.fullmatch(pw)))
Passw0rd True
password1 False
PASSWORD1 False
Pass1 False
abcDEFgh False仕組みはこうです。先読みは文字を消費しないので、3 つの先読みはすべて文字列の先頭という同じ位置から確かめられます。
(?=.*[a-z]):先頭から見て、どこかに英小文字がある(?=.*[A-Z]):どこかに英大文字がある(?=.*\d):どこかに数字がある.{8,}:最後に、全体が 8 文字以上であることを確かめる(ここで初めて文字を消費する)Python では、文字列全体の一致を確かめる fullmatch を使っています。JavaScript なら、先頭の ^ と末尾の $ を付けて test で確かめます。
const re = /^(?=.*[a-z])(?=.*[A-Z])(?=.*\d).{8,}$/; ["Passw0rd", "password1", "Pass1"].map((s) => re.test(s));Edge で実行すると [true, false, false] になりました。
ただし、実際のサービスでどんなパスワードを求めるかは、文字の種類よりも長さを重視する考え方もあり、正規表現で決めることではありません。ここでは「複数の条件を同時に満たすか」を 1 つの式で確かめる書き方の例として見てください。パスワードの保存方法は「パスワードの安全な保存方法」で解説しています。
「1234567」を「1,234,567」にする置換は、先読みの代表的な使い方です。カンマを入れたい「位置」を探して、そこに「,」を入れます。
import re

print(re.sub(r"\B(?=(\d{3})+(?!\d))", ",", "1234567 と 1000 と 999"))
print(f"{1234567:,}")
1,234,567 と 1,000 と 999
1,234,567正規表現の意味を分解すると、次のとおりです。
\B:単語の境目ではない位置(数字の先頭の前にはカンマを入れない)(?=(\d{3})+:その位置の右側に、3 桁の数字のかたまりが 1 回以上続き、(?!\d)):そのすぐ後ろはもう数字ではない(数字の終わりまでちょうど 3 の倍数の桁がある)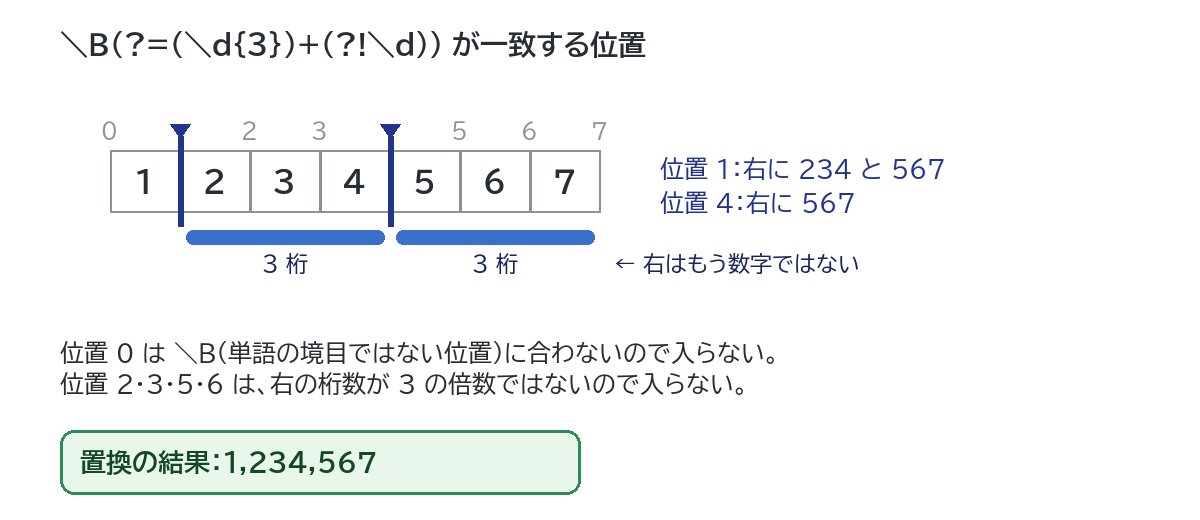
JavaScript でも同じ正規表現が使え、Edge で "1234567 と 1000 と 999".replace(/\B(?=(\d{3})+(?!\d))/g, ",") を実行すると同じ結果になりました。
ただし、数値を表示するだけなら言語の機能を使うほうが確実です。Python なら上の 2 行目の f"{1234567:,}"、JavaScript なら (1234567).toLocaleString("ja-JP") で「1,234,567」になります。正規表現は、文章の中に混ざった数字にまとめてカンマを入れたいときに使いましょう。小数点以下がある数字では、Python で「1234.5678」を置換すると「1,234.5,678」のように小数部分にもカンマが入ったので、そのような文章には使わないでください。
「debug を含まない行」は、行の先頭で否定先読みを使って ^(?!.*debug) と書きます。「行頭から見て、どこにも debug がない」という意味です。
import re

lines = ["ERROR disk full", "INFO start", "INFO debug mode"]
print([s for s in lines if re.match(r"(?!.*debug)", s)])
print([s for s in lines if re.match(r".*(?!debug)", s)])
['ERROR disk full', 'INFO start']
['ERROR disk full', 'INFO start', 'INFO debug mode']re.match は先頭から調べるので、^ を書いたのと同じです。2 行目のように .*(?!debug) と順番を逆にすると、「行末まで読んだ位置の後ろに debug はない」となり、どの行でも成り立ってしまいます。否定先読みは行の先頭に置き、その中に .* を入れるのがポイントです。
なお、コマンドで「含まない行」を探すだけなら、grep -v debug のほうが簡単です。否定先読みは、「ERROR で始まり、user= を含まない行」のように、ほかの条件と組み合わせたいときに役立ちます(後の grep の例で試します)。
後読みは、置換で「目印は残したまま、その後ろだけを書き換える」ときにも便利です。
import re

print(re.sub(r"(?<=¥)\d+", "***", "定価 ¥1200"))
print(re.sub(r"¥\d+", "***", "定価 ¥1200"))
定価 ¥***
定価 ***後読みの「¥」は一致した部分に入らないので、置換しても消えません。後読みを使わない 2 行目では、¥ ごと置き換わりました。
先読みはほとんどの環境で同じように使えますが、後読みの中に長さの決まらないパターン(\s* や \d{3,4} など)を書けるかどうかが環境によって違います。実際に試した結果をまとめます。
| 環境 | 先読み | 後読み | 後読みの中の長さ |
|---|---|---|---|
| Python(re) | 使える | 使える | 固定長のみ(違うとエラー) |
| JavaScript(Edge 155) | 使える | 使える | 可変長も使える |
| grep -P(GNU grep 3.0) | 使える | 使える | 固定長のみ(違うとエラー) |
| grep -E | 使えない | 使えない | エラーにならず、一致もしない |
| sed -E(GNU sed 4.9) | 使えない | 使えない | Invalid preceding regular expression のエラー |
| サクラエディタ(bregonig.dll) | 使える | 使える | 長さの違う選択肢 (?<=id:|user=) は使えた |
| PowerShell 5.1(-match など) | 使える | 使える | 可変長も使えた |
Python の公式ドキュメント(re モジュール)には、後読みの中のパターンは「ある決まった長さの文字列にだけ一致するものでなければならない」と書かれています。abc や a|b はよく、a* や a{3,4} はだめ、という例も載っています。実際に、¥ の後ろの空白の数が決まらない (?<=¥\s*) を使うとエラーになります。
import re

re.findall(r"(?<=¥\s*)\d+", "¥ 1200")
re.error: look-behind requires fixed-width patternエラーの最後の行は「後読みには固定幅のパターンが必要です」という意味です。(?<=¥|JPY ) のように、選択肢の長さが違う(1 文字と 4 文字)場合も同じエラーになりました。回避するには、次のどちらかの書き方にします。
import re

text = "¥1200 と JPY 980"
print(re.findall(r"(?<=¥)\d+|(?<=JPY )\d+", text))
print(re.findall(r"(?:¥|JPY )(\d+)", text))
['1200', '980']
['1200', '980']| でつなぐ( ) で囲む(findall はグループの中身を返す)グループを使う方法は、ほとんどの環境で使えるのでおすすめです。findall とグループの関係は「Python の正規表現入門」で詳しく解説しています。
JavaScript の後読みは、中に長さの決まらないパターンを書けます。MDN の解説によると、後読みの中は現在の位置から右から左へ逆向きに照合されるので、どこから始まるか分からなくても調べられる、という仕組みです。
"¥ 1200 と JPY 980".match(/(?<=(?:¥|JPY)\s*)\d+/g)Edge で実行すると ["1200", "980"] になりました。Python ではエラーになる「空白の数が決まらない」「選択肢の長さが違う」後読みも、そのまま動きます。MDN では、後読みは 2023 年 3 月から主要なブラウザーで広く使える機能(Baseline Widely available)とされています。
grep で先読み・後読みを使うには、Perl 互換の正規表現を使う -P オプションを付けます。次の内容の app.log で試します。
ERROR disk full
INFO start
ERROR timeout user=alice
WARN slow user=bob
INFO debug mode「user=」の後ろの名前だけを取り出します。-o は一致した部分だけを表示するオプションです。
grep -oP '(?<=user=)\w+' app.logalice
bob「ERROR で始まり、user= を含まない行」は、否定先読みと組み合わせます。
grep -P '^ERROR(?!.*user=)' app.log結果は「ERROR disk full」の 1 行だけでした。-P の代わりに -E を付けて grep -oE '(?<=user=)\w+' app.log とすると、エラーは出ませんが何も表示されず、終了ステータスは 1(一致なし)でした。エラーにならないので、使えないことに気づきにくい点に注意してください。
grep -P でも、後読みの中は固定長だけです。grep -oP '(?<=user\s*=)\w+' app.log は「grep: lookbehind assertion is not fixed length」というエラーになりました。このようなときは、\K(ここより左は結果に含めない、という記号)が使えます。
grep -oP 'user\s*=\K\w+' app.log結果は「alice」「bob」で、後読みと同じように名前だけが取り出せました。grep のほかのオプションは「grep コマンドの使い方」を参照してください。
なお、sed は -E を付けても先読み・後読みが使えません(GNU sed 4.9 で試すとエラーになりました)。sed で同じことをするなら、sed -E 's/(user=)\w+/\1X/' のようにグループで残す部分を囲み、\1 で戻します。詳しくは「sed コマンドの使い方」で解説しています。
サクラエディタは、正規表現の処理に bregonig.dll を使っています。サクラエディタ 2.4.2 に付属のヘルプ(正規表現の一覧)には、(?=式) 先読み、(?!式) 否定先読み、(?<=式) 戻り読み、(?<!式) 否定戻り読みが載っています(戻り読みは bregonig.dll のみの機能と書かれています)。
サクラエディタ 2.4.2(bregonig.dll 4.20)の「置換」で、「正規表現」にチェックを入れて試した結果です。
| 置換前の行 | 置換前(正規表現) | 置換後 | 結果 |
|---|---|---|---|
| price $1200 sale $980 tax 98 | (?<=\$)\d+ | [N] | price $[N] sale $[N] tax 98 |
| 120yen 80pcs 1500yen | \d+(?=yen) | [N] | [N]yen 80pcs [N]yen |
| 1234567 1000 999 | (?<=\d)(?=(\d{3})+(?!\d)) | , | 1,234,567 1,000 999 |
| ERROR disk full / INFO start / INFO debug mode(3 行) | ^(?!.*debug) | #(+半角スペース) | debug を含まない 2 行の先頭にだけ「# 」が付いた |
| id:42 user=alice | (?<=id:|user=)\w+ | [X] | id:[X] user=[X] |
最後の例のように、サクラエディタでは長さの違う選択肢(3 文字の「id:」と 5 文字の「user=」)を後読みに並べても動きました。Python では同じ書き方がエラーになります。一方、\s* のような長さの決まらないパターンを後読みに入れた場合は、この記事では確かめていません。サクラエディタでの検索・置換の手順は「サクラエディタの正規表現の使い方」で解説しています。
前に見たとおり、\d+(?!円) は「120円」の「12」に一致します。否定先読み・否定後読みを数字や英字の並びと組み合わせるときは、(?![\d円]) のように「同じ種類の文字も来ない」という条件を入れましょう。
Python の公式ドキュメントにあるとおり、肯定後読みで始まるパターンは、文字列の先頭では一致しません。先頭から調べる re.match と組み合わせると、いつまでも一致しません。
import re

print(re.match(r"(?<=¥)\d+", "¥1200"))
print(re.search(r"(?<=¥)\d+", "¥1200"))
None
<re.Match object; span=(1, 5), match='1200'>後読みを使うときは、re.search や re.findall を使いましょう。
「debug を含まない行」を .*(?!debug) と書くと、すべての行に一致します。先読み・後読みは「どの位置で確かめるか」がすべてです。行全体について確かめたいなら ^(?!.*debug) のように行頭に置きます。
grep は -P が必要です。-E ではエラーにならず一致もしないので、「該当する行がない」と勘違いしやすいです。sed では使えないので、グループと \1 で書き換えます。
また、この記事の確認中、Git Bash の環境変数 LANG が空のまま grep -P を実行すると「grep: -P supports only unibyte and UTF-8 locales」というエラーになりました。ふつうに開いた Git Bash の画面では LANG が ja_JP.UTF-8 に設定されていて、エラーは出ませんでした。このエラーが出たら、echo $LANG で設定を確かめてください。
取り出すだけなら、グループで書けることがほとんどです。(?<=¥)\d+ は ¥(\d+) と書き、グループ 1 を使えば同じ数字が取れます。グループは対応している環境が多く、読みやすいので、先読み・後読みでないと書けないとき(パスワードのような複数条件、カンマを入れる位置の指定、否定の条件)に使うのがおすすめです。
先読み・後読みそのものはグループとして数えられませんが、中に書いた ( ) はグループになります。たとえば re.findall(r"\B(?=(\d{3})+(?!\d))", "1234567") を実行すると、結果はカンマを入れる位置ではなく、中のグループの内容 ['567', '567'] になりました。グループにしたくない場合は (?:\d{3}) と書きます(このときの結果は、0 文字の一致が 2 つで ['', ''] でした)。
文字列を左から右へ読み進めるイメージで、「これから読む先(右)を見る」のが先読み、「もう読んだ後ろ(左)を振り返る」のが後読みです。書き方では、後読みにだけ <(左向きの矢印)が付く、と覚えると区別できます。
(?=…) (?!…) は右側、後読み (?<=…) (?<!…) は左側を確かめる。どれも「位置」に一致し、文字を消費しない[\d円] のように条件を足す