CORSとは?エラーの原因と正しい設定を2つのローカルサーバーで確かめる
hr
ENG LIFE BLOG
ブラウザーのアドレス欄に表示される URL は、「https」「example.com」「/docs/page.html」のような部品を、決まった区切り記号でつないだものです。部品の名前と役割が分かると、API の仕様書を読むとき・リンクを書くとき・不具合を調べるときに迷わなくなります。
この記事では、URL を部品ごとに分解して、それぞれの役割を説明します。Python の urllib.parse と、自分の PC だけで動くテスト用サーバーで実際に確かめた結果を載せています。
../ や / で始まるリンク)がどの URL になるかURL(Uniform Resource Locator)は、インターネット上の「どこにある、何を」を 1 行で表す書き方です。共通の書き方は RFC 3986 という仕様で決まっていて、ブラウザーの動きは WHATWG の URL Standard という仕様で決まっています。この記事では、次の URL を例に使います。
https://user@example.com:8080/docs/page.html?q=abc&lang=ja#section2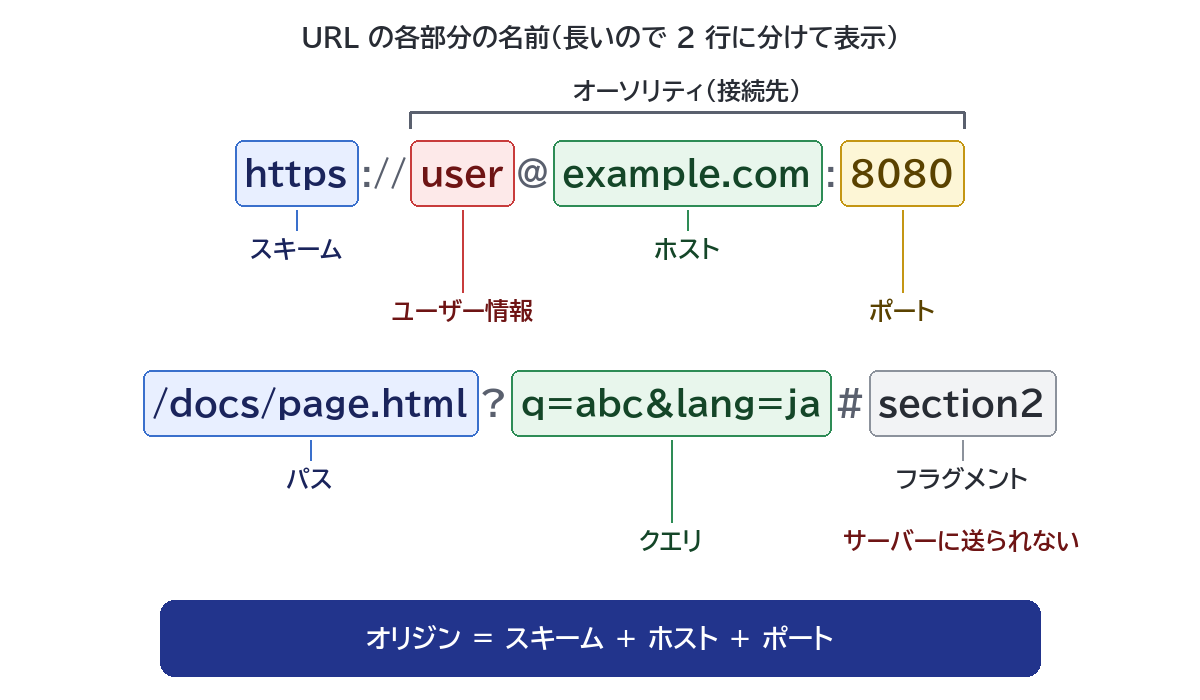
| 部品 | 例 | 区切り記号 | 役割 |
|---|---|---|---|
| スキーム | https | 後ろに「://」 | 通信の方式(プロトコル) |
| ユーザー情報 | user | 後ろに「@」 | ログイン名など。普段の Web ではほぼ使わない |
| ホスト | example.com | ― | 接続先のサーバーの名前(ドメイン名や IP アドレス) |
| ポート | 8080 | 前に「:」 | サーバーの中の窓口の番号。省略すると既定の番号 |
| パス | /docs/page.html | 「/」で始まる | サーバーの中のどのページ・データか |
| クエリ | q=abc&lang=ja | 前に「?」 | 検索語や絞り込み条件などの追加の情報 |
| フラグメント | section2 | 前に「#」 | ページの中の位置。サーバーには送られない |
ユーザー情報・ホスト・ポートの 3 つをまとめてオーソリティ(接続先)と呼びます。RFC 3986 では、URL は大きく「スキーム・オーソリティ・パス・クエリ・フラグメント」の 5 つに分かれ、オーソリティの中がさらに 3 つに分かれる、という形で説明されています。
Python の標準ライブラリ urllib.parse の urlsplit() を使うと、URL を部品に分けられます。次のコードを split_url.py という名前で保存します。
from urllib.parse import urlsplit

u = urlsplit("https://user@example.com:8080/docs/page.html?q=abc&lang=ja#section2")
print(u.scheme)    # スキーム
print(u.netloc)    # ユーザー情報+ホスト+ポート
print(u.username)  # ユーザー情報
print(u.hostname)  # ホスト
print(u.port)      # ポート
print(u.path)      # パス
print(u.query)     # クエリ
print(u.fragment)  # フラグメント
保存したフォルダーで次のコマンドを実行します。
py split_url.pyPython 3.12 で実行した結果です。区切り記号(「://」「@」「:」「?」「#」)は取り除かれ、部品だけが取り出されています。netloc がオーソリティにあたります。
https
user@example.com:8080
user
example.com
8080
/docs/page.html
q=abc&lang=ja
section2先頭の https や http がスキームです。どの方式で取りに行くかを表します。Web 以外にも、mailto:(メールの宛先)や file:(PC の中のファイル)、ftp: などがあります。http と https の違いは「HTTP と HTTPS の違い」で詳しく解説しています。
example.com の部分がホストです。ドメイン名のときは、DNS という仕組みで IP アドレスに変換されてから接続します(「DNS とは?」参照)。127.0.0.1 のように IP アドレスを直接書くこともできます。
ポートは、1 台のサーバーの中で「どの窓口(プログラム)につなぐか」を表す番号です。普段の URL にポートが書かれていないのは、スキームごとに既定のポートが決まっていて、省略するとそれが使われるからです。WHATWG URL Standard では、次のように決められています。
| スキーム | 既定のポート |
|---|---|
| http | 80 |
| https | 443 |
| ws(WebSocket) | 80 |
| wss(暗号化した WebSocket) | 443 |
| ftp | 21 |
つまり https://example.com/ と https://example.com:443/ は同じ場所を指します。開発中のサーバーで http://127.0.0.1:8000/ のようにポートを書くのは、80 や 443 以外の番号で待ち受けているためです。ポート番号そのものは「ポート番号とは?」で解説しています。
なお、Python の urlsplit() は既定のポートを補いません。ポートを書いていない URL では port が None になります。
from urllib.parse import urlsplit

print(urlsplit("http://example.com/").port)
実行すると None と表示されます。80 として扱いたいときは、自分のコードで補います。
スキーム・ホスト・ポートの 3 つの組み合わせをオリジンと呼びます。WHATWG URL Standard では、http や https の URL のオリジンを「スキーム、ホスト、ポート」の組として定義しています。ブラウザーは、オリジンが 1 つでも違うページどうしのデータのやり取りを制限します(同一オリジンポリシー)。
| URL | https://example.com と同じオリジンか |
|---|---|
| https://example.com/other/page | 同じ(パスはオリジンに含まれない) |
| https://example.com:443/ | 同じ(443 は https の既定のポート) |
| http://example.com/ | 違う(スキームが違う) |
| https://www.example.com/ | 違う(ホストが違う) |
| https://example.com:8443/ | 違う(ポートが違う) |
フロントエンドとバックエンドでポートが違うだけで「CORS エラー」になるのは、このためです。詳しくは「CORS とは?」で、2 つのローカルサーバーを使って確かめています。
/docs/page.html がパスです。フォルダーとファイルのように「/」で区切って階層を表しますが、実際のファイルの場所と一致するとは限りません。静的なサイトではファイルの置き場所にそのまま対応することが多い一方、Web アプリや API では /users/42 のように、プログラムが「ユーザー 42 番のデータ」と解釈するための文字列として使われます。
? の後ろの q=abc&lang=ja がクエリです。検索語・ページ番号・並び順など、パスだけでは表しきれない条件を渡すのに使います。クエリの書き方は次の章で詳しく見ます。
# の後ろの section2 がフラグメントです。HTML のページなら、id="section2" の付いた要素の位置までスクロールする、といった使い方をします。この記事の目次のリンクも同じ仕組みです。
RFC 3986 には、フラグメントは URL のほかの部分から切り離され、ユーザーエージェント(ブラウザーなど)だけが扱うと書かれています。つまり、フラグメントはサーバーに送られません。次の章で、実際に確かめます。
user@ の部分がユーザー情報です。user:password@ の形でパスワードまで書ける作りになっていますが、RFC 3986 では「user:password」の形は非推奨(使わないほうがよい)とされ、認証情報を平文で渡すことはセキュリティ上の危険だと書かれています。さらに、HTTP の仕様(RFC 9110)では、http と https の URL を作る側はユーザー情報を書いてはならないとされています。理由と危険な例は、後の「紛らわしい URL」で説明します。
Python には、テスト用の簡単な Web サーバーが付いています。自分の PC の中だけで動かし、アクセスの記録(アクセスログ)を見てみましょう。空のフォルダーを作り、そこで次のコマンドを実行します。--bind 127.0.0.1 は「この PC の中からの接続だけを受け付ける」という指定で、ほかの PC からは見えません。
py -m http.server 8000 --bind 127.0.0.1「Serving HTTP on 127.0.0.1 port 8000 (http://127.0.0.1:8000/) …」と表示されたら待ち受け中です。この画面はそのままにして、ブラウザーのアドレス欄に次の URL を入れて開きます。
http://127.0.0.1:8000/?q=abc&lang=ja#section2サーバーの画面には、次のようなアクセスログが 1 行出ます(日時の部分は実行した時刻になります)。Microsoft Edge 155 のヘッドレスモード(画面を出さずに動かすモード)で開いたときの記録です。
127.0.0.1 - - [23/Oct/2026 05:43:59] "GET /?q=abc&lang=ja HTTP/1.1" 200 -サーバーが受け取ったのは /?q=abc&lang=ja までで、#section2 はどこにも出てきません。一方、ブラウザーの中では、JavaScript の location.hash で #section2 を読み取れることも確認しました。フラグメントはブラウザーの中だけで使われる情報だ、ということが分かります。
別の PowerShell の画面から curl で送っても同じです。-v を付けると、送ったリクエストの中身が表示されます(Windows 11 に入っている curl.exe で確認しました)。
curl.exe -v -s -o NUL "http://127.0.0.1:8000/?q=abc&lang=ja#section2"表示の中の「> GET」で始まる行は > GET /?q=abc&lang=ja HTTP/1.1 で、ここにも #section2 は入っていません。確認が終わったら、サーバーの画面で Ctrl+C を押して止めます。curl の使い方は「curl コマンドの使い方」で解説しています。
このため、「# の後ろに書いた値をサーバー側のプログラムで読む」ことはできません。サーバーで使いたい値はクエリに入れます。逆に、# の後ろなら秘密にできる、というわけでもありません。ブラウザーの履歴やアドレス欄には残り、ページの JavaScript からは読めます。
クエリは、名前=値 の組を & でつなげて書くのが一般的です。q=abc&lang=ja なら、「q が abc」「lang が ja」の 2 組です。parse_qs() で分けると、値は同じ名前が何度出てもよいようにリストで返ってきます。
困るのは、値の中に「&」「=」や日本語・空白が入るときです。次のコードで確かめます。
from urllib.parse import parse_qs, urlencode, quote

print(parse_qs("q=abc&lang=ja"))
print(parse_qs("tag=a&b=c"))        # 値の & をそのまま書いた
print(parse_qs("tag=a%26b%3Dc"))    # & を %26、= を %3D にした
print(urlencode({"q": "東京 タワー", "tag": "a&b=c"}))
print(quote("東京 タワー"))
実行結果です。
{'q': ['abc'], 'lang': ['ja']}
{'tag': ['a'], 'b': ['c']}
{'tag': ['a&b=c']}
q=%E6%9D%B1%E4%BA%AC+%E3%82%BF%E3%83%AF%E3%83%BC&tag=a%26b%3Dc
%E6%9D%B1%E4%BA%AC%20%E3%82%BF%E3%83%AF%E3%83%BC& で区切られて「tag が a」「b が c」の 2 組になってしまいました& を %26、= を %3D に置き換える(URL エンコード)と、正しく 1 つの値として読めますurlencode() に辞書を渡すと、日本語は UTF-8 のバイトごとに %XX になり、組み立てまで自動でしてくれます。空白は + になりますquote() では空白が %20 になります。Python のドキュメントによると、urlencode() は既定で quote_plus()(空白を + にするフォーム形式)を使います文字列をつなげてクエリを手作りすると、値に記号が入ったときに壊れます。Python なら urlencode()、JavaScript なら URLSearchParams のように、組み立てる関数に任せるのが安全です。ちょっと確かめたいだけなら、「URL エンコード・デコードツール」に貼り付けると、エンコード・デコードや、クエリをキーと値の表に分解した結果をブラウザーの中だけで確認できます。エンコードの規則や encodeURIComponent との違いも、ツールのページで解説しています。
Python から URL にリクエストを送る方法は「Python で HTTP リクエストを送る方法」を参照してください。
HTML の <a href="../img/logo.png"> のように、URL の一部だけを書いたものを相対 URL と呼びます。ブラウザーは、今開いているページの URL(基準の URL)と組み合わせて、完全な URL を作ります。Python の urljoin() で同じ計算ができるので、よく使う書き方をまとめて試します。
from urllib.parse import urljoin

base = "https://example.com/docs/guide/page.html"
for ref in ["intro.html", "../img/logo.png", "../../top.html",
            "/about", "?page=2", "#top", "//cdn.example.net/app.js"]:
    print(f"{ref:26} -> {urljoin(base, ref)}")
実行結果です。
intro.html                 -> https://example.com/docs/guide/intro.html
../img/logo.png            -> https://example.com/docs/img/logo.png
../../top.html             -> https://example.com/top.html
/about                     -> https://example.com/about
?page=2                    -> https://example.com/docs/guide/page.html?page=2
#top                       -> https://example.com/docs/guide/page.html#top
//cdn.example.net/app.js -> https://cdn.example.net/app.js| 書き方 | 意味 |
|---|---|
| intro.html | 今のページと同じフォルダー(/docs/guide/)のファイル |
| ../ | 1 つ上のフォルダー。2 つ重ねると 2 つ上 |
| /about | 「/」で始まると、ホストの直下から数える |
| ?page=2 | パスはそのままで、クエリだけ入れ替える |
| #top | 同じページの中の位置 |
| //cdn.example.net/… | スキームだけ今のページと同じにして、ホストから指定する |
基準の URL が /docs/guide/page.html のとき、最後の page.html は「ファイル名」として扱われ、/docs/guide/ が基準のフォルダーになります。ここを勘違いして ../ の数を 1 つ間違える、というのがよくあるミスです。この結果は、RFC 3986 の 5.4 節にある例(基準 http://a/b/c/d;p?q に対して ../g は http://a/b/g、/g は http://a/g など)とも一致します。ヘッドレスの Edge で JavaScript の new URL("../img/a.png", "https://example.com/docs/guide/page.html") を実行した結果も https://example.com/docs/img/a.png で、同じでした。
なお、Python のドキュメントは、urljoin() の第 2 引数に完全な URL(// や https:// で始まるもの)を渡すと、そのホストに置き換わるため、攻撃者が操作できる値を渡すのは安全ではないと注意しています。上の結果の最後の行がその例です。
RFC 3986 では、スキームとホストは大文字・小文字を区別しない(正規の形は小文字)とされています。それ以外の部分(パスやクエリなど)は、スキームで特に決めていなければ区別するものとして扱う、と書かれています。
| 部品 | 大文字・小文字 |
|---|---|
| スキーム(HTTPS と https) | 区別しない |
| ホスト(Example.COM と example.com) | 区別しない |
| パス・クエリ・フラグメント | 区別するものとして扱う。実際に同じページが返るかはサーバーの作り次第 |
ヘッドレスの Edge で new URL("HTTPS://Example.COM:443/Docs/Page.html").href を確かめると、https://example.com/Docs/Page.html になりました。スキームとホストは小文字になり、既定のポート 443 は省かれ、パスの /Docs/Page.html はそのまま残っています。Python の urlsplit() でも、hostname は example.com(小文字)、path は /Docs/ のように大文字が残ることを確認しました。
パスを区別するかどうかはサーバー次第なので、「Windows のサーバーで動いていたリンクが、Linux のサーバーに移したら 404 になった」ということが起こりえます。リンクは実際のパスと大文字・小文字までそろえて書くのが確実です。
ユーザー情報の仕組みは、フィッシング(本物のサイトになりすます詐欺)に悪用されることがあります。次の URL の接続先はどこでしょうか。
from urllib.parse import urlsplit

for url in ["https://example.com@evil.example/login",
            "https://example.com.evil.example/login",
            "https://evil.example/example.com/login"]:
    u = urlsplit(url)
print(u.hostname, "| username =", u.username)実行結果です。evil.example は説明のための架空のドメインで、このコードはどこにも接続しません。
evil.example | username = example.com
example.com.evil.example | username = None
evil.example | username = None@ より前の example.com はユーザー名として扱われ、実際の接続先は evil.example です。ヘッドレスの Edge の new URL() でも、hostname は evil.example、username は example.com でしたexample.com.evil.example で、evil.example の中の名前です。ドメイン名は右端から読みますexample.com はパスの一部にすぎず、接続先は evil.example ですRFC 3986 のセキュリティの節にも、ユーザー情報を使って人に別のホストだと思い込ませる例が載っています。RFC 9110 も、ユーザー情報は認証元をごまかすフィッシングに使われている可能性が高いとして、受け取った側はエラーとして扱うべきだとしています。WHATWG URL Standard は、ブラウザーは URL のユーザー名とパスワードを表示すべきでない(ホストと見間違えられるため)としています。
プログラムで「自分のサイトの URL か」をチェックするときは、文字列に example.com が含まれるか・で始まるか、では判定できません。上の 3 つはどれも example.com を含みます。urlsplit() などで分解したホストが、許可したものと完全に一致するかで判定します。ただし Python のドキュメントは、urlsplit() は入力が正しい URL かどうかを検証しない(おかしな入力でもエラーにならないことがある)とも注意しているので、セキュリティに関わる判定では、取り出した値をさらに自分のコードで確かめます。
すでに ? の付いた URL に、さらに ?page=2 を足すと /search?q=abc?page=2 になり、q の値が「abc?page=2」になってしまいます。2 つ目以降は & でつなぎます。既存の URL にパラメーターを足すときは、一度分解してから組み立て直すと間違えません。
上で確かめたとおり、フラグメントはサーバーに届きません。/page#id=42 のように書いても、サーバーのプログラムは 42 を受け取れません。また、クエリより後ろに # を置くのが正しい順番です。/page#top?q=abc と書くと、?q=abc までフラグメントの一部になります。
URL はブラウザーの履歴・サーバーのアクセスログ(上の実験のログにもクエリがそのまま残りました)・共有したリンクなどに残ります。パスワードや API キーは URL に入れず、HTTP のヘッダーやリクエストの本文で送ります。ログイン状態を保つ仕組みは「Cookie とセッションの仕組み」で解説しています。
RFC 3986 は URI(Uniform Resource Identifier)の仕様で、URL はその中の「場所を示して取りに行ける」ものを指す呼び方です。WHATWG URL Standard は、両方をまとめて「URL」と呼んでいます。普段の Web 開発では、ほぼ同じ意味だと考えて困ることはありません。
URL としては別のものです。同じページを返すか、片方へ転送(リダイレクト)するかは、サーバーの設定次第です。また、上の相対 URL の例のとおり、末尾に「/」があるかどうかで ../ などの基準のフォルダーが変わります。
new URL() を使います。ヘッドレスの Edge で冒頭の例の URL を分解すると、protocol は https:(末尾の「:」付き)、hostname は example.com、port は 8080、pathname は /docs/page.html、search は ?q=abc&lang=ja、hash は #section2、origin は https://example.com:8080 でした。Python と違い、区切り記号の「:」「?」「#」が付いたまま返る点に注意してください。