SQLのJOINの種類と使い分け|INNER・LEFT・RIGHT・FULLを実行結果で解説
hr
ENG LIFE BLOG
SQL の UNION(ユニオン)は、2 つの SELECT の結果を縦につないで 1 つの表にする命令です。似た名前の UNION ALL との違いは、重複した行を取り除くかどうかだけですが、結果の行数や速さが変わるので、使い分けを知っておくことが大切です。
この記事では、「去年の注文」と「今年の注文」の練習用テーブルで、UNION と UNION ALL の違い、列数のエラー、ORDER BY・LIMIT の位置、INTERSECT・EXCEPT、UNION ALL が速い理由を、実行結果と一緒に解説します。SELECT・WHERE・ORDER BY の基本は「SQL入門:SELECT文の基本」で解説しています。
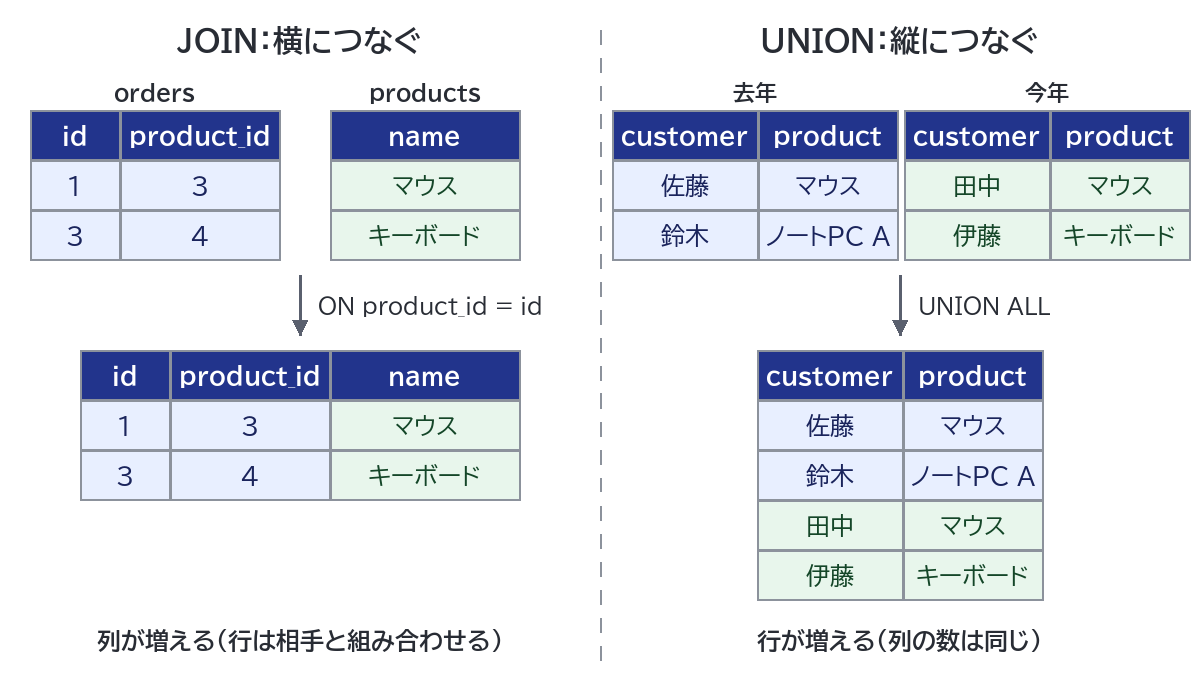
テーブルをつなぐ命令には JOIN もありますが、つなぐ向きが違います。JOIN は行どうしを条件で組み合わせて横につなぎ、列が増えます(注文の行の右に商品名の列を付け足す、など)。UNION は 1 つ目の結果の下に 2 つ目の結果を縦に積み、列の数は変わらず行が増えます(去年の注文の下に今年の注文を並べる、など)。
UNION の仲間には、両方の結果にある行だけを残す INTERSECT と、片方にだけある行を残す EXCEPT があります。まとめて「集合演算」と呼ばれ、SQLite の公式ドキュメントでは、これらで SELECT をつないだものを compound SELECT(複合 SELECT)と呼んでいます。
| 命令 | 結果に残る行 | 重複した行 |
|---|---|---|
| UNION ALL | 両方の結果のすべての行 | そのまま残す |
| UNION | 両方の結果のすべての行 | 1 行にまとめる |
| INTERSECT | 両方の結果にある行だけ | 1 行にまとめる |
| EXCEPT | 1 つ目の結果にあって、2 つ目の結果にない行だけ | 1 行にまとめる |
Python に標準で入っている SQLite(エスキューライト)を使います。次のコードを sql_union_practice.py という名前で保存してください。去年の注文(last_year_orders)と今年の注文(this_year_orders)の 2 つのテーブルをメモリー上に作ります。データは終了すると消えます。
import sqlite3

con = sqlite3.connect(":memory:")
con.executescript("""
CREATE TABLE last_year_orders (
  id       INTEGER PRIMARY KEY,
  customer TEXT,
  product  TEXT    NOT NULL,
  price    INTEGER NOT NULL
);
INSERT INTO last_year_orders VALUES
  (1, '佐藤', 'マウス',         2980),
  (2, '鈴木', 'ノートPC A',    98000),
  (3, '高橋', 'キーボード',     6480),
  (4, NULL,   'USBメモリ 32GB', 1280),
  (5, '佐藤', 'マウス',         2980);

CREATE TABLE this_year_orders (
  id       INTEGER PRIMARY KEY,
  customer TEXT,
  product  TEXT    NOT NULL,
  price    INTEGER NOT NULL
);
INSERT INTO this_year_orders VALUES
  (1, '佐藤', '外付けSSD 1TB', 12800),
  (2, '田中', 'マウス',         2980),
  (3, '鈴木', 'ノートPC A',    98000),
  (4, NULL,   'マウス',         2980),
  (5, '伊藤', 'キーボード',     6480);
""")

print("SQL を入力して Enter(終了は exit)")
while True:
    sql = input("sql> ").strip()
    if sql.lower() in ("exit", "quit"):
        break
    if not sql:
        continue
    try:
        cur = con.execute(sql)
    except sqlite3.Error as e:
        print("エラー:", e)
        continue
    if cur.description is None:
        print("(結果の表はありません)")
        continue
    print(" | ".join(d[0] for d in cur.description))
    rows = cur.fetchall()
    for row in rows:
        print(" | ".join("NULL" if v is None else str(v) for v in row))
    print(f"({len(rows)} 行)")
保存したフォルダーで次のコマンドを実行すると「sql>」と表示されるので、この記事の SQL を 1 行で入力して Enter を押します(Python 3.12・SQLite 3.45.3 で確認しました)。
py sql_union_practice.py2 つのテーブルの中身は次のとおりです。customer が顧客名、product が商品名、price が金額です。customer が NULL(値がない)の行は、会員登録をせずに買った「ゲスト購入」という想定です。
SELECT * FROM last_year_orders;id | customer | product | price
1 | 佐藤 | マウス | 2980
2 | 鈴木 | ノートPC A | 98000
3 | 高橋 | キーボード | 6480
4 | NULL | USBメモリ 32GB | 1280
5 | 佐藤 | マウス | 2980
(5 行)SELECT * FROM this_year_orders;id | customer | product | price
1 | 佐藤 | 外付けSSD 1TB | 12800
2 | 田中 | マウス | 2980
3 | 鈴木 | ノートPC A | 98000
4 | NULL | マウス | 2980
5 | 伊藤 | キーボード | 6480
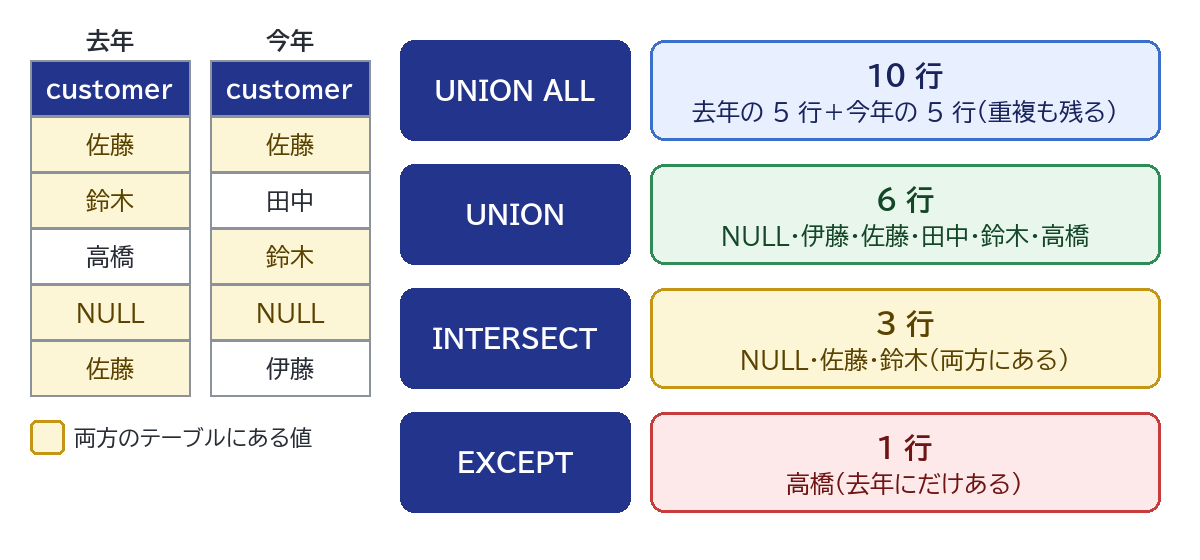
(5 行)佐藤さん・鈴木さん・NULL は両方の年に、高橋さんは去年だけ、田中さん・伊藤さんは今年だけ出てきます。また、去年の佐藤さんはマウスを 2 回買っていて(同じテーブルの中の重複)、鈴木さんは去年も今年もノートPC A を買っています(テーブルをまたぐ重複)。
書き方は、2 つの SELECT の間に UNION または UNION ALL を書くだけです。
SELECT 列名 FROM テーブル1 UNION ALL SELECT 列名 FROM テーブル2;まず、2 年分の注文の顧客名を UNION ALL でつないでみます。
SELECT customer FROM last_year_orders UNION ALL SELECT customer FROM this_year_orders;customer
佐藤
鈴木
高橋
NULL
佐藤
佐藤
田中
鈴木
NULL
伊藤
(10 行)去年の 5 行の下に、今年の 5 行がそのまま続き、合計 10 行になりました。佐藤さんは 3 回、鈴木さんと NULL は 2 回ずつ出てきます。UNION ALL は重複を気にせず、すべての行を残します。
同じ SQL を UNION にすると、結果が変わります。
SELECT customer FROM last_year_orders UNION SELECT customer FROM this_year_orders;customer
NULL
伊藤
佐藤
田中
鈴木
高橋
(6 行)10 行が 6 行になりました。UNION は、つないだ結果から重複した行を取り除きます。2 つのテーブルにまたがる重複(佐藤さん・鈴木さん)だけでなく、去年のテーブルの中の重複(佐藤さんの 2 回)もまとめて 1 行になっています。「2 年間に一度でも注文した顧客の一覧」を作りたいなら UNION、「2 年分の注文を 1 件ずつ全部並べたい」なら UNION ALL、という使い分けです。
なお、この結果は並べ替えたように見えますが、ORDER BY を付けていないので並び順は保証されません(SQLite の公式ドキュメントにも「ORDER BY がなければ行の順番は未定義」とあります)。
上の UNION の結果で、NULL は 1 行だけになっています。SQL では SELECT NULL = NULL; を実行すると、「等しい(1)」ではなく NULL(不明)が返ります。
それでも UNION では 2 つの NULL が 1 行にまとまりました。SQLite の公式ドキュメントには「compound SELECT の重複行を判定するときは、NULL は他の NULL と等しく、NULL 以外のすべての値とは異なるものとみなす」と書かれています。WHERE の比較では NULL どうしは等しくならないが、UNION・INTERSECT・EXCEPT の重複判定では等しい扱いになる、と覚えておきましょう。NULL の扱い全般は「SQLのNULLの扱い方」で解説しています。
列が 2 つ以上あるときは、すべての列の値が同じ行だけが重複とみなされます。顧客名と商品名の 2 列でつないでみます。
SELECT customer, product FROM last_year_orders UNION SELECT customer, product FROM this_year_orders;customer | product
NULL | USBメモリ 32GB
NULL | マウス
伊藤 | キーボード
佐藤 | マウス
佐藤 | 外付けSSD 1TB
田中 | マウス
鈴木 | ノートPC A
高橋 | キーボード
(8 行)UNION ALL なら 10 行のところ、8 行になりました。まとめられたのは「佐藤 | マウス」(去年の 2 回)と「鈴木 | ノートPC A」(去年と今年)の 2 組です。「佐藤 | マウス」と「佐藤 | 外付けSSD 1TB」は商品名が違うので、別の行として残ります。
縦に積むので、上と下の SELECT の列の数は同じでなければなりません。1 つ目を 2 列、2 つ目を 1 列にすると、エラーになります。
SELECT customer, product FROM last_year_orders UNION SELECT customer FROM this_year_orders;エラー: SELECTs to the left and right of UNION do not have the same number of result columns「UNION の左右の SELECT の結果の列の数が同じではない」という意味です。片方にしかない列があるときは、もう片方に NULL や 0 などの値を置いて、列の数をそろえます(例:SELECT customer, product FROM ... UNION ALL SELECT customer, NULL FROM ...)。
上と下で別名(AS)を変えると、結果の列名はどちらになるでしょうか。
SELECT customer AS 顧客 FROM last_year_orders UNION SELECT product AS 商品 FROM this_year_orders;結果の列名は 1 つ目の SELECT の「顧客」になり、2 つ目の「商品」は無視されました(顧客名と商品名が混ざった 8 行が返りました)。MySQL の公式マニュアルにも「集合演算の結果の列名は、最初のクエリの列名から取られる」とあります。列名を付けたいときは、最初の SELECT に AS を書けば十分です。
また、この例では顧客名と商品名という意味の違う列が、エラーにならずに 1 つの列に混ざっています。UNION は列の名前ではなく、左から何番目の列かでつなぐからです。この落とし穴は「よくある間違い」でも取り上げます。
文字列の列(customer)と数値の列(price)を UNION でつないでも、SQLite ではエラーになりません。
SELECT customer FROM last_year_orders UNION SELECT price FROM this_year_orders;結果は NULL、2980・6480・12800・98000、佐藤・鈴木・高橋 の 8 行で、1 つの列に文字列と数値が混ざりました。SQLite は値ごとに型を持つ仕組みで、公式ドキュメントでは並べ替えのときは「NULL が先、次に数値、その次に文字列」の順になると説明されています。
さらに、数値の 1 と文字列の ‘1’ は、見た目が同じでも別の値として扱われます。
SELECT 1 AS v, typeof(1) AS t UNION SELECT '1', typeof('1');v | t
1 | integer
1 | text
(2 行)typeof は値の型を返す関数です。integer(整数)の 1 と text(文字列)の ‘1’ は重複とみなされず、2 行とも残りました。SQLite の公式ドキュメントには「UNION・INTERSECT・EXCEPT の比較では、値は型を変換せずそのまま比較する」とあります。CSV から取り込んだ列は文字列になっていることがあるので、「同じ番号なのに重複が消えない」ときは typeof で型を確かめましょう。
PostgreSQL の公式ドキュメントでは、UNION する 2 つのクエリは「列の数が同じで、対応する列のデータ型に互換性がある」ことが必要とされ、MySQL の公式マニュアルでも対応する列は同じデータ型にすべきとされています。上下の列の型はそろえて書くのが安全です。
1 つ目の SELECT のあとに ORDER BY を書くと、エラーになります。
SELECT customer FROM last_year_orders ORDER BY customer UNION SELECT customer FROM this_year_orders;エラー: ORDER BY clause should come after UNION not before「ORDER BY 句は UNION の前ではなく後ろに書くべき」という意味です。LIMIT を途中に書いた場合も、LIMIT clause should come after UNION not before というエラーになりました。SQLite の公式ドキュメントには「ORDER BY と LIMIT は compound SELECT 全体の最後にだけ書ける」とあります。
最後の SELECT のあとに書いた ORDER BY は、最後の SELECT だけでなく、つないだ結果全体を並べ替えます。たとえば SELECT customer FROM last_year_orders UNION SELECT customer FROM this_year_orders ORDER BY customer DESC; は、高橋・鈴木・田中・佐藤・伊藤・NULL の順の 6 行を返しました。日本語の名前は読み(五十音)順ではなく、文字コードの順に並びます。
ふつうの SELECT では、結果に出していない列で並べ替えることもできます。しかし UNION の ORDER BY では、それができません。
SELECT customer, product FROM last_year_orders UNION SELECT customer, product FROM this_year_orders ORDER BY price;エラー: 1st ORDER BY term does not match any column in the result set「ORDER BY の 1 つ目の項目が、結果のどの列にも一致しない」という意味です。SQLite の公式ドキュメントでも、compound SELECT の ORDER BY の項目は結果の列のどれかを指すものとして扱われ、一致する列がなければエラーになると説明されています。price で並べたいなら、price を SELECT の列に加えます。
最後に書いた LIMIT は、つないだ結果全体の件数を制限します。SELECT customer, product, price FROM last_year_orders UNION ALL SELECT customer, product, price FROM this_year_orders ORDER BY price DESC LIMIT 3; は、2 年分の注文から金額の高い順に「鈴木 | ノートPC A | 98000」(去年と今年の 2 行)と「佐藤 | 外付けSSD 1TB | 12800」の 3 行を返しました。UNION にすると鈴木さんの 2 行が 1 行にまとまり、3 件目は「伊藤 | キーボード | 6480」になりました。
「去年の上位 2 件と、今年の上位 2 件」のように、それぞれの SELECT に ORDER BY と LIMIT をかけたいときは、FROM の中にサブクエリ(SELECT の中に書く SELECT)として入れます。
SELECT * FROM (SELECT customer, product, price FROM last_year_orders ORDER BY price DESC LIMIT 2) UNION ALL SELECT * FROM (SELECT customer, product, price FROM this_year_orders ORDER BY price DESC LIMIT 2);結果は、去年の上位 2 件(鈴木 98000・高橋 6480)の下に今年の上位 2 件(鈴木 98000・佐藤 12800)が続く 4 行になりました。1 行で書くと読みにくいので、SQL 整形ツールに貼り付けて整形すると、どこからどこまでが 1 つの SELECT なのかが見やすくなります。サブクエリの書き方は「SQLのサブクエリとWITH句(CTE)」で解説しています。
UNION ALL でつなぐと、どの行が去年の注文で、どの行が今年の注文なのかが分からなくなります。そこで、SELECT の列に '去年' AS 区分 のような固定の文字を足します。
SELECT '去年' AS 区分, id, customer, product, price FROM last_year_orders UNION ALL SELECT '今年', id, customer, product, price FROM this_year_orders ORDER BY 区分, id;区分 | id | customer | product | price
今年 | 1 | 佐藤 | 外付けSSD 1TB | 12800
今年 | 2 | 田中 | マウス | 2980
今年 | 3 | 鈴木 | ノートPC A | 98000
今年 | 4 | NULL | マウス | 2980
今年 | 5 | 伊藤 | キーボード | 6480
去年 | 1 | 佐藤 | マウス | 2980
去年 | 2 | 鈴木 | ノートPC A | 98000
去年 | 3 | 高橋 | キーボード | 6480
去年 | 4 | NULL | USBメモリ 32GB | 1280
去年 | 5 | 佐藤 | マウス | 2980
(10 行)列名は最初の SELECT のものになるので、2 つ目の SELECT の ‘今年’ には AS を付けていません。ORDER BY 区分 で「今年」が先に来たのは、文字コードの順で「今」が「去」より前にあるためです。去年を先にしたいときは、区分に 1・2 のような数値の列を別に足して、それで並べ替えます。
UNION ALL の結果を FROM のサブクエリに入れると、GROUP BY でまとめて集計できます。年ごとの件数と売上を出してみます。
SELECT 区分, COUNT(*) AS 件数, SUM(price) AS 売上 FROM (SELECT '去年' AS 区分, price FROM last_year_orders UNION ALL SELECT '今年', price FROM this_year_orders) GROUP BY 区分;区分 | 件数 | 売上
今年 | 5 | 123240
去年 | 5 | 111720
(2 行)ここで UNION ALL ではなく UNION を使うと、同じ年・同じ金額の注文(去年の佐藤さんのマウス 2980 円 2 件など)が 1 行にまとめられ、件数も売上も少なく計算されてしまいます。集計の前につなぐときは、必ず UNION ALL を使います。GROUP BY の使い方は「SQLのGROUP BYと集計関数」で解説しています。
INTERSECT(インターセクト)は両方の結果にある行だけを、EXCEPT(エクセプト)は 1 つ目の結果にあって 2 つ目の結果にない行だけを返します。書き方は UNION と同じです。
SELECT customer FROM last_year_orders INTERSECT SELECT customer FROM this_year_orders;customer
NULL
佐藤
鈴木
(3 行)去年も今年も注文した顧客(リピーター)が分かりました。NULL も「両方にある」とみなされています。
SELECT customer FROM last_year_orders EXCEPT SELECT customer FROM this_year_orders;customer
高橋
(1 行)去年は注文したのに今年は注文していない顧客は、高橋さんだけです。EXCEPT は左右を入れ替えると結果が変わり、SELECT customer FROM this_year_orders EXCEPT SELECT customer FROM last_year_orders; では、今年の新しい顧客の 伊藤・田中 の 2 行が返りました。
UNION は重複を取り除くために、すべての行をいったん一時的な置き場所に入れて、同じ行がないかを調べます。UNION ALL はその作業をせず、行を順に返すだけです。この違いは、SQL の実行計画(データベースがどう処理するつもりかの説明)を表示する EXPLAIN QUERY PLAN で確かめられます。
EXPLAIN QUERY PLAN SELECT customer FROM last_year_orders UNION SELECT customer FROM this_year_orders;id | parent | notused | detail
1 | 0 | 0 | COMPOUND QUERY
2 | 1 | 0 | LEFT-MOST SUBQUERY
5 | 2 | 0 | SCAN last_year_orders
11 | 1 | 0 | UNION USING TEMP B-TREE
13 | 11 | 0 | SCAN this_year_orders
(5 行)UNION の計画には UNION USING TEMP B-TREE(一時的な B-tree を使って UNION する)という行があります。UNION を UNION ALL に変えて実行すると、この行が「UNION ALL」だけになり、TEMP B-TREE は出てきませんでした。B-tree は値を並べて素早く探すためのデータの形で、UNION はこれを使って重複を調べています。INTERSECT の計画にも INTERSECT USING TEMP B-TREE と表示されました。実行計画の見方は「SQLのインデックスとは?」でも解説しています。
どのくらい差が出るか、id が重ならない 50 万行ずつのテーブル 2 つを Python の sqlite3 で用意し、SELECT COUNT(*), SUM(price) FROM (SELECT ... UNION ALL SELECT ...) の形で、つないだ結果の行数と金額の合計を計算する時間を 5 回ずつ測りました(結果を Python に受け取る時間が混ざらないように、データベースの中で集計しています)。中央値は UNION ALL が 0.035 秒、UNION が 0.210 秒でした。
重複がないので、どちらも結果は 100 万行で同じですが、この PCでは UNION のほうが約 6 倍の時間がかかりました(時間は PC やデータによって変わります)。重複が出ないと分かっているとき、または重複を残したいときは UNION ALL を使い、重複を取り除く必要があるときだけ UNION を使いましょう。PostgreSQL の公式ドキュメントにも「UNION ALL は通常 UNION よりかなり速いので、使えるときは ALL を使うこと」と書かれています。
UNION と UNION ALL はどのデータベースでも使えますが、細かい点が違います。次の表は各公式ドキュメント(MySQL 8.4 リファレンスマニュアル・PostgreSQL 18 ドキュメント)で確認した内容で、MySQL と PostgreSQL での実行はしていません。
| 項目 | SQLite | MySQL | PostgreSQL |
|---|---|---|---|
| INTERSECT・EXCEPT | 使える | 8.0.31 から使える | 使える |
| INTERSECT ALL・EXCEPT ALL | 使えない(構文エラー) | 使える | 使える |
| UNION DISTINCT(UNION と同じ意味) | 使えない(構文エラー) | 使える | 使える |
| SELECT を丸かっこで囲む | 使えない(構文エラー) | 使える(ORDER BY・LIMIT を個別にかけられる) | 使える(同上) |
| UNION と INTERSECT を混ぜたとき | 左から順に処理 | INTERSECT が先 | INTERSECT が先 |
SQLite の「構文エラー」は、この記事の環境で実行して確かめました(例:near "ALL": syntax error)。MySQL の INTERSECT・EXCEPT は、MySQL 8.0.31(2022 年 10 月)のリリースノートで対応が告知されています。また、SQLite は 3 つ以上の SELECT を常に左から順に処理します(公式ドキュメントでは「A op B op C は ((A op B) op C)」)。「今年 UNION 去年 INTERSECT ‘高橋’」を SQLite で実行すると高橋の 1 行でしたが、INTERSECT を先に処理する意味(サブクエリで書いたもの)では 6 行になりました。UNION と INTERSECT を混ぜるときは、サブクエリやかっこで順番をはっきりさせましょう。
2 つ目の SELECT で、うっかり列の順番を逆にしたとします。
SELECT customer, product FROM last_year_orders UNION SELECT product, customer FROM this_year_orders;customer | product
NULL | USBメモリ 32GB
キーボード | 伊藤
ノートPC A | 鈴木
マウス | NULL
マウス | 田中
佐藤 | マウス
外付けSSD 1TB | 佐藤
鈴木 | ノートPC A
高橋 | キーボード
(9 行)customer の列に商品名が入る、でたらめな結果になりました。列の数が同じで、SQLite では型も問われないので、エラーにはなりません。しかも本来は 1 行にまとまるはずの「鈴木 | ノートPC A」が別の行として残ったため、行数も 8 行ではなく 9 行になっています。UNION は列名ではなく列の位置でつなぐので、SELECT * を使わず、上下の SELECT に同じ順番で列名を書きましょう。
「どちらのテーブルの行か」を示す列を UNION と一緒に使うと、重複の判定にその列も含まれます。
SELECT '去年' AS 区分, customer, product FROM last_year_orders UNION SELECT '今年', customer, product FROM this_year_orders ORDER BY 区分, customer;区分なしでは 8 行だったのに、9 行になりました。去年の「佐藤 | マウス」の 2 回は同じ区分なので 1 行にまとまりましたが、「鈴木 | ノートPC A」は区分が「去年」と「今年」で違うため、別の行として残ったのです。テーブルをまたいだ重複を消したいときは、区分の列を付けないようにします。
「結果に同じ行が 2 回出てきたら困るか」で決めます。困る(顧客の一覧など、種類を知りたい)なら UNION、困らない・むしろ残したい(注文の明細、集計の前など)なら UNION ALL です。重複が出ないと分かっている場合も、速い UNION ALL を選びます。UNION にすると、本当は必要な行(同じ金額の別の注文など)まで消えてしまうことがある点にも注意してください。