Pythonのデバッガーpdbの使い方|breakpoint()で止めて変数を調べる
hr
ENG LIFE BLOG
CSV の 1 行をカンマで分けたい、入力の前後の空白を消したい、日付の「/」を「-」に置き換えたい。Python で文字列を加工するときは、split()・join()・strip()・replace() などの文字列メソッドを使います。どれも短く書けますが、split() と split(" ") で結果が違う、rstrip(".txt") で文字が削れすぎる、全角数字が「数字」と判定されるなど、つまずきやすい点もあります。
この記事では、よく使う文字列メソッドの使い方と注意点を、実行結果つきで説明します。載せている出力は、Windows 11・Python 3.12.6 で実際に実行して確かめたものです。各メソッドの説明は Python 公式ドキュメント(組み込み型の「文字列メソッド」の節)で確認しています。
Python の文字列は変更できない(イミュータブルな)値です。公式ドキュメントにも「文字列は Unicode コードポイントの変更不能なシーケンス」と書かれています。そのため文字列メソッドは元の文字列を書き換えず、加工した新しい文字列を返します。戻り値を変数に入れないと、何も変わりません。
s = "  hello  "
s.strip()
print(repr(s))
s = s.strip()
print(repr(s))
t = "Python"
t[0] = "J"
' hello '
'hello'
Traceback (most recent call last):
...
TypeError: 'str' object does not support item assignments.strip() は空白を消した文字列を作りますが、どこにも代入していないので捨てられます。s は元のままですs = s.strip() と代入し直すと、s が新しい文字列を指すようになりますt[0] = "J" のように 1 文字だけ書き換えることもできず、TypeError になります。"J" + t[1:] や replace() で新しい文字列を作りますrepr() は値を引用符つきで表示する関数で、前後の空白が残っているかを目で確かめるのに便利です。この記事でもたびたび使います。
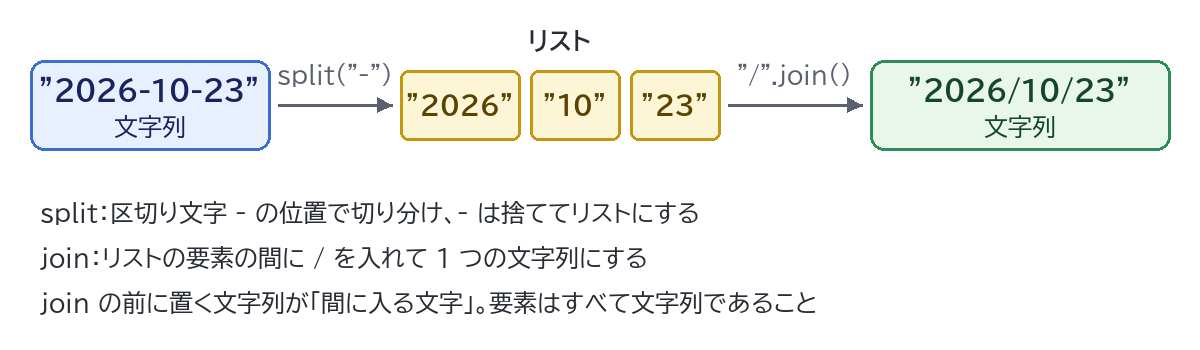
split(区切り文字) は、区切り文字の位置で文字列を切り分け、リストにして返します。区切り文字そのものは結果に含まれません。
print("2026-10-23".split("-"))
print("a,b,,c".split(","))
print("a  b   c".split())
print("a  b   c".split(" "))
print("  a b  ".split())
print("  a b  ".split(" "))
['2026', '10', '23']
['a', 'b', '', 'c']
['a', 'b', 'c']
['a', '', 'b', '', '', 'c']
['a', 'b']
['', '', 'a', 'b', '', '']ポイントは、引数なしの split() と split(" ") はまったく別の動きをすることです。
| 書き方 | 区切り | 連続した区切り | 前後の空白 |
|---|---|---|---|
split() | 空白文字(スペース・タブ・改行・全角スペースなど) | まとめて 1 つの区切りとみなす | 無視される |
split(" ") | 半角スペース 1 文字だけ | 間に空文字列 '' ができる | 先頭・末尾に '' ができる |
split(",") | カンマ 1 文字 | 間に '' ができる(空の項目として残る) | そのまま残る |
人が入力した「単語の並び」を分けるなら、空白の数がばらついても困らない split() が向いています。一方、CSV のように「空の項目」にも意味があるデータは、区切り文字を指定して空文字列を残す必要があります(引用符で囲まれた値の中にカンマがある CSV は、split(",") では正しく分けられないので csv モジュールを使います)。
引数なしの split() は全角スペース(U+3000)も空白として扱います。
print("山田 太郎".split())
print("山田 太郎".split(" "))
['山田', '太郎']
['山田 太郎']2 つ目の引数 maxsplit を指定すると、分ける回数の上限を決められます。結果の要素数は最大で maxsplit + 1 個です。rsplit() は右側から数えて分けます。
print("key=value=extra".split("=", 1))
print("path/to/file.txt".rsplit("/", 1))
print("a.b.c.tar.gz".rsplit(".", 1))
line = "2026-10-23 12:34:56 ERROR db: connection timeout"
date, time, level, rest = line.split(maxsplit=3)
print(level)
print(rest)
['key', 'value=extra']
['path/to', 'file.txt']
['a.b.c.tar', 'gz']
ERROR
db: connection timeout設定ファイルの「キー=値」で値の中にも = がある場合や、ログの「日付・時刻・レベル・残りのメッセージ」のように最後の部分は空白を含んだまま取り出したい場合に便利です。
複数行の文字列を行ごとに分けるとき、split("\n") を使うと、Windows の改行(CRLF=\r\n)の \r が各行の末尾に残ります。末尾の改行のあとに空文字列もできます。splitlines() は \r\n・\n・\r などをどれも改行として扱います。
text = "1行目\r\n2行目\r\n3行目\r\n"
print(text.split("\n"))
print(text.splitlines())
print(text.splitlines(keepends=True))
['1行目\r', '2行目\r', '3行目\r', '']
['1行目', '2行目', '3行目']
['1行目\r\n', '2行目\r\n', '3行目\r\n']残った \r は画面では見えないため、「if line == "3行目" が一致しない」といった分かりにくい不具合になります。keepends=True を付けると改行を残したまま分けられます。改行コードの違いは「改行コードCRLFとLFの違いと確認・変換方法」で詳しく説明しています。
join() は split() の逆で、リストなどの要素を 1 つの文字列につなぎます。書き方は "間に入れる文字".join(リスト) で、区切り文字のほうにメソッドを付けるのが他の言語と違うところです(JavaScript なら 配列.join(","))。
words = ["apple", "banana", "cherry"]
print(", ".join(words))
print("".join(["P", "y"]))
print("/".join("2026-10-23".split("-")))
parts = "tanaka,dev,82".split(",")
parts[2] = "90"
print(",".join(parts))
apple, banana, cherry
Py
2026/10/23
tanaka,dev,90「split() で分けてリストにし、一部を変えて join() でつなぎ直す」は、文字列を加工するときの定番の流れです。文字列そのものは変更できないので、いったんリスト(変更できる)にして作業します。
join() でつなげるのは文字列だけです。リストに数値が混ざっているとエラーになります。
nums = [1, 2, 3]
print(",".join(nums))
TypeError: sequence item 0: expected str instance, int found「0 番目の要素は str(文字列)であるべきなのに int(整数)だった」という意味です。str() で文字列に変換してからつなぎます。次の 2 行はどちらも 1,2,3 を表示します。
print(",".join(str(n) for n in nums))
print(",".join(map(str, nums)))strip() は文字列の前後から空白文字を取り除きます。lstrip() は左(先頭)だけ、rstrip() は右(末尾)だけです。文字列の途中の空白は消えません。
print(repr("  hello\t\n".strip()))
print(repr("  hello  ".lstrip()))
print(repr("  hello  ".rstrip()))
print(repr(" 全角スペース ".strip()))
print(repr("***重要***".strip("*")))
'hello'
'hello '
' hello'
'全角スペース'
'重要'引数なしの strip() が消す「空白」は isspace() が True になる文字で、タブ・改行に加えて全角スペースも消えます。ファイルから読んだ行の末尾の改行を消すのにもよく使います(line.rstrip("\n") なら改行だけを消し、行末のスペースは残せます)。
strip() 系に渡す引数は「この文字列を取り除く」ではなく、「この中のどれかの文字が続く限り取り除く」という文字の集合です。公式ドキュメントにも「chars 引数は接頭辞や接尾辞ではなく、その値のあらゆる組み合わせが取り除かれる」とあります。拡張子を消すつもりで使うと、次のようになります。
print(repr("abc.txt".rstrip(".txt")))
print(repr("report.txt".rstrip(".txt")))
print(repr("list.txt".rstrip(".txt")))
print(repr("https://shop.example.com".lstrip("https://")))
'abc'
'repor'
'lis'
'op.example.com'"abc.txt" はたまたま正しく見えますが、"report.txt" は本体の最後の t まで消えて 'repor' になります。".txt" は「.・t・x のどれか」という意味なので、右端から t・x・t・.・t と消していき、集合にない r で止まるからです。URL の例も、h・t・p・s・:・/ の集合として扱われ、shop の sh まで消えています。
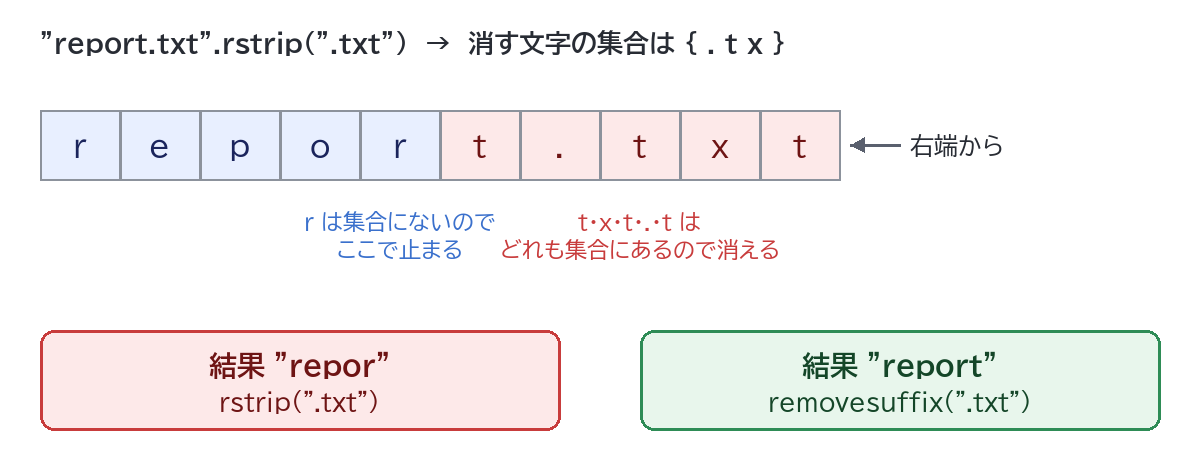
先頭や末尾の決まった文字列を 1 回だけ取り除きたいときは、Python 3.9 で追加された removeprefix()・removesuffix() を使います。その文字列で始まって(終わって)いなければ、元の文字列がそのまま返ります。
print(repr("report.txt".removesuffix(".txt")))
print(repr("abc.csv".removesuffix(".txt")))
print(repr("https://shop.example.com".removeprefix("https://")))
print(repr("ID-0042".removeprefix("ID-")))
'report'
'abc.csv'
'shop.example.com'
'0042'ファイル名から拡張子を取り除く処理なら、pathlib の Path("report.txt").stem も使えます(「pathlib」の記事を参照)。
replace(古い文字列, 新しい文字列) は、見つかったものをすべて置き換えます。3 つ目の引数 count を指定すると、先頭から数えてその回数だけ置き換えます。見つからなければ元の文字列がそのまま返り、エラーにはなりません。
s = "2026/10/23"
print(s.replace("/", "-"))
print(s.replace("/", "-", 1))
print("a b  c".replace(" ", ""))
print("赤と青と黄".replace("と", "、").replace("赤", "red"))
print("Hello".replace("x", "y"))
2026-10-23
2026-10/23
abc
red、青、黄
Helloreplace() は新しい文字列を返すので、5 行目のように続けて呼べます(メソッドチェーン)。ただし置き換えが多いと読みにくくなります。「数字の並び」「空白 1 個以上」のようなパターンで置き換えたいときは、正規表現の re.sub() を使います(「Pythonの正規表現入門」を参照)。
なお、count=1 のようにキーワードで指定できるのは Python 3.13 からです。3.12 で "aaa".replace("a", "b", count=1) と書くと TypeError: str.replace() takes no keyword arguments になるので、3.12 以前では位置で replace("a", "b", 1) と書きます。
startswith() は「〜で始まるか」、endswith() は「〜で終わるか」を True / False で返します。候補をタプル(丸かっこ)で渡すと、どれか 1 つに当てはまれば True です。
f = "photo.JPG"
print(f.endswith((".jpg", ".png")))
print(f.lower().endswith((".jpg", ".png")))
print("https://a.com".startswith(("http://", "https://")))
print(f.endswith([".jpg", ".png"]))
False
True
True
TypeError: endswith first arg must be str or a tuple of str, not list大文字・小文字は区別されるので、拡張子の判定は 3 行目のように lower() でそろえてから行います。候補をリスト(角かっこ)で渡すと TypeError になるので、tuple(リスト) で変換します。
どちらも見つかった位置(先頭を 0 とする番号)を返しますが、見つからなかったときの動きが違います。
s = "user@example.com"
print(s.find("@"), s.find("#"))
print(s.find("e"), s.rfind("e"))
print("@" in s)
print(s[s.find("#"):])
print(s.index("#"))
4 -1
2 11
True
m
ValueError: substring not found| メソッド | 見つかったとき | 見つからないとき |
|---|---|---|
find() / rfind() | 最初(rfind は最後)の位置 | -1 を返す |
index() / rindex() | 同上 | ValueError になる |
in 演算子 | True | False |
注意したいのは 5 行目です。find() の -1 をそのまま位置として使うと、Python では -1 が「末尾の 1 文字」を指すため、エラーにならずに 'm' という間違った結果になります。find() を使うなら -1 かどうかを必ず確かめるか、「必ずあるはず」の場面では index() を使って、ないときにエラーで気づけるようにします。含まれているかどうかだけを知りたいなら、公式ドキュメントのとおり in を使うのが簡単です。
print("banana".count("a"))
print("banana".count("ana"))
print("aaaa".count("aa"))
3
1
2count() は重ならない出現だけを数えます。"banana" の中に "ana" は位置 1 と 3 の 2 か所にありますが、重なっているので 1 と数えられます。
print("Hello World".upper(), "Hello World".lower())
print("hello world".capitalize(), "|", "hello world".title())
print("ABC".lower())
print("straße".lower(), "straße".casefold())
print("STRASSE".lower() == "straße".lower())
print("STRASSE".casefold() == "straße".casefold())
HELLO WORLD hello world
Hello world | Hello World
abc
straße strasse
False
True全角の英字も大文字・小文字の変換対象です(全角のまま小文字になります)。casefold() は「大文字・小文字を区別せずに比べる」ための、lower() より強い変換です。公式ドキュメントの例のとおり、ドイツ語の ß は lower() では変わりませんが、casefold() では ss になるため、"STRASSE" と一致します。英語だけを扱うなら lower() で足りますが、利用者の入力どうしを比べるなら casefold() が確実です。
print("42".zfill(5), "-42".zfill(5), "12345".zfill(3))
print("[" + "abc".center(9, "*") + "]")
print("[" + "abc".ljust(6) + "]")
print("[" + "abc".rjust(6, ".") + "]")
00042 -0042 12345
[***abc***]
[abc ]
[...abc]zfill(幅) は左を 0 で埋めます。- や + の符号は先頭に残し、その後ろに 0 を入れますcenter・ljust・rjust は文字数で幅を数えるので、全角文字が混ざると画面上の位置はそろいません同じことは f 文字列の書式指定(f"{42:05d}"、f"{'abc':*^9}")でも書けます。数値を扱うならこちらが便利です。詳しくは「Pythonのf文字列(f-string)の使い方」を参照してください。
入力が数字かどうかを調べるメソッドは 3 つあり、判定の広さが違います。全角数字・丸数字・漢数字などで確かめた結果です。
for s in ["123", "123", "²", "①", "一二三", "½", "-5", "3.14", ""]:
print(repr(s), s.isdecimal(), s.isdigit(), s.isnumeric())| 文字列 | isdecimal | isdigit | isnumeric |
|---|---|---|---|
"123" | True | True | True |
"123"(全角) | True | True | True |
"²"(上付き) | False | True | True |
"①"(丸数字) | False | True | True |
"一二三"(漢数字) | False | False | True |
"½" | False | False | True |
"-5"・"3.14"・"" | False | False | False |
ここで分かる大事な点は 2 つです。
int("123") は 123 になるので計算には使えますが、「半角数字だけ」を求める入力チェックには使えません。半角に限るなら s.isascii() and s.isdecimal() のように組み合わせますint("①")・int("²")・int("一二三") はどれも ValueError でした。int() に渡す前のチェックなら、3 つの中で一番狭い isdecimal() を使いますマイナスや小数点を含む値はどれも False になります。数値として読めるかを確かめたいなら、try で int()・float() を試して ValueError を受け止める方法が確実です(「Pythonの例外処理」を参照)。全角と半角をまとめてそろえたいときは、Unicode 正規化(NFKC)を使う方法もあります(「Unicode正規化とは?」を参照)。
| 症状 | 原因 | 対処 |
|---|---|---|
s.strip() したのに空白が残る | 戻り値を代入していない | s = s.strip() |
分けた結果に '' が混ざる | split(" ") で連続した空白を分けた | 単語なら split()(引数なし) |
| 行の比較が一致しない | split("\n") で \r が残った | splitlines() |
| join で TypeError | リストに数値がある | map(str, リスト) |
| 拡張子を消したら名前も削れた | rstrip の引数は文字の集合 | removesuffix() |
| おかしな位置の文字が取れる | find() の -1 をそのまま使った | -1 を確かめる・index()・in |
| 全角数字が数字と判定される | isdecimal なども全角を数字とみなす | isascii() と組み合わせる |
入力に全角スペースや見えない文字が紛れていないかを確かめたいときは、文字数・バイト数カウントに貼ると、文字数とバイト数から余分な文字に気づけます。
" ".join(s.split()) と書くと、前後の空白を消し、途中の連続した空白(全角スペース・タブを含む)を半角スペース 1 個にそろえられます。" Python は 楽しい " は 'Python は 楽しい' になりました。
split() ではなく list("abc") と書きます(結果は ['a', 'b', 'c'])。split("") のように空文字列を区切りにすると ValueError になります。リストの扱い方は「Pythonのリスト・辞書・内包表記の基本」を参照してください。