Pythonのファイル読み書き|open・with・encoding指定と文字化けの直し方
hr
ENG LIFE BLOG
Python で 100 万行のログファイルを処理しようとして、メモリが足りなくなったり、なかなか結果が出なかったりしたことはないでしょうか。そんなときに役立つのがジェネレーターです。yield(イールド)を使って関数を書くと、値を全部まとめて作るのではなく、必要になったときに 1 つずつ作って渡せるようになります。
この記事では、土台になるイテラブルとイテレーター(iter()・next()・StopIteration)から始めて、yield で関数が「一時停止・再開」する様子を print で確かめます。そのあと、ジェネレーター式とリスト内包表記のメモリの違いを実測し、大きなファイルを 1 行ずつ処理する例、yield from、一度しか使えないことによる間違いまで説明します。載せている出力は、Windows 11・Python 3.12.6 で実際に実行したものです。
コードは sample.py などの名前で保存し、PowerShell でそのフォルダーに移動してから次のコマンドで実行できます。
py sample.pyジェネレーターは「イテレーター」の一種なので、先にこの 2 つの言葉を整理します。Python 公式ドキュメントの用語集では、次のように説明されています(要約)。
| 用語 | 意味 | 例 |
|---|---|---|
| イテラブル(iterable) | 中の値を 1 つずつ返せるもの。for 文で回せる。iter() に渡すとイテレーターが返る | list・str・tuple・dict・ファイル・range |
| イテレーター(iterator) | データの流れを表すもの。next() を呼ぶたびに次の値を返し、もう値がないときは StopIteration という例外を出す | iter([1, 2]) の戻り値、ジェネレーター、ファイル |
イテラブルを「本」とすると、イテレーターは「どこまで読んだかを覚えているしおり」です。リストからしおりを作って取り出してみます。
nums = [10, 20, 30]
it = iter(nums)
print(it)
print(next(it))
print(next(it))
print(next(it))
print(next(it))
<list_iterator object at 0x000001DD2A532BC0>
10
20
30
Traceback (most recent call last):
File "sample.py", line 7, in <module>
print(next(it))
^^^^^^^^
StopIterationiter(nums) で作ったイテレーターは、next() を呼ぶたびに 10、20、30 と次の値を返し、4 回目で値がなくなって StopIteration が出ました(「0x…」の部分は実行するたびに変わります。トレースバックのファイルのパスは短くしています)。
ふだん書いている for 文は、裏でこれと同じことをしています。公式チュートリアルにも、for 文はまず iter() を呼び、StopIteration が出たらループを終える、と書かれています。for 文を while 文で書き直すと次のようになります。
nums = [10, 20, 30]
it = iter(nums)
while True:
    try:
        n = next(it)
    except StopIteration:
        break
    print(n)
出力は for 文と同じ 10、20、30 の 3 行です。つまり、next() で次の値を返し、終わったら StopIteration を出すものなら、何でも for 文で回せます。ジェネレーターは、このイテレーターを関数の形で簡単に作る仕組みです。
もう 1 つ大事な違いがあります。リスト(イテラブル)は iter() を呼ぶたびに新しいしおりを作りますが、イテレーターに iter() を呼ぶと自分自身が返ります。print(iter(it) is it) は True、print(iter(nums) is iter(nums)) は False でした。このため、イテレーターは最初から読み直せません(「よくある間違い」で実演します)。
関数の中に yield が 1 つでもあると、その関数はジェネレーター関数になります。return は値を返して関数を終わらせますが、yield は値を渡してそこで一時停止し、次に頼まれたら続きから動きます。1 から limit まで数える例です。
def count_up(limit):
    n = 1
    while n <= limit:
        yield n
        n += 1

for n in count_up(3):
    print(n)
print(list(count_up(5)))
print(sum(count_up(100)))
print(type(count_up), type(count_up(3)))
1
2
3
[1, 2, 3, 4, 5]
5050
<class 'function'> <class 'generator'>for 文・list()・sum() など、リストを受け取れる場所にそのまま渡せます。最後の行に注目してください。count_up 自体はふつうの関数(function)ですが、呼び出した結果はジェネレーター(generator)というオブジェクトです。公式の用語集では前者を「ジェネレーター関数」、後者を「ジェネレーターイテレーター」と呼びますが、ふだんはどちらも「ジェネレーター」と呼びます。
ジェネレーターがどの順番で動くのかを、関数の中に print を入れて確かめます。関数の中の print には「[関数]」と付けて区別しています。
def count_up(limit):
    print("  [関数] 開始")
    n = 1
    while n <= limit:
        print(f"  [関数] {n} を yield する")
        yield n
        print(f"  [関数] {n} の続きから再開")
        n += 1
    print("  [関数] 終了")

gen = count_up(2)
print("gen を作った:", gen)
print("1 回目の next:", next(gen))
print("2 回目の next:", next(gen))
print("3 回目の next:")
next(gen)
gen を作った: <generator object count_up at 0x0000014A879FD700>
[関数] 開始
[関数] 1 を yield する
1 回目の next: 1
[関数] 1 の続きから再開
[関数] 2 を yield する
2 回目の next: 2
3 回目の next:
[関数] 2 の続きから再開
[関数] 終了
Traceback (most recent call last):
File "sample.py", line 16, in <module>
next(gen)
StopIteration出力から、次の 4 つのことが分かります。
count_up(2) を呼んだ時点では、「[関数] 開始」が表示されていません。呼んだだけでは関数の中身は 1 行も動かないのですnext() で関数が動き始め、yield 1 のところで止まって 1 を返します(「1 回目の next: 1」より先に関数の print が出るのは、print が next の結果を待ってから表示するためです)next() では、最初からではなく止まった yield の次の行から再開します。変数 n の値(1)も覚えていますStopIteration が出ます。for 文で回したときは、これを合図にループが静かに終わります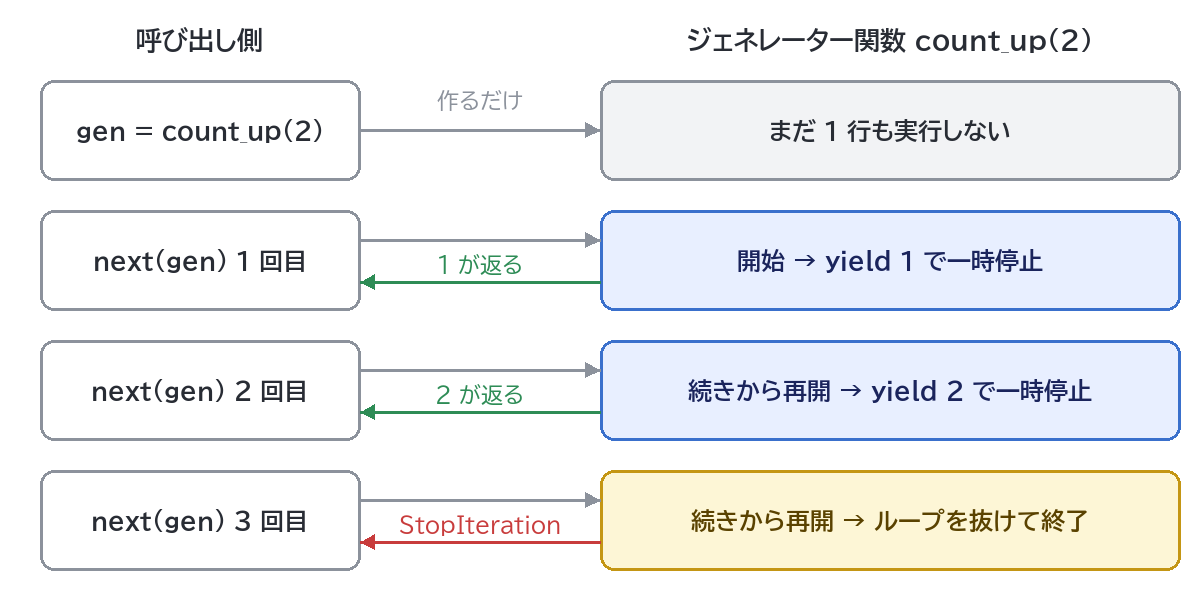
公式ドキュメントの yield 式の説明でも、停止中は「ローカル変数の値や、どこまで実行したか」がすべて保たれる、とされています。ふつうの関数が呼ばれるたびに最初から始まるのとは、ここが大きく違います。
| return を使うふつうの関数 | yield を使うジェネレーター関数 | |
|---|---|---|
| 呼んだとき | すぐに中身を実行する | ジェネレーターを返すだけ(中身はまだ動かない) |
| 値の返し方 | 1 回だけ返して終了 | yield のたびに 1 つ返して一時停止 |
| ローカル変数 | 終了すると消える | 停止中も保たれ、再開時に続きから使える |
簡単なジェネレーターは、リスト内包表記の [ ] を ( ) に変えたジェネレーター式で 1 行で書けます。関数の引数がジェネレーター式 1 つだけのときは、外側のカッコを省略できます(引数が 2 つ以上なら sum((len(w) for w in words), 10) のように囲まないと SyntaxError)。
words = ["apple", "banana", "cherry"]
print(sum(len(w) for w in words))
print(max((len(w), w) for w in words))
print(",".join(w.upper() for w in words))
print(sorted(w[::-1] for w in words))
17
(6, 'cherry')
APPLE,BANANA,CHERRY
['ananab', 'elppa', 'yrrehc']作った値をすぐに別の関数で使い切る場面がジェネレーター式の出番です。公式チュートリアルでも、ジェネレーター式は外側の関数ですぐに使う場面向けで、同じ内容のリスト内包表記よりメモリにやさしい傾向がある、と説明されています。内包表記そのものの書き方は「Pythonのリスト・辞書・内包表記の基本」で解説しています。
本当にメモリが違うのかを測ってみます。sys.getsizeof() はオブジェクトの大きさをバイト数で返す関数です。同じ「x を 2 倍した値」を、リスト内包表記とジェネレーター式で 10 個・1,000 個・100 万個作って比べます。
import sys
for n in [10, 1_000, 1_000_000]:
    lst = [x * 2 for x in range(n)]
    gen = (x * 2 for x in range(n))
    print(f"{n:>9,} 個  リスト: {sys.getsizeof(lst):>9,} バイト  ジェネレーター: {sys.getsizeof(gen)} バイト")
10 個 リスト: 184 バイト ジェネレーター: 200 バイト
1,000 個 リスト: 8,856 バイト ジェネレーター: 200 バイト
1,000,000 個 リスト: 8,448,728 バイト ジェネレーター: 200 バイトこの PC(Windows 11・64 ビット版 Python 3.12.6)では、リストは個数に比例して大きくなり、100 万個で約 8.4MB になりました。ジェネレーターは何個でも 200 バイトのままです。値をまだ作っておらず、「次に何を作るか」だけを持っているからです。逆に 10 個くらいなら、リストのほうが小さいこともあります。数値は Python のバージョンなどで変わります。
ただし、公式ドキュメントにあるとおり、sys.getsizeof() はそのオブジェクト自体の大きさだけを数え、中から参照している値(ここでは 100 万個の整数)は含みません。実際に使ったメモリ全体を見るため、標準ライブラリの tracemalloc(Python が確保したメモリを記録する機能)で、合計を計算する間の最大使用量を測りました。
import tracemalloc

tracemalloc.start()
total = sum([x * 2 for x in range(1_000_000)])
print("リスト内包表記  :", total, f"最大 {tracemalloc.get_traced_memory()[1]:,} バイト")
tracemalloc.stop()

tracemalloc.start()
total = sum(x * 2 for x in range(1_000_000))
print("ジェネレーター式:", total, f"最大 {tracemalloc.get_traced_memory()[1]:,} バイト")
tracemalloc.stop()
リスト内包表記 : 999999000000 最大 40,444,608 バイト
ジェネレーター式: 999999000000 最大 456 バイト結果は同じで、メモリの最大使用量はリストが約 40MB、ジェネレーター式は 456 バイトでした(この PC で 2 回実行して同じ値)。リストは 100 万個の値を全部並べてから合計しますが、ジェネレーター式は 1 つ作っては足し、を繰り返すので、ほとんどメモリを使いません。速さはこの PC では大きな差がなく(どちらも 0.03〜0.05 秒)、使う理由はメモリです。
ジェネレーターがいちばん役に立つのが、大きなファイルの処理です。まず練習用に、100 万行のログファイル app.log(この PC では約 35MB)を作ります。5 行に 1 行が ERROR です。
levels = ["INFO", "INFO", "INFO", "WARN", "ERROR"]
with open("app.log", "w", encoding="utf-8") as f:
    for i in range(1_000_000):
        f.write(f"2026-10-23 {levels[i % 5]} request id={i}\n")
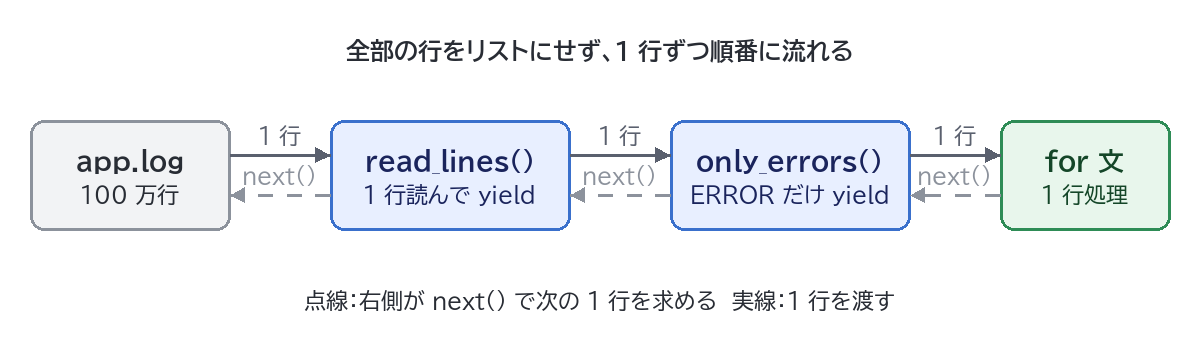
次に、「ファイルを 1 行ずつ読む」ジェネレーターと「ERROR の行だけを通す」ジェネレーターを作り、つなげます。
def read_lines(path):
    with open(path, encoding="utf-8") as f:
        for line in f:
            yield line.rstrip("\n")

def only_errors(lines):
    for line in lines:
        if " ERROR " in line:
            yield line

lines = read_lines("app.log")
errors = only_errors(lines)
for i, line in enumerate(errors):
    print(line)
    if i == 2:
        break
print(sum(1 for _ in only_errors(read_lines("app.log"))), "件")
2026-10-23 ERROR request id=4
2026-10-23 ERROR request id=9
2026-10-23 ERROR request id=14
200000 件前半は ERROR の行を 3 行表示したところで break しています。このとき read_lines が yield したのは先頭の 15 行(id=0〜14)だけで、残りの行には進んでいません。for 文が次の行を求めるたびに、only_errors が read_lines に 1 行を求め、read_lines がファイルから 1 行を読む、という形で、必要な分だけが順番に流れるからです。後半の sum(1 for _ in ...) は、件数を数えるよく使う書き方です。
全部の行を先に読み込む readlines() と、メモリの最大使用量を tracemalloc で比べました(どちらも ERROR の行を数えるだけの処理です)。
| 読み方 | 数えた件数 | メモリの最大使用量(この PC) |
|---|---|---|
f.readlines() で全行をリストにする | 200000 件 | 83,555,575 バイト(約 84MB) |
read_lines() ジェネレーター | 200000 件 | 34,946 バイト(約 35KB) |
ファイルが 35MB なのに、readlines() はその 2 倍以上のメモリを使いました。100 万個の文字列それぞれに管理用の領域が付くためです。ジェネレーターなら、ファイルの大きさにかかわらず使うメモリはほぼ一定です。
なお、ファイルオブジェクト自体もイテレーターなので、1 段だけなら for line in f: と書くだけで 1 行ずつ読めます。ジェネレーターに分けておくと、「読む」「絞り込む」「変換する」を部品にして組み合わせられるのが利点です。open() や encoding の指定は「Pythonのファイル読み書き」で詳しく説明しています。
値を 1 つずつ作るので、while True で終わりのない並びも作れます。必要な分だけを、itertools の islice() や next() で取り出します。
from itertools import islice

def ids():
    n = 1
    while True:
        yield f"ID-{n:04d}"
        n += 1

print(list(islice(ids(), 3)))
['ID-0001', 'ID-0002', 'ID-0003']list(ids()) と書くと終わらなくなり、メモリを使い続けるので注意してください。islice のほか、ジェネレーターと組み合わせて使える道具は「Pythonのitertoolsの使い方」でまとめています。
yield from イテラブル は、「そのイテラブルの値を全部、1 つずつ yield する」という意味です。for x in イテラブル: yield x を 1 行で書けます。入れ子のリストを平らにする例です。
def flatten(items):
    for item in items:
        if isinstance(item, list):
            yield from flatten(item)
        else:
            yield item

print(list(flatten([1, [2, 3], [4, [5, 6]], 7])))

def header_and_body():
    yield "見出し"
    yield from ["本文1", "本文2"]
    yield from range(3)

print(list(header_and_body()))
[1, 2, 3, 4, 5, 6, 7]
['見出し', '本文1', '本文2', 0, 1, 2]flatten は、中身がリストなら自分自身(flatten)に任せ、そうでなければそのまま yield します。何段の入れ子でも平らにできます。yield from の右には、リスト・range・別のジェネレーターなど、イテラブルなら何でも書けます。
もう 1 つの働きとして、任せた先のジェネレーターが return で返した値を、yield from 式の値として受け取れます。ジェネレーターの return の値は、終わったときの StopIteration の value 属性に入る仕組みです(公式ドキュメントの yield 式の説明どおり)。
def sub():
    yield 1
    yield 2
    return "sub の戻り値"

def main():
    result = yield from sub()
    print("受け取った:", result)

for v in main():
    print(v)

g = sub()
print(next(g), next(g))
try:
    next(g)
except StopIteration as e:
    print("StopIteration.value =", e.value)
1
2
受け取った: sub の戻り値
1 2
StopIteration.value = sub の戻り値ふだんは「yield from = 中身を全部 yield する」と覚えておけば十分です。
ジェネレーターには、外から値を送り込む send() と、途中で終わらせる close() というメソッドもあります。使う機会は多くないので、動きだけ見ておきます。
value = yield average のように yield を式として使うと、send(値) で送った値が value に入ります(next() で再開したときは None)。送るたびに平均を返す例です。
def averager():
    total = 0
    count = 0
    average = None
    while True:
        value = yield average
        total += value
        count += 1
        average = total / count

avg = averager()
print(next(avg))
print(avg.send(10))
print(avg.send(20))
print(avg.send(60))
None
10.0
15.0
30.0最初の next(avg) は、関数を最初の yield まで進めるためのものです。これを忘れて、いきなり avg.send(10) とすると、TypeError: can't send non-None value to a just-started generator(始まったばかりのジェネレーターに None 以外は送れない)になりました。公式ドキュメントにも、まだ値を受け取る yield に着いていないので、最初は None を送る必要がある、と書かれています。
close() は、止まっている yield の位置に GeneratorExit という例外を起こして終了させます。finally に書いた後片付けはこのとき実行されます。
def numbers():
    try:
        n = 1
        while True:
            yield n
            n += 1
    finally:
        print("後片付け(finally)を実行")

gen = numbers()
print(next(gen), next(gen))
gen.close()
print("close したあと:", list(gen))
1 2
後片付け(finally)を実行
close したあと: []close したジェネレーターからは、もう値は出てきません。read_lines のように with 文でファイルを開いているジェネレーターも、最後まで読むか close されたときにファイルが閉じられます。finally の詳しい動きは「Pythonの例外処理入門」を参照してください。
def hello():
    print("こんにちは")
    yield 1

hello()
print("hello() を呼んだ")
result = hello()
print(result)
hello() を呼んだ
<generator object hello at 0x00000206D4D7C880>「こんにちは」が一度も表示されません。yield がある関数は、呼んでもジェネレーターを返すだけで中身は動かないからです(図 1 の 1 段目)。中身を動かすには、for 文で回すか、list()・next() に渡します。
squares = (n * n for n in range(4))
print(sum(squares))
print(sum(squares))
print(list(squares))
14
0
[]ジェネレーターは、最後まで取り出すと空になり、最初からやり直せません。1 回目の sum で 0・1・4・9 を使い切ったので、2 回目の合計は 0 になり、エラーも出ません。max(squares) のあとに min(squares) とすると、2 回目は ValueError: min() iterable argument is empty になりました。
in で調べるだけでも、見つかったところまで値を使ってしまいます。print(1 in squares) は True で、そのあとの list(squares) は 0 と 1 がなくなった [4, 9] でした。
何度も使うなら、nums = list(squares) と一度リストにして変数に入れるか、使うたびにジェネレーター関数を呼び直して新しいジェネレーターを作ります(sum(count_up(3)) のように)。
ジェネレーターは「まだ作っていない値」の並びなので、個数も、何番目に何があるかも分かりません。前の例の count_up で試すと、次のエラーになりました。
len(gen)  →  TypeError: object of type 'generator' has no len()
gen[0]    →  TypeError: 'generator' object is not subscriptable
個数や番号での取り出しが必要なら nums = list(count_up(3)) とリストにします。こうすると len(nums) は 3、nums[0] は 1 になり、sum や max も何度でも使えます。値の数が少ないなら、最初からリストを返す関数にしてかまいません。
def get_lines(path):
    with open(path, encoding="utf-8") as f:
        return (line.rstrip("\n") for line in f)

for line in get_lines("app.log"):
    print(line)
    break
Traceback (most recent call last):
File "sample.py", line 5, in <module>
for line in get_lines("app.log"):
^^^^^^^^^^^^^^^^^^^^
File "sample.py", line 3, in <genexpr>
return (line.rstrip("\n") for line in f)
^
ValueError: I/O operation on closed file.get_lines は yield を使っていないふつうの関数なので、ジェネレーター式を return した瞬間に with を抜けてファイルが閉じます。そのあと for 文で 1 行目を求めたときには、もう閉じたファイルを読もうとしてエラーになります。return を yield from に変えると get_lines 自体がジェネレーターになり、読み終わるまで with の中にとどまるので、1 行目が正しく表示されました。
値が多い(ファイルの行、データベースの全件など)、終わりがない、先頭の何個かだけ使うことが多い、という場合はジェネレーターが向いています。値が少なく、何度も使う・個数を知りたい・番号で取り出したい場合はリストのほうが扱いやすく、間違いも起きにくくなります。迷ったらリストで書き、メモリが問題になったらジェネレーターに変える、で十分です。
iter() と next() を呼び、StopIteration で終わる( ) は値をためないので、100 万個でもメモリをほとんど使わない