SQLのUNIONとUNION ALLの違い|重複・ORDER BYを実行結果で解説
hr
ENG LIFE BLOG
SQL の GROUP BY(グループバイ)は、同じ値を持つ行を 1 つのグループにまとめて、グループごとに件数や合計を出す命令です。「カテゴリごとの商品数」「顧客ごとの購入金額」「月ごとの売上」のような集計は、ほとんどがこの GROUP BY と集計関数(COUNT・SUM・AVG など)で書けます。
この記事では、練習用の商品・顧客・注文テーブルで実際に実行した結果を見ながら、GROUP BY と集計関数の使い方、COUNT(*) と COUNT(列) の違い、WHERE と HAVING の使い分け、GROUP BY にない列を SELECT したときの SQLite・MySQL・PostgreSQL の違いを解説します。SELECT 文の基本は「SQL入門:SELECT文の基本」、テーブルのつなぎ方は「SQLのJOINの種類と使い分け」で解説しています。
集計関数は、複数の行の値から 1 つの値を計算する関数です。GROUP BY を付けないとテーブル全体(WHERE で絞り込んだ行全体)が 1 つのグループになり、GROUP BY を付けると、指定した列の値ごとにグループに分けて計算します。
| 集計関数 | 計算する内容 | NULL の扱い |
|---|---|---|
| COUNT(*) | 行の数 | NULL を含む行も数える |
| COUNT(列) | その列が NULL でない行の数 | NULL は数えない |
| SUM(列) | 合計 | NULL を無視する。対象が 0 行なら NULL |
| AVG(列) | 平均 | NULL を無視する(NULL の行は分母にも入らない) |
| MIN(列) / MAX(列) | 最小値 / 最大値 | NULL を無視する |
NULL は「値がない」ことを表す特別な値です。MySQL の公式マニュアルにも「特に記載がない限り、集計関数は NULL を無視する」とあり、例外が COUNT(*) です。
Python に標準で入っている SQLite(エスキューライト)を使います。次のコードを sql_group_by_practice.py という名前で保存してください。商品(products)・顧客(customers)・注文(orders)の 3 つのテーブルをメモリー上に作ります。データは終了すると消えます。
import sqlite3

con = sqlite3.connect(":memory:")
con.executescript("""
CREATE TABLE products (
  id       INTEGER PRIMARY KEY,
  name     TEXT    NOT NULL,
  category TEXT    NOT NULL,
  price    INTEGER
);
INSERT INTO products VALUES
  (1, 'ノートPC A',     'PC',         98000),
  (2, 'ノートPC B',     'PC',        128000),
  (3, 'マウス',         '周辺機器',    2980),
  (4, 'キーボード',     '周辺機器',    6480),
  (5, 'USBメモリ 32GB', '記録メディア', 1280),
  (6, '外付けSSD 1TB',  '記録メディア', 12800),
  (7, 'モニター 24型',  '周辺機器',   21800),
  (8, 'USBケーブル',    '周辺機器',    NULL);

CREATE TABLE customers (
  id   INTEGER PRIMARY KEY,
  name TEXT    NOT NULL
);
INSERT INTO customers VALUES
  (1, '佐藤'),
  (2, '鈴木'),
  (3, '高橋'),
  (4, '田中');

CREATE TABLE orders (
  id          INTEGER PRIMARY KEY,
  customer_id INTEGER NOT NULL,
  product_id  INTEGER NOT NULL,
  qty         INTEGER NOT NULL,
  ordered_on  TEXT    NOT NULL
);
INSERT INTO orders VALUES
  ( 1, 1, 3, 2, '2026-09-03'),
  ( 2, 2, 1, 1, '2026-09-10'),
  ( 3, 1, 4, 1, '2026-09-18'),
  ( 4, 3, 3, 1, '2026-09-25'),
  ( 5, 2, 5, 5, '2026-10-01'),
  ( 6, 1, 6, 1, '2026-10-02'),
  ( 7, 3, 7, 2, '2026-10-05'),
  ( 8, 2, 3, 3, '2026-10-08'),
  ( 9, 1, 2, 1, '2026-10-10'),
  (10, 3, 5, 2, '2026-10-12');
""")

print("SQL を入力して Enter(終了は exit)")
while True:
    sql = input("sql> ").strip()
    if sql.lower() in ("exit", "quit"):
        break
    if not sql:
        continue
    try:
        cur = con.execute(sql)
    except sqlite3.Error as e:
        print("エラー:", e)
        continue
    if cur.description is None:
        print("(結果の表はありません)")
        continue
    print(" | ".join(d[0] for d in cur.description))
    rows = cur.fetchall()
    for row in rows:
        print(" | ".join("NULL" if v is None else str(v) for v in row))
    print(f"({len(rows)} 行)")
保存したフォルダーで次のコマンドを実行すると「sql>」と表示されるので、この記事の SQL を 1 行で入力して Enter を押します(Python 3.12・SQLite 3.45 で確認しました)。
py sql_group_by_practice.py注文テーブルの中身は次のとおりです。customer_id が顧客の番号、product_id が商品の番号、qty が数量です。
SELECT * FROM orders;id | customer_id | product_id | qty | ordered_on
1 | 1 | 3 | 2 | 2026-09-03
2 | 2 | 1 | 1 | 2026-09-10
3 | 1 | 4 | 1 | 2026-09-18
4 | 3 | 3 | 1 | 2026-09-25
5 | 2 | 5 | 5 | 2026-10-01
6 | 1 | 6 | 1 | 2026-10-02
7 | 3 | 7 | 2 | 2026-10-05
8 | 2 | 3 | 3 | 2026-10-08
9 | 1 | 2 | 1 | 2026-10-10
10 | 3 | 5 | 2 | 2026-10-12
(10 行)集計の違いが分かるように、USBケーブル(id 8)の価格を NULL(未定)にし、田中さん(id 4)は注文が 0 件にしています。
まずは GROUP BY を付けずに、商品テーブル全体の件数・合計・平均・最小・最大を出してみます。
SELECT COUNT(*) AS 件数, SUM(price) AS 合計, AVG(price) AS 平均, MIN(price) AS 最安, MAX(price) AS 最高 FROM products;件数 | 合計 | 平均 | 最安 | 最高
8 | 271340 | 38762.857142857145 | 1280 | 128000
(1 行)8 行が 1 行にまとまりました。件数は 8 ですが、平均は「合計 271,340 ÷ 7」です。価格が NULL の USBケーブルは、SUM と AVG の計算から外れています。
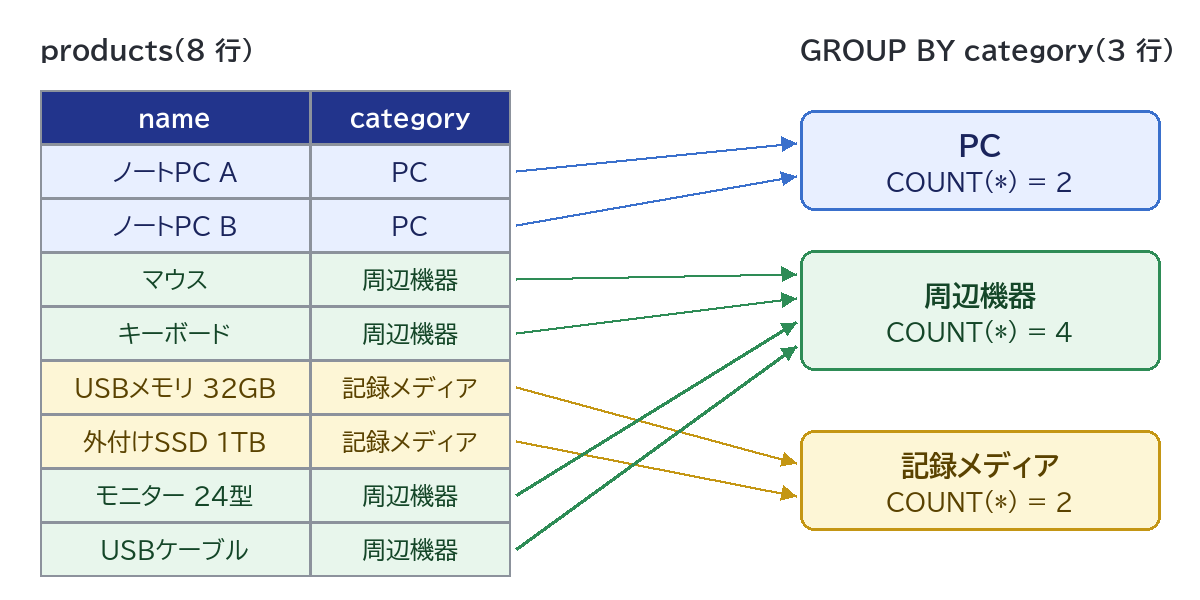
GROUP BY の後ろに列名を書くと、その列の値が同じ行どうしが 1 つのグループになり、集計関数はグループごとに計算されます。カテゴリごとの商品数を数えてみます。
SELECT category, COUNT(*) AS 商品数 FROM products GROUP BY category;category | 商品数
PC | 2
周辺機器 | 4
記録メディア | 2
(3 行)結果の行数は「グループの数」になります。SELECT に書けるのは、GROUP BY に書いた列(ここでは category)と集計関数が基本です(理由は「よくある間違い」で説明します)。また、結果がカテゴリ順に並んでいるのはたまたまです。PostgreSQL の公式ドキュメントには「ORDER BY がなければ、行はシステムが最も速く返せる順で返される」とあるので、並び順が必要なら ORDER BY を付けます。集計関数は 1 つの SELECT にいくつでも書けます。
SELECT category, COUNT(*) AS 商品数, MIN(price) AS 最安, MAX(price) AS 最高, AVG(price) AS 平均 FROM products GROUP BY category ORDER BY category;category | 商品数 | 最安 | 最高 | 平均
PC | 2 | 98000 | 128000 | 113000.0
周辺機器 | 4 | 2980 | 21800 | 10420.0
記録メディア | 2 | 1280 | 12800 | 7040.0
(3 行)SQLite の AVG は、整数の列でも結果が小数(113000.0)になります。公式ドキュメントには「AVG の結果は、NULL でない入力が 1 つ以上あれば、すべての入力が整数でも常に浮動小数点数になる」とあります。MySQL の公式マニュアルでは、整数の列の SUM と AVG は DECIMAL 型(誤差の出ない 10 進数)で返るとされていて、結果の型はデータベースによって違います。
実際の集計では、JOIN でテーブルをつないでから GROUP BY することがよくあります。注文と商品をつないで、カテゴリごとの売上(価格×数量の合計)を出します。
SELECT p.category, SUM(p.price * o.qty) AS 売上 FROM orders AS o INNER JOIN products AS p ON o.product_id = p.id GROUP BY p.category ORDER BY 売上 DESC;category | 売上
PC | 226000
周辺機器 | 67960
記録メディア | 21760
(3 行)顧客ごとの注文数と購入金額を、注文のない顧客も含めて出すときは LEFT JOIN を使います。
SELECT c.name, COUNT(o.id) AS 注文数, SUM(p.price * o.qty) AS 購入金額 FROM customers AS c LEFT JOIN orders AS o ON c.id = o.customer_id LEFT JOIN products AS p ON o.product_id = p.id GROUP BY c.id, c.name ORDER BY 購入金額 DESC;name | 注文数 | 購入金額
佐藤 | 4 | 153240
鈴木 | 3 | 113340
高橋 | 3 | 49140
田中 | 0 | NULL
(4 行)注文のない田中さんの購入金額が 0 ではなく NULL になっています。これは「よくある間違い」で対処法を説明します。GROUP BY に c.id を入れているのは、同じ名前の顧客が 2 人いても別のグループにするためです。
GROUP BY にカンマで複数の列を書くと、その組み合わせごとのグループになります。注文日の先頭 7 文字(2026-09 など)を substr で取り出し、「月 × カテゴリ」の売上を出してみます。
SELECT substr(o.ordered_on, 1, 7) AS 月, p.category, SUM(p.price * o.qty) AS 売上 FROM orders AS o INNER JOIN products AS p ON o.product_id = p.id GROUP BY 月, p.category ORDER BY 月, 売上 DESC;月 | category | 売上
2026-09 | PC | 98000
2026-09 | 周辺機器 | 15420
2026-10 | PC | 128000
2026-10 | 周辺機器 | 52540
2026-10 | 記録メディア | 21760
(5 行)9 月は記録メディアの注文がないので、その組み合わせの行は出てきません。GROUP BY は「データにある組み合わせ」だけを作ります。
COUNT には 3 つの書き方があり、数えるものが違います。
SELECT COUNT(*), COUNT(price), COUNT(category), COUNT(DISTINCT category) FROM products;COUNT(*) | COUNT(price) | COUNT(category) | COUNT(DISTINCT category)
8 | 7 | 8 | 3
(1 行)| 書き方 | 数えるもの | この例の結果 |
|---|---|---|
| COUNT(*) | 行の数(NULL があっても数える) | 8(全商品) |
| COUNT(price) | price が NULL でない行の数 | 7(USBケーブルを除く) |
| COUNT(DISTINCT category) | NULL でない値の種類の数(重複を除く) | 3(PC・周辺機器・記録メディア) |
SQLite の公式ドキュメントでは「COUNT(X) はグループの中で X が NULL でない回数を、COUNT(*) はグループの行の総数を返す」、MySQL の公式マニュアルでも「COUNT(*) は NULL を含むかどうかに関係なく行の数を返す」と説明されています。
COUNT(DISTINCT 列) は「何人が買ったか」のような、重複を除いた数を出すときに使います。カテゴリごとの注文数と購入者数を比べてみます。
SELECT p.category, COUNT(*) AS 注文数, COUNT(DISTINCT o.customer_id) AS 購入者数 FROM orders AS o INNER JOIN products AS p ON o.product_id = p.id GROUP BY p.category ORDER BY 注文数 DESC;category | 注文数 | 購入者数
周辺機器 | 5 | 3
記録メディア | 3 | 3
PC | 2 | 2
(3 行)周辺機器は 5 件注文されていますが、佐藤さんと高橋さんが 2 回ずつ買っているので、購入者は 3 人です。
LEFT JOIN と組み合わせるときも、この違いが効きます。顧客ごとの注文数を COUNT(*) で数えると、注文のない田中さんも LEFT JOIN で残った 1 行が数えられて「1 件」になりました。前の章の例のように COUNT(o.id) と右のテーブルの列を数えれば 0 になります(詳しくは「SQLのJOINの種類と使い分け」で解説しています)。
NULL を含む列では、平均を自分で計算すると AVG と結果が変わります。
SELECT AVG(price), SUM(price) / COUNT(*) FROM products WHERE category = '周辺機器';AVG(price) | SUM(price) / COUNT(*)
10420.0 | 7815
(1 行)周辺機器は 4 商品ですが、価格があるのは 3 商品です。AVG は 31,260 ÷ 3 = 10,420、SUM(price) / COUNT(*) は 31,260 ÷ 4 で、さらに SQLite では整数どうしの割り算なので小数が切り捨てられて 7,815 になりました。「価格未定の商品は平均に入れない」なら AVG、「0 円として平均に入れる」なら AVG(COALESCE(price, 0)) のように、NULL をどう扱うかを決めてから書きましょう(COALESCE は NULL を別の値に置き換える関数です)。
「売上が 30,000 円以上のカテゴリだけ」のように、集計した結果で絞り込むときは HAVING を使います。HAVING は GROUP BY の後ろに書きます。
SELECT p.category, SUM(p.price * o.qty) AS 売上 FROM orders AS o INNER JOIN products AS p ON o.product_id = p.id GROUP BY p.category HAVING SUM(p.price * o.qty) >= 30000 ORDER BY 売上 DESC;category | 売上
PC | 226000
周辺機器 | 67960
(2 行)売上 21,760 円の記録メディアが外れました。
どちらも「絞り込み」ですが、絞り込むタイミングと対象が違います。PostgreSQL の公式ドキュメントでは「WHERE はグループと集計を計算する前に入力の行を選び(どの行を集計に入れるかを決める)、HAVING はグループと集計を計算した後にグループの行を選ぶ」と説明されています。
| WHERE | HAVING | |
|---|---|---|
| 絞り込むタイミング | グループに分ける前 | グループに分けて集計した後 |
| 絞り込む対象 | 1 行ずつ | グループ(集計結果の行) |
| 集計関数 | 書けない(エラー) | 書ける |
| 例 | 10 月以降の注文だけを集計する | 注文が 2 件以上のカテゴリだけを出す |
両方を 1 つの SQL で使うこともできます。「10 月以降の注文だけで、注文が 2 件以上あったカテゴリ」を出してみます。
SELECT p.category, COUNT(*) AS 注文数, SUM(p.price * o.qty) AS 売上 FROM orders AS o INNER JOIN products AS p ON o.product_id = p.id WHERE o.ordered_on >= '2026-10-01' GROUP BY p.category HAVING COUNT(*) >= 2 ORDER BY 売上 DESC;category | 注文数 | 売上
周辺機器 | 2 | 52540
記録メディア | 3 | 21760
(2 行)WHERE で 9 月の注文が除かれてから集計されるので、周辺機器の注文数は 5 件ではなく 2 件です。10 月の PC の注文は 1 件だけなので、HAVING で外れました。
「1 万円以上」という条件を、WHERE と HAVING に書いた場合を比べます。
SELECT category, COUNT(*) AS 商品数 FROM products WHERE price >= 10000 GROUP BY category;category | 商品数
PC | 2
周辺機器 | 1
記録メディア | 1
(3 行)SELECT category, COUNT(*) AS 商品数 FROM products GROUP BY category HAVING MAX(price) >= 10000;category | 商品数
PC | 2
周辺機器 | 4
記録メディア | 2
(3 行)前者は「1 万円以上の商品の数(カテゴリごと)」、後者は「1 万円以上の商品を 1 つでも含むカテゴリの、全商品の数」です。行を数える前に除きたいなら WHERE、集計結果で判断したいなら HAVING と覚えておきましょう。
集計関数を使わない条件(category <> '周辺機器' など)も HAVING に書けますが、MySQL の公式マニュアルでは「WHERE に書くべき条件を HAVING に書かない」よう注意されています。
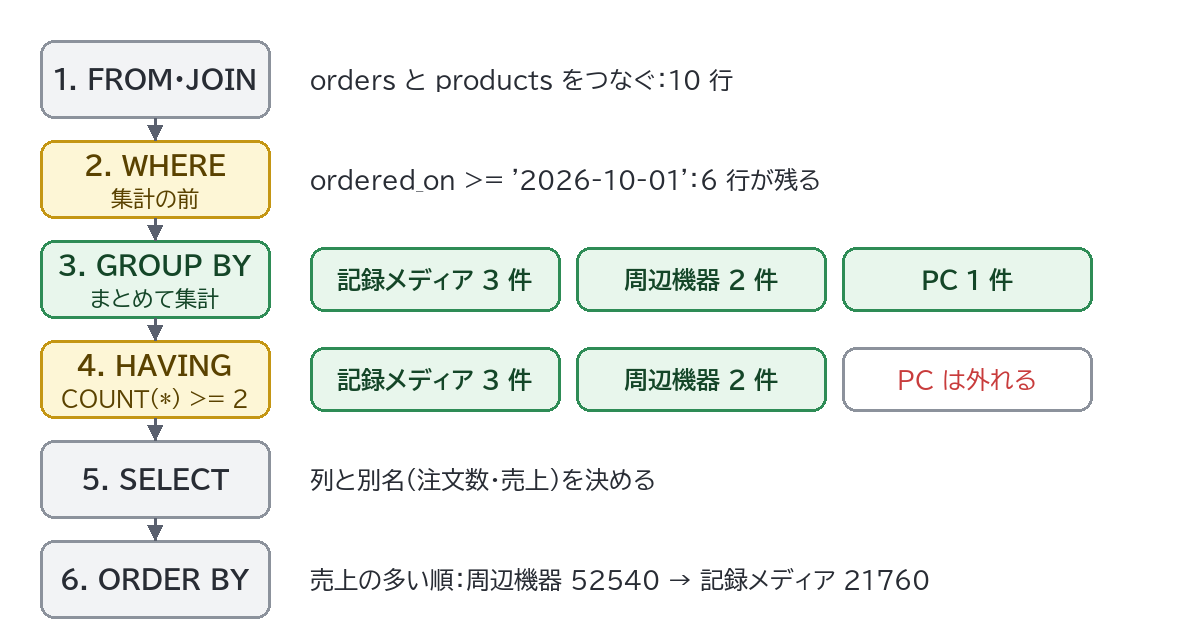
SELECT 文は、書いた順ではなく次の順に処理されると考えると、WHERE と HAVING の違いや、別名を書ける場所が理解しやすくなります(PostgreSQL の公式ドキュメントをもとにしています)。
WHERE は GROUP BY より前に処理されるので、WHERE の時点ではまだ集計結果がありません。これが「WHERE に集計関数を書けない」理由です。また、ORDER BY は最後のほうで処理されるので、ORDER BY 売上 DESC のように集計結果の別名で並べ替えられます。
1 行に書いた SQL が長くなってきたら、SQL 整形ツールに貼り付けると、SELECT・FROM・WHERE・GROUP BY・HAVING ごとに改行して読みやすく整形できます。
カテゴリごとにまとめたのに、SELECT に商品名(name)を書いてしまう間違いです。SQLite ではエラーにならず、次の結果が返りました。
SELECT category, name, COUNT(*) FROM products GROUP BY category;category | name | COUNT(*)
PC | ノートPC A | 2
周辺機器 | マウス | 4
記録メディア | USBメモリ 32GB | 2
(3 行)周辺機器のグループには 4 つの商品があるのに、name には「マウス」だけが出ています。1 つのグループに name の値は 4 つあるので、1 行には決められないはずです。SQLite の公式ドキュメントでは、このような列を「bare column(むき出しの列)」と呼び、「グループを作る入力行のどれか 1 つの値になるが、どの行が使われるかは通常分からない」と説明しています。
同じ SQL でも、データベースによって扱いが違います。
| データベース | GROUP BY にない列を SELECT したとき |
|---|---|
| SQLite | エラーにならない。グループ内のどれかの行の値が入る(SQLite 独自の拡張) |
| MySQL | ONLY_FULL_GROUP_BY(既定で有効)のときはエラー 1055。このモードを無効にすると、グループ内のどれかの値が入る |
| PostgreSQL | エラー。ただし GROUP BY に主キーを書いていれば、そのテーブルの他の列は書ける |
MySQL 8.4 の公式マニュアルには「ONLY_FULL_GROUP_BY が有効なとき(既定で有効)、SELECT・HAVING・ORDER BY が、GROUP BY に書かれておらず、それに関数従属してもいない集計されていない列を参照するクエリを拒否する」とあり、「ERROR 1055 (42000): Expression #2 of SELECT list is not in GROUP BY clause and contains nonaggregated column …」というエラーの例が載っています(この記事では MySQL の実機での確認はしていません)。
「関数従属」とは、ある列の値が決まれば別の列の値も 1 つに決まる関係のことです。たとえば顧客の id(主キー)が決まれば顧客名も 1 つに決まるので、GROUP BY c.id のときに c.name を SELECT しても、MySQL と PostgreSQL はエラーにしません(PostgreSQL の公式ドキュメントでは、GROUP BY に主キーが含まれる場合だけこの関係を認める、とされています)。迷ったら、この記事の例のように GROUP BY c.id, c.name と両方書いておけば、どのデータベースでも通ります。
直し方は、目的によって次のどれかです。
なお SQLite には、集計関数が MIN か MAX の 1 つだけのとき、bare column は最小値・最大値を持つ行から取られる、という特別な動きがあります。SELECT category, name, MAX(price) FROM products GROUP BY category; を実行すると、各カテゴリで最も高い商品(ノートPC B・モニター 24型・外付けSSD 1TB)の名前が返りました。ただし、これは SQLite だけの動きで、公式ドキュメントにも「他の多くのデータベースは bare column を許可しない」と書かれています。他のデータベースに移す可能性がある SQL では使わないほうが安全です。
「商品が 3 つ以上あるカテゴリ」を WHERE で絞り込もうとすると、エラーになります。
SELECT category, COUNT(*) FROM products WHERE COUNT(*) >= 3 GROUP BY category;エラー: misuse of aggregate: COUNT()misuse of aggregate は「集計関数の使い方が誤っている」という意味です。集計結果の条件は HAVING に書きます。
SELECT category, COUNT(*) AS 商品数 FROM products GROUP BY category HAVING COUNT(*) >= 3;category | 商品数
周辺機器 | 4
(1 行)前の章の顧客ごとの購入金額で、田中さんは NULL でした。SUM は、対象の値が 1 つもない(またはすべて NULL の)とき 0 ではなく NULL を返します。存在しないカテゴリで試すと、COUNT は 0 なのに SUM は NULL です。
SELECT COUNT(*), SUM(price), TOTAL(price) FROM products WHERE category = 'タブレット';COUNT(*) | SUM(price) | TOTAL(price)
0 | NULL | 0.0
(1 行)SQLite の公式ドキュメントでは「NULL は 0 行の合計として便利な結果ではないが、SQL の標準がそれを求めていて、他の多くのデータベースもそうしている」と説明され、0.0 を返す独自の TOTAL 関数も用意されています。どのデータベースでも使える方法は、COALESCE で NULL を 0 に置き換えることです。
SELECT c.name, COUNT(o.id) AS 注文数, COALESCE(SUM(p.price * o.qty), 0) AS 購入金額 FROM customers AS c LEFT JOIN orders AS o ON c.id = o.customer_id LEFT JOIN products AS p ON o.product_id = p.id GROUP BY c.id, c.name ORDER BY 購入金額 DESC;name | 注文数 | 購入金額
佐藤 | 4 | 153240
鈴木 | 3 | 113340
高橋 | 3 | 49140
田中 | 0 | 0
(4 行)なお、上の SQL に GROUP BY category を付けると結果は 0 行になりました。GROUP BY は「0 件のグループ」を作らないので、0 件の顧客なども出したいときは、全件を持つテーブルを左にして LEFT JOIN します。
SELECT DISTINCT category FROM products; と SELECT category FROM products GROUP BY category; は、どちらも同じ 3 行を返しました。重複を除くだけなら DISTINCT、件数や合計も出すなら GROUP BY を使うと、目的が伝わりやすくなります。
データベースによって違います。各データベースの公式ドキュメントで確認した結果は次のとおりです(SQLite は実行して確認しました)。
| データベース | GROUP BY で別名 | HAVING で別名 |
|---|---|---|
| SQLite | 使える | 使える |
| MySQL | 使える | 使える(標準 SQL の拡張) |
| PostgreSQL | 使える | 使えない(式をそのまま書く) |
SQLite では HAVING 商品数 >= 3 と書いても動きましたが、PostgreSQL の公式ドキュメントには「出力列の名前は ORDER BY と GROUP BY では使えるが、WHERE と HAVING では使えない」とあります。どのデータベースでも動かしたい SQL では、HAVING には HAVING COUNT(*) >= 3 のように式をそのまま書くのが安全です。