Pythonのdatetimeの使い方|日時の計算・タイムゾーン・Unix時間を実例で解説
hr
ENG LIFE BLOG
4 つのファイルをダウンロードするプログラムで、1 つに 1 秒かかるなら、順番に処理すると合計 4 秒かかります。でも、その 4 秒のほとんどは「相手の返事を待っているだけ」の時間です。待っている間に次のダウンロードを始めておけば、全体はもっと早く終わります。これを Python で書くための標準ライブラリが threading と concurrent.futures です。
この記事では、threading.Thread の start・join、ThreadPoolExecutor の map・submit・as_completed、例外の受け取り方、重い計算がスレッドで速くならない理由(GIL)と ProcessPoolExecutor、共有変数の競合と Lock を、実行結果つきで説明します。通信の代わりに time.sleep()(指定した秒数だけ止まる)を使うので、ネットワークなしで試せます。
載せている出力は、Windows 11・Python 3.12.6 で実際に実行したものです。秒数はすべてこの PC での値で、この PC の os.cpu_count()(論理 CPU の数)は 24 です。PC の性能や負荷によって秒数は変わります。コードは sample.py などの名前で保存し、PowerShell でそのフォルダーに移動してから次のコマンドで実行できます。
py sample.pyふつうの Python プログラムは、上の行から順番に実行されます。この「実行の流れ」をスレッドと呼びます。プログラムを起動すると、最初から 1 本のスレッド(メインスレッド)が動いています。threading モジュールを使うと、同じプログラムの中にスレッドを増やして、複数の処理を並べて進められます。
似た言葉にプロセスがあります。プロセスは「起動している 1 つのプログラム」で、メモリはプロセスごとに分かれています。スレッドは 1 つのプロセスの中で動くので、変数(メモリ)を共有できます。便利な反面、同じ変数を同時に書き換える危険もあります。
スレッドを作るには、threading.Thread に「別のスレッドで動かしたい関数」と「その引数」を渡します。
import threading
import time

def work(name, seconds):
    print(f"{name} 開始")
    time.sleep(seconds)
    print(f"{name} 終了")

t = threading.Thread(target=work, args=("A", 1))
t.start()
print("start() のすぐあと")
t.join()
print("join() のあと:A は終わっている")
A 開始
start() のすぐあと
A 終了
join() のあと:A は終わっているthreading.Thread(target=関数, args=(引数,)) で用意した時点では、まだ動きません。出力を見ると、start() の直後の print が「A 終了」より先に出ています。start() は「作業者に仕事を渡して、すぐ自分の作業に戻る」動きです。join() を呼ぶと、メインスレッドは A が終わるまでそこで待ちます。公式ドキュメントでも join() は「スレッドが終了するまで待つ」と説明されています。
3 つのスレッドで結果をリストに集める例です。join() を書かずに、すぐ結果を表示してみます。
import threading
import time

results = []

def work(name):
    time.sleep(1)
    results.append(name)
    print(f"{name} 終了")

threads = [threading.Thread(target=work, args=(n,)) for n in ["A", "B", "C"]]
for t in threads:
    t.start()
print("結果:", results)
print("プログラムの最後の行")
結果: []
プログラムの最後の行
B 終了
A 終了
C 終了結果のリストは空でした。メインスレッドは start() のあと待たずに進むので、まだ結果が入っていません。最後の行のあとに「終了」が出ているのは、Python がふつうの(daemon ではない)スレッドが全部終わるまでプログラムを終わらせないからです(公式ドキュメント:「生きている非 daemon スレッドがなくなると、Python プログラム全体が終了する」)。仕事は最後まで行われますが、結果を使う処理には間に合いません。
結果を使う前に、すべてのスレッドを join() します。上のコードの start() のループのあとに次の 2 行を足し、work の中の print を消して実行しました。
for t in threads:
    t.join()
結果: ['C', 'A', 'B']今度は 3 つそろいました。ただし並び順は終わった順で、実行のたびに変わります。順番が大事なら、後で説明する ThreadPoolExecutor.map が簡単です。
1 秒待つ処理 4 つを、順番に実行した場合とスレッドで実行した場合で比べます。時間は time.perf_counter() の差で測ります。
import threading
import time

def download(name):
    time.sleep(1)  # 待ち時間(通信の代わり)

names = ["A", "B", "C", "D"]

start = time.perf_counter()
for n in names:
    download(n)
print(f"順番に実行:{time.perf_counter() - start:.2f} 秒")

start = time.perf_counter()
threads = [threading.Thread(target=download, args=(n,)) for n in names]
for t in threads:
    t.start()
for t in threads:
    t.join()
print(f"スレッドで実行:{time.perf_counter() - start:.2f} 秒")
順番に実行:4.00 秒
スレッドで実行:1.00 秒順番では 1 + 1 + 1 + 1 で 4.00 秒、スレッドでは 4 つが同時に待つので 1.00 秒でした(この PC での値)。
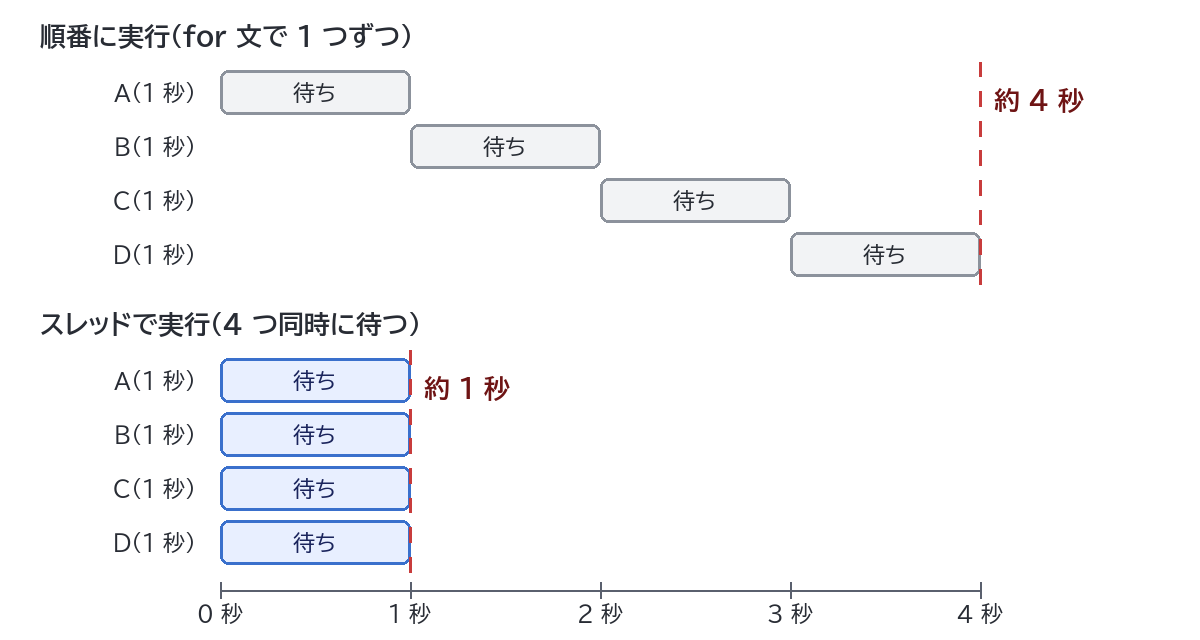
スレッドが速くしたのは待ち時間です。time.sleep や通信の返事待ちの間は、ほかのスレッドに順番をゆずります。計算そのものが速くなるわけではありません(後の「GIL」の章で確かめます)。
Thread を自分で作って start・join するのは、数が増えると面倒です。concurrent.futures の ThreadPoolExecutor を使うと、決まった数のスレッド(スレッドプール)に仕事を割り振る処理を短く書けます。
待ち時間がばらばらな 4 つの処理(A は 3 秒、B は 1 秒、C は 2 秒、D は 1 秒)を executor.map() で動かします。
import time
from concurrent.futures import ThreadPoolExecutor

def download(name, seconds):
    time.sleep(seconds)
    print(f"{name} 終了")
    return f"{name} のデータ"

names = ["A", "B", "C", "D"]
waits = [3, 1, 2, 1]

start = time.perf_counter()
with ThreadPoolExecutor(max_workers=4) as executor:
    for result in executor.map(download, names, waits):
        print("受け取り:", result)
print(f"合計 {time.perf_counter() - start:.2f} 秒")
B 終了
D 終了
C 終了
A 終了
受け取り: A のデータ
受け取り: B のデータ
受け取り: C のデータ
受け取り: D のデータ
合計 3.00 秒仕事は B・D・C・A の順に終わりましたが、受け取りは渡した順(A・B・C・D)です。map は 1 番目の結果から順に返すので、一番遅い A(3 秒)が終わるまで B の結果も受け取れません。合計は A とほぼ同じ 3.00 秒でした。
with 文で使うと、ブロックの終わりで全部の仕事が終わるまで待ってから片付けてくれる(公式ドキュメント:shutdown(wait=True) と同じ)ので、join() の書き忘れがありません。with 文の仕組みは「Pythonのwith文とは?コンテキストマネージャーの仕組みと作り方」で説明しています。
終わったものから順に処理したいときは、submit() で 1 つずつ仕事を渡し、as_completed() で受け取ります。submit は Future(「あとで結果が入る引換券」のようなオブジェクト)を返し、future.result() で結果を取り出します。
import time
from concurrent.futures import ThreadPoolExecutor, as_completed

def download(name, seconds):
    time.sleep(seconds)
    return f"{name} のデータ"

names = ["A", "B", "C", "D"]
waits = [3, 1, 2, 1]

start = time.perf_counter()
with ThreadPoolExecutor(max_workers=4) as executor:
    futures = {executor.submit(download, n, w): n for n, w in zip(names, waits)}
    for future in as_completed(futures):
        print(f"{time.perf_counter() - start:.1f} 秒:{future.result()}")
1.0 秒:B のデータ
1.0 秒:D のデータ
2.0 秒:C のデータ
3.0 秒:A のデータ今度は 1 秒の時点で B と D、2 秒で C、3 秒で A と、終わった順に受け取れました。進み具合を表示したいときや、早く終わった結果からすぐ次の処理を始めたいときに便利です。同時に終わった B と D のどちらが先に出るかは、実行のたびに変わることがあります。Future を辞書のキーにしておくと、受け取った Future がどの仕事のものかを futures[future] で調べられます。
| 書き方 | 結果の順番 | 向いている場面 |
|---|---|---|
executor.map(関数, リスト) | 渡した順 | 同じ関数をリストの全部に使い、順番どおりに結果がほしい |
executor.submit(関数, 引数) + as_completed() | 終わった順 | 終わったものから処理したい・進み具合を出したい・1 つずつ例外を扱いたい |
max_workers は、同時に動かすスレッドの最大数です。1 秒待つ処理 6 つを map で動かすと、max_workers が 1 なら 6.00 秒、2 なら 3.00 秒、3 なら 2.00 秒、6 なら 1.00 秒でした(この PC での値)。2 人で 6 つなら 3 回分、3 人なら 2 回分の時間です。省略したときの数は、公式ドキュメントによると Python 3.8 以降 min(32, os.cpu_count() + 4) で、この PC(cpu_count が 24)では 28 でした。実際の通信では、相手のサーバーに一度に大量のリクエストを送ると負担をかけたり、アクセスを制限されたりするので、相手のルールに合わせた小さめの数を指定してください。
スレッドの中で起きた例外は、そのままではメインスレッドの try・except で捕まえられません。ThreadPoolExecutor では、future.result() を呼んだときに、スレッドの中で起きたのと同じ例外が発生します(公式ドキュメント:「呼び出しが例外を発生させた場合、このメソッドは同じ例外を発生させる」)。B だけ失敗する例です。
import time
from concurrent.futures import ThreadPoolExecutor, as_completed

def download(name):
    time.sleep(0.5)
    if name == "B":
        raise ValueError(f"{name} の取得に失敗")
    return f"{name} のデータ"

with ThreadPoolExecutor(max_workers=3) as executor:
    futures = {executor.submit(download, n): n for n in ["A", "B", "C"]}
    for future in as_completed(futures):
        name = futures[future]
        try:
            print("成功:", future.result())
        except ValueError as e:
            print(f"失敗:{name}({e})")
失敗:B(B の取得に失敗)
成功: C のデータ
成功: A のデータB が失敗しても、A と C の結果は受け取れました。1 つずつ try・except で囲めるのが利点です(例外処理の基本は「Pythonの例外処理入門|try・except・finally・raiseの使い方」)。
map の場合は、失敗した結果を取り出す時点で例外が発生します。同じ download を map のループで受け取ると、「A のデータ」のあと B の ValueError で止まり、C は受け取れませんでした。
注意したいのは、submit したまま result() を呼ばない場合です。上のコードの with ブロックを次のように変えます。
with ThreadPoolExecutor(max_workers=3) as executor:
    for n in ["A", "B", "C"]:
        executor.submit(download, n)
print("終わりました")
表示は「終わりました」だけでした。B は失敗しているのにエラーは表示されず、終了コードも 0(成功)です。例外は Future の中にしまわれたままなので、結果を使わない仕事でも result() で失敗を確かめましょう。
なお、threading.Thread で直接動かした関数が例外を出した場合は、公式ドキュメントのとおり threading.excepthook() が「Exception in thread Thread-1 (work):」に続けてエラーを表示します。ただしメインスレッドはそのまま進み、try・except でも捕まえられません。
ここまでは「待つだけ」の処理でした。では、CPU で計算し続ける処理をスレッドに分けるとどうなるでしょうか。0 から 999 万 9999 までの数の 2 乗を足す関数 heavy を 4 回、順番・スレッド 4 つ・プロセス 4 つで比べました。
import os
import time
from concurrent.futures import ProcessPoolExecutor, ThreadPoolExecutor

def heavy(n):
    total = 0
    for i in range(n):
        total += i * i
    return total

if __name__ == "__main__":
    print("CPU の数:", os.cpu_count())
    jobs = [10_000_000] * 4

    start = time.perf_counter()
    for n in jobs:
        heavy(n)
    print(f"順番に実行:{time.perf_counter() - start:.2f} 秒")

    start = time.perf_counter()
    with ThreadPoolExecutor(max_workers=4) as executor:
        list(executor.map(heavy, jobs))
    print(f"スレッド 4 つ:{time.perf_counter() - start:.2f} 秒")

    start = time.perf_counter()
    with ProcessPoolExecutor(max_workers=4) as executor:
        list(executor.map(heavy, jobs))
    print(f"プロセス 4 つ:{time.perf_counter() - start:.2f} 秒")
CPU の数: 24
順番に実行:1.24 秒
スレッド 4 つ:1.20 秒
プロセス 4 つ:0.45 秒3 回実行して、順番は 1.24〜1.25 秒、スレッドは 1.20〜1.21 秒、プロセスは 0.45〜0.49 秒でした(この PC での値)。スレッドに分けても、順番とほとんど同じです。プロセスに分けると約 2.6 倍速くなりました(4 倍にならないのは、プロセスの起動やデータの受け渡しに時間がかかるため)。
理由は GIL(グローバルインタープリターロック)です。公式ドキュメントの用語集では「CPython インタープリター(ふつうの Python)が、一度に 1 つのスレッドだけが Python のバイトコードを実行するようにする仕組み」と説明されています。スレッドが 4 つあっても計算できるのは同時に 1 つだけなので、合計時間は変わりません。
同じ用語集には「I/O を行うときは、GIL は常に解放される」とも書かれています。time.sleep や通信待ちがスレッドで速くなったのは、待っている間は GIL を手放すからです。threading の公式ドキュメントも、マルチコアを活かすなら multiprocessing か ProcessPoolExecutor、複数の I/O 待ちを同時に動かすなら threading が適している、と案内しています。測り方の注意は「Pythonで処理時間を測る方法|time・perf_counter・timeitの違い」で説明しています。
上のコードは処理を if __name__ == "__main__": の中に書きました。Windows で ProcessPoolExecutor を使うときは必須です。付けずに書いてみます。
from concurrent.futures import ProcessPoolExecutor

def heavy(n):
    total = 0
    for i in range(n):
        total += i * i
    return total

with ProcessPoolExecutor(max_workers=2) as executor:
    print(list(executor.map(heavy, [1000, 2000])))
RuntimeError:
An attempt has been made to start a new process before the
current process has finished its bootstrapping phase.
(途中省略)
concurrent.futures.process.BrokenProcessPool: A process in the process pool was terminated abruptly while the future was running or pending.子プロセス(新しく起動した Python)の側で RuntimeError が起き(この PC では子プロセスの数と同じ 2 つ表示)、親は BrokenProcessPool(プロセスプールが壊れた)というエラーで止まりました。
multiprocessing の公式ドキュメントによると、Windows と macOS の標準の起動方式は spawn で、子プロセスは新しい Python を起動して元のファイルを読み込み直します。そのとき一番外側に書いた「プロセスプールを作る」行がもう一度動いてしまうので、Python が止めるわけです。if __name__ == "__main__": の中は、直接実行したときだけ動き、子プロセスが読み込み直したときには動きません。
また、プロセス間では関数・引数・結果を pickle(オブジェクトを受け渡し用のデータに変える仕組み)で送るので、関数はファイルの一番外側に def で書きます。lambda を渡すと _pickle.PicklingError: Can't pickle <function <lambda> ...> になりました。CPU をたくさん使う実験は、max_workers を os.cpu_count() 以下にし、短時間で終わる量から試してください。
スレッドは変数を共有できます。では、4 つのスレッドがそれぞれ 100 万回 counter += 1 をしたら、結果は 400 万になるでしょうか。
import threading

counter = 0

def add():
    global counter
    for _ in range(1_000_000):
        counter += 1

threads = [threading.Thread(target=add) for _ in range(4)]
for t in threads:
    t.start()
for t in threads:
    t.join()
print(counter)4000000この PC(Python 3.12.6)では 30 回とも 4000000 で、数が合わない現象は再現できませんでした。sys.setswitchinterval(0.000001)(スレッドを切り替える間隔を短くする)を付けた 5 回、クラスの属性 c.value += 1 にした 5 回もすべて 4000000 でした。global の意味は「Pythonの変数のスコープ入門|LEGB・global・nonlocalの使い方」を参照してください。
だからといって安全とは言えません。公式 FAQ(「どの種類のグローバル値の変更がスレッドセーフか」)では、i = i+1 や D[x] = D[x] + 1 はアトミック(途中で割り込まれない一続きの操作)ではない例に挙げられ、「迷ったらミューテックス(ロック)を使う」と書かれています。たまたまこの環境で合っただけ、と考えるべきです。
「読む」と「書く」の間にほかのスレッドが入り込むと何が起きるかは、その間にわざと time.sleep() をはさむと確実に再現できます。
import threading
import time

counter = 0

def add():
    global counter
    for _ in range(100):
        value = counter      # 読む
        time.sleep(0.0001)   # 読んでから書くまでの間に、ほかのスレッドが動く
        counter = value + 1  # 書く

threads = [threading.Thread(target=add) for _ in range(4)]
for t in threads:
    t.start()
for t in threads:
    t.join()
print(counter)1004 スレッド × 100 回で 400 になるはずが、3 回実行して 3 回とも 100 でした。4 つのスレッドがほぼ同時に同じ値を読み、それぞれ「読んだ値 + 1」を書き戻すので、ほかのスレッドが足した分が上書きされて消えてしまいます。これを競合状態(レースコンディション)と呼びます。
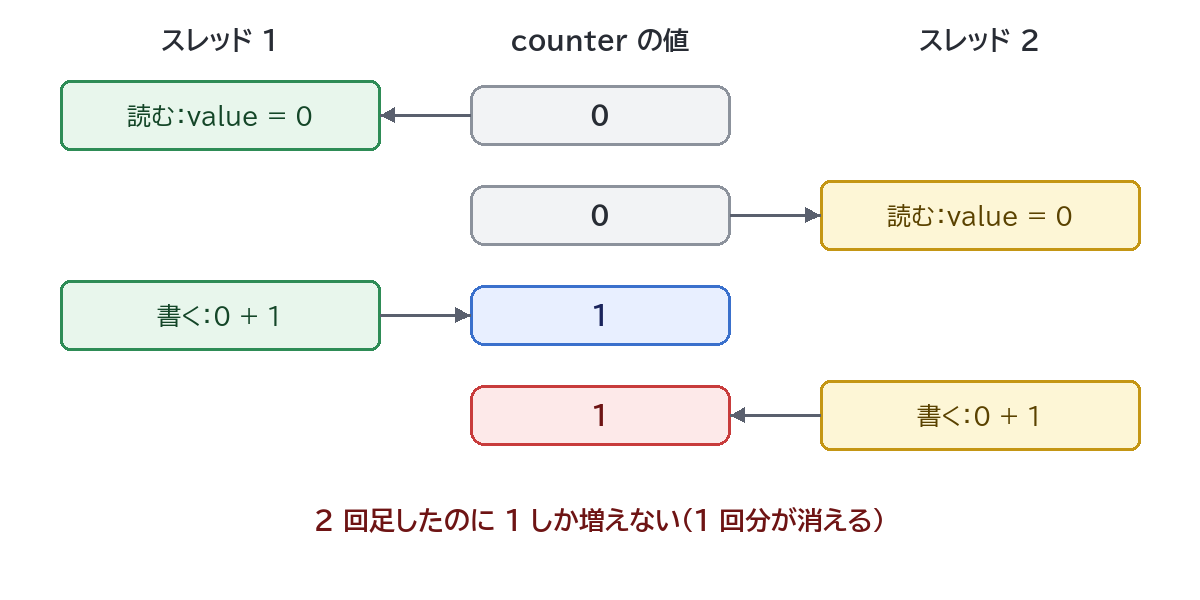
解決策は Lock(ロック)です。ロックは「1 人しか持てない鍵」のようなもので、公式ドキュメントのとおり、あるスレッドがロックを取得すると、ほかのスレッドが取得しようとしても解放されるまで待たされます。with lock: と書くと、ブロックに入るときに取得し、出るときに自動で解放します。前のコードの add を次のように変えます(スレッドを動かす部分は同じ)。
lock = threading.Lock()  # counter = 0 の下に追加

def add():
    global counter
    for _ in range(100):
        with lock:
            value = counter
            time.sleep(0.0001)
counter = value + 14003 回とも 400 になりました。ただし、ロックの中は 1 人ずつしか進めないので、その部分は並べて動かせません。この例でも、プログラム全体の実行時間(Python の起動を含む)はロックなしの約 0.09 秒からロックありの約 0.26 秒に増えました。ロックで囲むのは「共有する値を読んで書き戻す」最小限の部分にし、時間のかかる待ちはロックの外で行うのが基本です。
そもそも共有変数を書き換えないように作るのが一番安全です。ThreadPoolExecutor で各スレッドに結果を return させ、メインスレッドで集計すれば、ロックはいりません。
daemon=True を付けたスレッド(daemon スレッド)は、メインの処理が終わると途中でも打ち切られます。0.5 秒ごとに 5 回表示するスレッドを daemon にして、メインは 1.2 秒で終わらせた例です。
import threading
import time

def background():
    for i in range(1, 6):
        time.sleep(0.5)
        print(f"裏の作業 {i}")

threading.Thread(target=background, daemon=True).start()
time.sleep(1.2)
print("メインの処理が終わりました")
裏の作業 1
裏の作業 2
メインの処理が終わりました「裏の作業 3」以降は表示されずに終わりました。公式ドキュメントには、daemon スレッドは終了時に突然止められ、開いたファイルなどが正しく片付けられないことがあると注意書きがあります。途中で止まると困る処理には使わず、ふつうのスレッドにして join() で待ちます。
待ち時間を重ねる方法には asyncio もあります。asyncio は 1 本のスレッドで await のところを切り替えるので、使うライブラリが async に対応している必要があります。今あるふつうの関数をほとんど書き換えずに並べて動かしたいなら ThreadPoolExecutor、async 対応のライブラリでたくさんの通信を待つなら asyncio、CPU を使う計算なら ProcessPoolExecutor、と考えると選びやすくなります。asyncio の書き方と、async の中から止まる関数をスレッドに逃がす asyncio.to_thread() は「Pythonのasyncio入門|async・awaitの基本と同時に待つ方法」で説明しています。
公式ドキュメント「What’s New In Python 3.13」によると、3.13 で GIL を無効にして動かすフリースレッド版が実験的に導入されました。通常版とは別の実行ファイル(python3.13t.exe など)で、Windows と macOS では公式インストーラーで追加できます。スレッドが複数の CPU コアで同時に動ける一方、3.13 では「実験的で、バグやスレッド 1 本のときの大きな性能低下がありうる」とされていました。「What’s New In Python 3.14」では、PEP 779 で公式サポートになり、スレッド 1 本のときの性能低下はおよそ 5〜10%(環境による)と書かれています。この記事の計測は GIL ありの Python 3.12 のもので、フリースレッド版は試していません。
target=work(n) のようにカッコを付けると、その場で work がメインスレッドで実行されてしまい、スレッドには戻り値(None)が渡ります。1 秒待つ処理 3 つで試すと、次のようになりました。
threads = [threading.Thread(target=work(n)) for n in ["A", "B", "C"]] # 間違いA 終了
B 終了
C 終了
合計 3.00 秒エラーにはならず、順番に実行したのと同じ 3 秒かかります。正しくは target=work, args=(n,) と関数と引数を分けて渡します。引数が 1 つのとき args=("Alice") とカンマを忘れると、ただの文字列になり TypeError: work() takes 1 positional argument but 5 were given(5 文字が別々に渡された)になりました。args=("Alice",) と書きます。
仕事を並べて動かして結果を集めるなら、結果・例外の受け取り、同時に動く数の制限、最後の待ち合わせがそろった ThreadPoolExecutor が簡単です。threading.Thread は、裏で動き続けるスレッドを 1 本だけ作るような場面で使います。