JavaScriptのfetchでAPIを呼ぶ|POST・エラー処理・タイムアウト
hr
ENG LIFE BLOG
JavaScript で入力チェックや文字の置換をするときに欠かせないのが正規表現(RegExp)です。記号の意味は分かっていても、JavaScript では「new RegExp() に書いた \d が効かない」「同じ正規表現で test() したら true と false が交互に出る」「replaceAll() でエラーになる」といった、JavaScript ならではのつまずきがあります。
この記事では、正規表現の作り方・フラグ・メソッドの使い分け・名前付きグループ・置換の書き方を、実際の出力で確かめながら説明します。出力は Windows 11 の Microsoft Edge 155 で実行したものです。[0-9] や + などの記号そのものは「正規表現の基本」で解説しているので、そちらもあわせて読んでください。
初めて貼り付けるときは、詐欺を防ぐための警告が出て、確認の文字の入力を求められることがあります。知らない人から教えられたコードはコンソールに貼り付けないでください。変数名が重なってエラーになったときは F5 キーで再読み込みしてから貼り直します。コンソールでは、配列が記事の ["10", "200"] と違い ['10', '200'] のように表示されます。
JavaScript の正規表現は、/ で囲むリテラルと、文字列から作る new RegExp() の 2 通りで作れます。どちらも同じ RegExp オブジェクトになります。
const re1 = /\d{3}-\d{4}/;
const re2 = new RegExp("\\d{3}-\\d{4}");
console.log(re1.test("100-0001"), re2.test("100-0001"));
console.log(re1.source === re2.source);
true true
truesource は正規表現の中身の文字列で、2 つは同じになりました。MDN の正規表現ガイドによると、リテラルはスクリプトの読み込み時に、new RegExp() は実行時に組み立てられます。パターンが決まっているならリテラル、利用者の入力など実行するまで中身が分からないときは new RegExp を使います。
new RegExp() に渡すのはふつうの文字列なので、先に文字列のルールで \ が処理されます。"\d" の \ は文字列の段階で消え、正規表現には「d」だけが届きます。
const bad = new RegExp("\d{3}-\d{4}");
console.log(bad.source, bad.test("100-0001"), bad.test("ddd-dddd"));
d{3}-d{4} false trueエラーにならないので気づきにくい間違いです。文字列で書くときは "\\d" のように \ を 2 つ重ねます(二重エスケープ)。リテラルの中で / を使うときは \/ と書きます。
検索欄に入力された言葉で検索する、といった場面で入力をそのまま new RegExp() に渡すと、+ や ( が正規表現の記号として働いてしまいます。
const word = "1+1";
const re = new RegExp(word);
console.log(re.test("1+1=2"), re.test("11=2"));
false true「1+1」が「1 が 1 回以上、そのあとに 1」という意味になり、探したい「1+1=2」には一致せず、「11=2」に一致しました。"価格(税込" のように ( だけが入力されると「Uncaught SyntaxError: Invalid regular expression: /価格(税込/: Unterminated group」で処理が止まります。
文字をそのまま探すには、記号の前に \ を付けるエスケープが必要です。新しいブラウザには RegExp.escape() があります(MDN では Baseline 2025、2025 年 5 月から主要なブラウザの最新版で使える機能です。Edge 155 で使えることを確認しました)。
const re = new RegExp(RegExp.escape("1+1"));
console.log(re.source);
console.log(re.test("1+1=2"), re.test("11=2"));
\x31\+1
true false先頭の「1」が \x31(文字コードで書いた 1)になっているのは、前に \1 などがあるパターンにつなげても意味が変わらないようにするためです(MDN より)。古いブラウザにも対応するなら、次のような関数を自分で用意します。
function escapeRegExp(text) {
  return text.replace(/[.*+?^${}()|[\]\\]/g, "\\$&");
}
console.log(escapeRegExp("1+1"), escapeRegExp("価格(税込)"));
console.log(new RegExp(escapeRegExp("1+1")).test("1+1=2"));
1\+1 価格\(税込\)
true正規表現の記号 . * + ? ^ $ { } ( ) | [ ] \ の前に \ を付けます($& は「一致した文字」、後で説明します)。この関数は [ ] の外で使う前提です。
フラグは検索のしかたを変えるオプションで、リテラルなら /abc/gi のように後ろに、new RegExp なら new RegExp("abc", "gi") のように 2 つ目の引数に書きます。
| フラグ | 意味 | 使う場面 |
|---|---|---|
g | すべての一致を対象にする(global) | 全部取り出す・全部置換する |
i | 大文字と小文字を区別しない | Error と error を両方探す |
m | ^ $ が各行の先頭・末尾に一致する | 複数行の文字列を行ごとに調べる |
s | . が改行にも一致する | 改行をまたいで探す |
u | 文字をコードポイント(Unicode の文字番号)単位で扱う | 絵文字・\p{…} を使う |
y | lastIndex の位置からだけ探す(sticky) | 文字列を先頭から順に読み進める処理 |
d | 一致した位置(開始・終了)も記録する | グループの位置を知りたいとき |
const text = "Error: disk\nerror: memory";
console.log(text.match(/^error/gm));
console.log(text.match(/^error/gim));
console.log(/disk.error/.test(text), /disk.error/s.test(text));
["error"]
["Error", "error"]
false truem で 2 行目の先頭も ^ の対象になり、i を足すと 1 行目の「Error」も一致しました。. はふだん改行(\n)に一致しませんが、s を付けると一致します。
y は、g と違って次の文字へずらして探しません。/\d+/g.exec("abc 123") は「123」を見つけますが、/\d+/y は位置 0 の「a」で失敗して null になります。d を付けると、結果の indices に位置が入ります。/(?<year>\d{4})年/d.exec("今日は2026年10月") では、indices[0] が [3, 8](全体)、indices.groups.year が [3, 7] でした(終了位置はその文字の次の位置)。
正規表現を使うメソッドは、RegExp の側と文字列(String)の側にあります。
| 書き方 | 返すもの | 一致しないとき |
|---|---|---|
re.test(str) | true / false | false |
str.match(re) | g なし:最初の一致とグループ g あり:一致した文字の配列 | null |
str.matchAll(re) | すべての一致(グループつき)。g が必須 | 空(ループが 0 回) |
re.exec(str) | 1 件の一致とグループ(g なら続きから) | null |
str.search(re) | 最初に一致した位置 | -1 |
str.replace(re, 置換) | 置換した新しい文字列(g なしは最初の 1 件) | 元のままの文字列 |
str.replaceAll(re, 置換) | すべて置換した新しい文字列。g が必須 | 元のままの文字列 |
str.split(re) | 区切った配列 | 元の文字列 1 つだけの配列 |
const zip = /^\d{3}-\d{4}$/;
console.log(zip.test("100-0001"), zip.test("郵便番号100-0001"));
true false入力チェックでは ^ と $ で全体を囲みます。ここに g を付けてはいけない理由は、後の「落とし穴」で説明します。
const m = "注文日 2026-10-23 発送".match(/(\d{4})-(\d{2})-(\d{2})/);
console.log(m[0], m[1], m[2], m[3], m.index);
console.log("A=10, B=200, C=3".match(/\d+/g));
console.log("数字なし".match(/\d+/g));
2026-10-23 2026 10 23 4
["10", "200", "3"]
nullg なしの結果は、[0] が一致した全体、[1] 以降が ( ) で囲んだグループ、index が一致した位置(0 から数える)です。g ありは一致した文字だけの配列で、グループは入りません。そして1 件も一致しないと空の配列ではなく null です。
全部の一致について、グループも使いたいときは matchAll() を for...of で回します。
const text = "A=10, B=200, C=3";
for (const m of text.matchAll(/([A-Z])=(\d+)/g)) {
  console.log(m[1], Number(m[2]), m.index);
}
A 10 0
B 200 6
C 3 13matchAll が使えなかったころは、g 付きの正規表現で exec() をくり返す書き方が使われていました。古いコードを読むときのために見ておきましょう。
const re = /([A-Z])=(\d+)/g;
let m;
while ((m = re.exec("A=10, B=200")) !== null) {
  console.log(m[0], re.lastIndex);
}
A=10 4
B=200 11g 付きの正規表現は、lastIndex というプロパティに「次に探し始める位置」を覚えています。1 回目は「A=10」の直後の 4、2 回目は 11 になり、3 回目は見つからずに null が返ってループが終わります(このとき lastIndex は 0 に戻ります)。これが次の落とし穴の原因です。
const s = "2026/10/23";
console.log(s.replace("/", "-"), s.replace(/\//g, "-"), s.replaceAll("/", "-"));
console.log("りんご, みかん,ぶどう ,  もも".split(/\s*,\s*/));
console.log("a1b22c".split(/\d+/), "a1b22c".split(/(\d+)/));
2026-10/23 2026-10-23 2026-10-23
["りんご", "みかん", "ぶどう", "もも"]
["a", "b", "c"] ["a", "1", "b", "22", "c"]replace に文字列を渡すと最初の 1 か所だけ置換されます。全部置換するには g 付きの正規表現か replaceAll を使います。split に正規表現を渡すと、カンマの前後の空白がばらばらでもまとめて区切れます。ただし split の正規表現に ( ) があると、区切り文字も結果に入ります。区切りをまとめるだけなら (?:…)(番号を付けないグループ)を使います。
グループが増えると番号では分かりにくくなります。(?<名前>…) と書くと、結果の groups から名前で取り出せます。
const re = /(?<year>\d{4})-(?<month>\d{2})-(?<day>\d{2})/;
const m = "締め切りは 2026-10-23 です".match(re);
console.log(m.groups.year, m.groups.month, m.groups.day);
const { year, month } = m.groups;
console.log(`${year}年${Number(month)}月`);
2026 10 23
2026年10月4 行目は分割代入で、m.groups の year と month を同じ名前の変数に取り出しています。m[1] でも「2026」が取れます。同じ名前を 2 回使うと「Duplicate capture group name」の SyntaxError になります。
置換後の文字列の中では、$ で始まる特別な書き方で一致した部分を使えます(MDN の String.prototype.replace の表より)。
| 書き方 | 入るもの |
|---|---|
$1・$2 … | 1 番目・2 番目のグループ |
$<name> | 名前付きグループ |
$& | 一致した文字全体 |
$`・$' | 一致した部分より前・後ろの文字 |
$$ | $ という文字そのもの |
const s = "2026-10-23";
console.log(s.replace(/(\d{4})-(\d{2})-(\d{2})/, "$3/$2/$1"));
console.log(s.replace(/(?<y>\d{4})-(?<m>\d{2})-(?<d>\d{2})/, "$<y>年$<m>月$<d>日"));
console.log("価格100円".replace(/\d+/, "[$&]"), "100円".replace(/\d+/, "$$$&"));
23/10/2026
2026年10月23日
価格[100]円 $100円計算が必要な置換は、第 2 引数に関数を渡します。関数は一致するたびに、一致した文字全体・各グループ・位置などを受け取り、返した文字列が置換後の文字になります。
const text = "りんご 110円、みかん 98円";
const result = text.replace(/(\d+)円/g, (match, yen) => {
  return Math.round(Number(yen) * 1.1) + "円(税込)";
});
console.log(result);
りんご 121円(税込)、みかん 108円(税込)2 つ目の引数 yen に 1 番目のグループ(数字の部分)が入ります。110 * 1.1 は小数の誤差で 121.00000000000001 に、98 * 1.1 は 107.80000000000001 になるため、Math.round() で整数に丸めています(理由は「浮動小数点数の誤差」の記事で説明しています)。
「error を含む行だけ残す」つもりで、g 付きの正規表現を filter の中で使い回してみます。
const re = /error/g;
const logs = ["error 1", "error 2", "error 3", "error 4"];
console.log(logs.filter((line) => re.test(line)));
["error 1", "error 3"]4 行とも「error」を含むのに、2 行しか残りません。lastIndex を表示すると理由が分かります。
const re = /error/g;
console.log(re.test("error 1"), re.lastIndex);
console.log(re.test("error 2"), re.lastIndex);
console.log(re.test("error 3"), re.lastIndex);
true 5
false 0
true 5g 付きの test() は、一致すると lastIndex を一致の終わり(5)に進めます。次の「error 2」は別の文字列なのに 5 文字目から探すので、残りの「 2」には error がなく false になり、失敗したので lastIndex は 0 に戻ります。こうして true と false が交互に出ます。MDN の lastIndex のページにも同様の例があります。
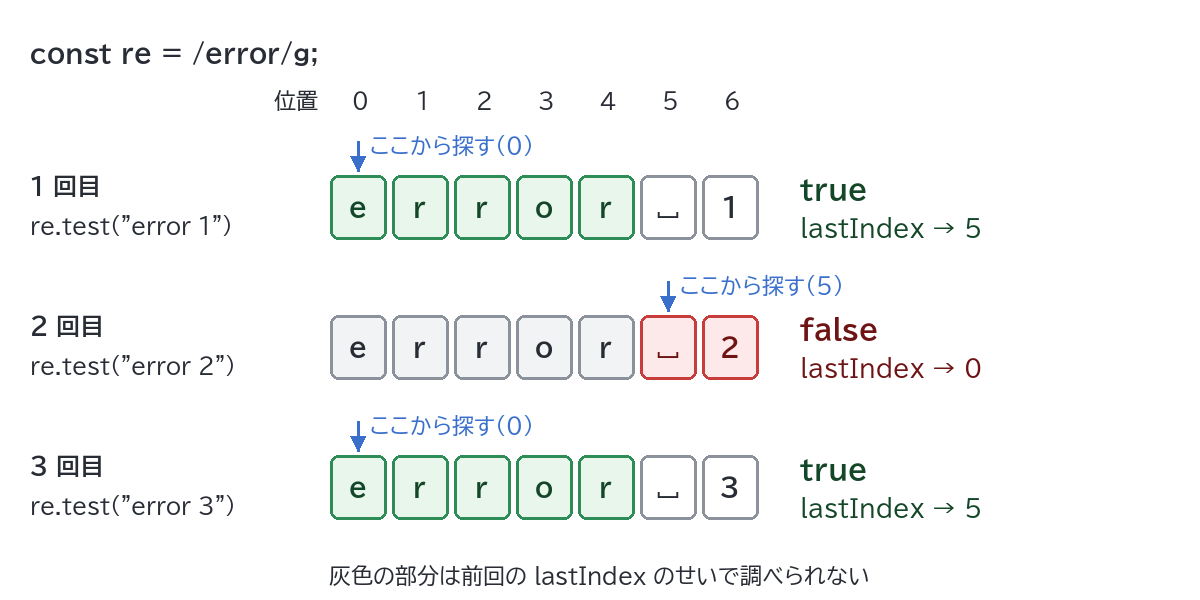
直し方は、test で true / false を調べるだけなら g を付けないことです。/error/ にすると 4 行とも残ります。g がどうしても必要なら、使う前に re.lastIndex = 0; で戻します。
JavaScript の文字列は UTF-16 という形式で、絵文字や「𠮷(つちよし)」のような一部の文字は、2 つの部品(サロゲートペア)で 1 文字を表します。u フラグがないと、正規表現もこの部品を 1 文字として数えます。
console.log("😀".length, "𠮷野家".length);
console.log(/^.$/.test("😀"), /^.$/u.test("😀"));
console.log("𠮷野家".match(/./g).length, "𠮷野家".match(/./gu).length);
console.log("😀".replace(/[😀]/g, "*"), "😀".replace(/[😀]/gu, "*"));
2 4
false true
4 3
** *u なしでは「😀」が . 1 つに一致せず、「𠮷野家」は 4 文字と数えられました。最後の例では、[😀] が「2 つの部品のどちらか」という意味になり、部品ごとに置換されて * が 2 つになっています。日本語や絵文字を扱う正規表現には u を付けるのが安全です。仕組みは「UnicodeとUTF-16・サロゲートペアとは?」で、文字数の数え方の違いは当サイトの「文字数・バイト数カウント」で確かめられます。
u フラグを付けると、\p{…} で Unicode の文字の性質(どの文字の種類か)を指定できます。
const hira = /^\p{Script=Hiragana}+$/u;
console.log(hira.test("ひらがな"), hira.test("カタカナ"), hira.test("らーめん"));
console.log(/^[\p{Script=Hiragana}ー]+$/u.test("らーめん"));
console.log(/\p{Script=Hiragana}/.test("あ"));
true false false
true
false「らーめん」が false になるのは、長音の「ー」がひらがなとカタカナの両方で使う文字で、Script(主に使う文字の種類)がひらがなではないからです。[\p{Script=Hiragana}ー] のように足すか、両方で使う文字も含める \p{scx=Hiragana}(Script_Extensions)を使うと通ります。最後の行のようにu を忘れると \p は「p」という文字の意味になり、エラーにならずに false になります。\p{Script=Katakana}・\p{Script=Han}(漢字)も同じように使えます。
"2026/10/23".replaceAll(/\//, "-");Uncaught TypeError: String.prototype.replaceAll called with a non-global RegExp argument「g のない(non-global)正規表現で replaceAll が呼ばれた」という意味です。/\//g と g を付けます。matchAll も同じで、「String.prototype.matchAll called with a non-global RegExp argument」になります。
"数字なし".match(/\d+/g).length は「Uncaught TypeError: Cannot read properties of null (reading ‘length’)」になります。match は一致しないと null なので、("数字なし".match(/\d+/g) ?? []).length と ?? [](null なら空の配列)を付けると 0 になります。
const price = "$&100";
console.log("料金:XXX".replace("XXX", price));
console.log("料金:XXX".replace("XXX", () => price));
料金:XXX100
料金:$&100第 1 引数が文字列でも、第 2 引数の $& は「一致した文字」に置き換わります。利用者の入力など中身が分からない文字列を入れるときは、2 行目のように関数で返すと、$ がそのまま入ります。
正規表現の書き方によっては、特定の入力で処理時間が爆発的に増え、ページやサーバーが固まることがあります。これを悪用する攻撃を ReDoS(正規表現によるサービス妨害)と呼びます。OWASP(Web セキュリティの国際的な団体)の解説では、入力の長さに対して指数関数的に遅くなりうる、とされています。
OWASP は危険なパターン(Evil Regex)の特徴を「くり返しのあるグループ」で、その中に「さらにくり返し」か「重なり合う選択肢」があるもの、としています。例として (a+)+$・([a-zA-Z]+)*$・(a|aa)+$・(a|a?)+$ が挙げられています。同じ文字列を分ける方法が何通りもあるため、最後で一致に失敗すると、正規表現が分け方の組み合わせを全部試し直してしまうのです。
対策は、(…+)+ のようなくり返しの中のくり返しを書かないこと、正規表現で調べる前に入力の長さを制限すること、利用者が入力した文字を正規表現として実行しないこと(文字として探すなら RegExp.escape でエスケープする)です。ページが固まるおそれがあるため、この記事では試していません。
MDN によると「u モードの改良版」で、[\p{Script=Hiragana}--[ぁ]](ひらがなから「ぁ」を除く)のような集合の引き算などが書けます。Edge 155 で動くことを確認しましたが、まずは u を使えれば十分です。u と v は同時に付けられません。
おおまかには、test が re.search、g 付きの match が re.findall、matchAll が re.finditer、g 付きの replace が re.sub に当たります。名前付きグループは Python では (?P<name>…) と書きます。大きな違いは、Python の re.sub は初期状態で全部置換するのに対し、JavaScript の replace は g がないと 1 件だけなことです。Python 側は「Pythonの正規表現入門」で解説しています。
決まったパターンは /…/、実行時に作るなら new RegExp(\\ を重ね、利用者の入力はエスケープ)。全部を対象にするなら g、ただし test で使い回すなら g を付けない。一致しない match は null、replaceAll と matchAll には g が必須、日本語や絵文字には u。この 4 つを押さえれば、JavaScript の正規表現でつまずくことはぐっと減ります。