Pythonのbisectとheapq入門|二分探索と優先度付きキューを実例で解説
hr
ENG LIFE BLOG
API に画像を送る、JWT の中身をのぞく、Basic 認証のヘッダーを組み立てる。Python でこうした処理を書くと、Base64 の変換がよく出てきます。Python には標準ライブラリの base64 モジュールがあり、インストールなしで使えます。
この記事では、b64encode と b64decode の基本から、つまずきやすい「str を渡すと TypeError」「日本語の文字コード」「Incorrect padding」「URL-safe 形式」までを、実際のコードと出力で説明します。載せている出力は、Windows 11・Python 3.12.6 で実際に実行して確かめたものです。
Base64 の仕組み(データを 6 ビットずつ区切って 64 種類の文字に置き換える方法)は「Base64とは?」で解説しているので、この記事では Python のコードでの使い方に絞ります。コードを書かずに変換だけしたいときは、ブラウザで使える「Base64エンコード・デコードツール」が便利です。
最初に覚えておきたいのは、base64 モジュールの関数は文字列(str)ではなく bytes を受け取り、bytes を返すということです。bytes は「b’Hello’」のように先頭に b が付く、バイトの並びを表す型です。よく使う関数は次のとおりです。
| 関数 | やること | 例(入力 → 出力) |
|---|---|---|
b64encode(データ) | Base64 にエンコードする | b'Hello' → b'SGVsbG8=' |
b64decode(データ) | Base64 をデコードする | 'SGVsbG8=' → b'Hello' |
urlsafe_b64encode(データ) | URL-safe 形式(+ / の代わりに – _)でエンコード | b'???' → b'Pz8_' |
urlsafe_b64decode(データ) | URL-safe 形式をデコードする | 'Pz8_' → b'???' |
encodebytes(データ) | 76 文字ごとに改行を入れてエンコード(メール向け) | 長いデータを複数行の Base64 に |
デコード側の b64decode と urlsafe_b64decode は、bytes だけでなく、英数字と記号だけでできた文字列(ASCII の str)もそのまま受け取れます。エンコード側は bytes しか受け取りません。
文字列を Base64 にするには、「文字列 → bytes → Base64 の bytes → 文字列」と 3 回変換します。次のコードを sample.py という名前で保存します。
import base64

text = "Hello, Python!"
data = text.encode("utf-8")       # str → bytes
print(data)

encoded = base64.b64encode(data)  # bytes → Base64 の bytes
print(encoded)

result = encoded.decode("ascii")  # Base64 の bytes → str
print(result, type(result))
PowerShell で、sample.py を保存したフォルダーに移動してから実行します。
py sample.pyb'Hello, Python!'
b'SGVsbG8sIFB5dGhvbiE='
SGVsbG8sIFB5dGhvbiE= <class 'str'>2 行目の b'SGVsbG8sIFB5dGhvbiE=' は、Base64 の結果ですがまだ bytes です。JSON に入れたり画面に表示したりするには、3 行目のように .decode("ascii") で文字列にします。Base64 の結果は英数字と「+ / =」だけなので、"ascii" でも "utf-8" でも同じ結果になります。
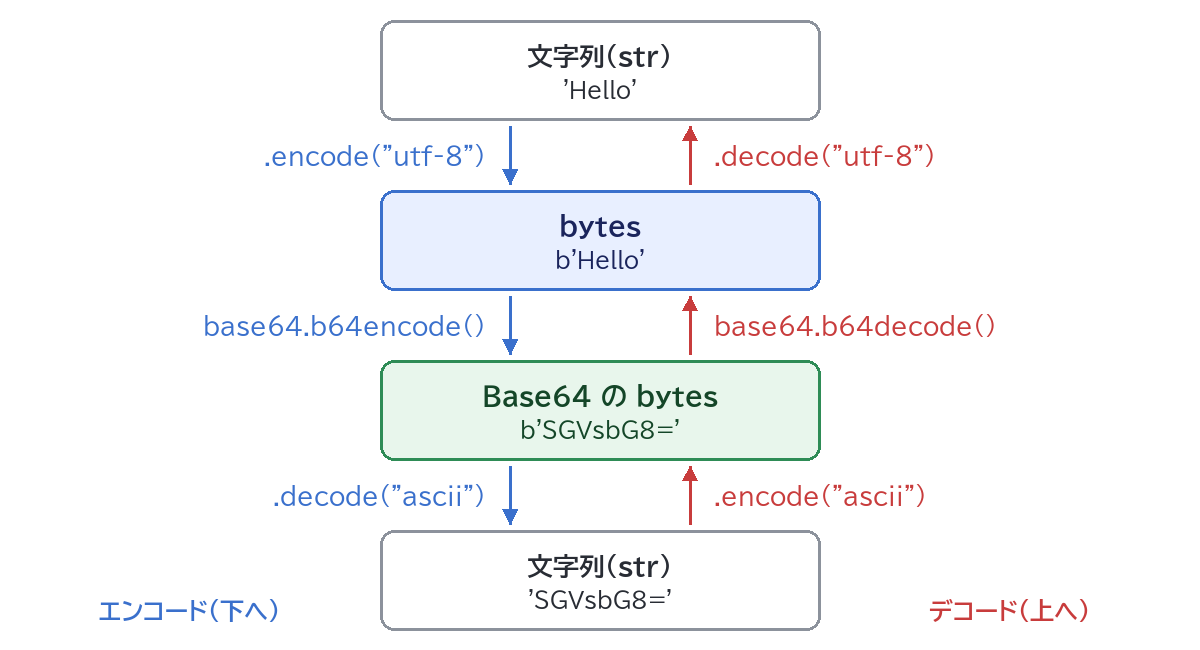
戻すときは逆の順番です。b64decode は Base64 の文字列をそのまま受け取れるので、図 1 の「.encode(“ascii”)」は省略できます。
import base64

encoded = "SGVsbG8sIFB5dGhvbiE="
data = base64.b64decode(encoded)  # Base64 → bytes
print(data)
print(data.decode("utf-8"))       # bytes → str
b'Hello, Python!'
Hello, Python!いちばん多い間違いは、b64encode に文字列をそのまま渡すことです。
import base64

base64.b64encode("Hello")
Traceback (most recent call last):
...
TypeError: a bytes-like object is required, not 'str'「bytes のようなオブジェクトが必要なのに、str が渡された」という意味です。base64.b64encode("Hello".encode("utf-8")) のように、先に encode で bytes にしてから渡せば解決します。決まった英数字だけなら b"Hello" と書いても bytes になります。
Base64 が変換するのは文字ではなくバイトです。そのため、同じ「こんにちは」でも、どの文字コードで bytes にしたかによって Base64 の結果が変わります。
import base64

text = "こんにちは"
u = base64.b64encode(text.encode("utf-8")).decode("ascii")
s = base64.b64encode(text.encode("shift_jis")).decode("ascii")
print("UTF-8    :", u)
print("Shift_JIS:", s)
UTF-8 : 44GT44KT44Gr44Gh44Gv
Shift_JIS: grGC8YLJgr+CzQ==UTF-8 ではひらがな 1 文字が 3 バイト、Shift_JIS では 2 バイトなので、長さも中身もまったく違います。Shift_JIS で作った Base64 を UTF-8 として戻そうとすると、エラーになります。
import base64

data = base64.b64decode("grGC8YLJgr+CzQ==")
print(data.decode("shift_jis"))
print(data.decode("utf-8"))
こんにちは
Traceback (most recent call last):
...
UnicodeDecodeError: 'utf-8' codec can't decode byte 0x82 in position 0: invalid start byteBase64 のデコード自体は成功していて、失敗しているのは最後の「bytes → 文字列」の部分です。エンコードしたときと同じ文字コードで戻すのが決まりで、相手との取り決めがなければ UTF-8 を使うのが今の標準です。文字コードの違いは「文字コードとは?」で詳しく説明しています。
通常の Base64 に出てくる「+」と「/」は、URL の中では特別な意味を持ちます。URL やファイル名に入れるときは、urlsafe_b64encode を使うと「+」が「-」に、「/」が「_」に置き換わります(RFC 4648 の 5 章で定められた base64url という形式です)。「寿司」を UTF-8 で変換すると、違いがよく分かります。
import base64

data = "寿司".encode("utf-8")
print(base64.b64encode(data))
print(base64.urlsafe_b64encode(data))
print(base64.urlsafe_b64decode("5a-_5Y-4").decode("utf-8"))
b'5a+/5Y+4'
b'5a-_5Y-4'
寿司「+」「/」が出てこないデータでは、2 つの関数の結果は同じです。たとえば「Hello」はどちらでも b'SGVsbG8=' になります。そのため、短いテストデータでは違いに気づかず、本番のデータで初めて問題が出ることがあります。
URL-safe の値を、間違えて通常の b64decode で戻そうとするとエラーになります。b64decode は初期設定では Base64 の文字以外(ここでは「-」と「_」)を黙って捨てるため、文字数が合わなくなるからです。
import base64

base64.b64decode("5a-_5Y-4")
Traceback (most recent call last):
...
binascii.Error: Invalid base64-encoded string: number of data characters (5) cannot be 1 more than a multiple of 48 文字のうち「-」「_」「-」の 3 文字が捨てられ、残りの 5 文字では Base64 として成り立たない、という意味です。URL-safe で作った値は urlsafe_b64decode で戻します。
Base64 は 4 文字単位で、足りない分は末尾に「=」を付けて長さをそろえます。ところが JWT のように、URL-safe 形式で末尾の「=」を省く使い方がよくあります(RFC 4648 の 3.2 節は、データの長さが分かる場合はパディングを省いてよいとしています)。省かれた値をそのままデコードするとエラーになります。
import base64

encoded = base64.urlsafe_b64encode(b"Hello").decode("ascii")
print(encoded)
nopad = encoded.rstrip("=")
print(nopad)
base64.urlsafe_b64decode(nopad)
SGVsbG8=
SGVsbG8
Traceback (most recent call last):
...
binascii.Error: Incorrect padding「Incorrect padding」は「パディング(=)が正しくない」という意味です。長さが 4 の倍数になるまで「=」を足せば戻せます。足す数は -len(s) % 4 で計算できます(長さを 4 で割った余りが 3 なら 1 個、2 なら 2 個、0 なら 0 個)。
import base64

def b64url_decode(s: str) -> bytes:
    s += "=" * (-len(s) % 4)
    return base64.urlsafe_b64decode(s)

for s in ["SGVsbG8", "SGVsbA", "SGVs", "SGVsbG8="]:
    print(s, "->", b64url_decode(s))
SGVsbG8 -> b'Hello'
SGVsbA -> b'Hell'
SGVs -> b'Hel'
SGVsbG8= -> b'Hello'もともと「=」が付いている値(最後の例)を渡しても、足す数は 0 個なので問題ありません。なお、長さを 4 で割った余りが 1 の値(例:SGVsb)は、「=」を足しても Base64 として成り立たないので、コピーの途中で欠けていないかを確認しましょう。このときのエラーは「number of data characters (5) cannot be 1 more than a multiple of 4」になります。
先ほど見たように、b64decode は初期設定(validate=False)では Base64 の文字以外を捨ててからデコードします。公式ドキュメントにも「validate が False(初期値)なら、通常の Base64 の文字でも代わりの文字でもないものは、パディングの確認の前に捨てられる。True なら binascii.Error になる」と書かれています。外から受け取った値をチェックしたいときは validate=True を付けます。
import base64
import binascii

for s in ["SGVsbG8=", "SGVs!!bG8=", "SGVsbG8=abc"]:
    for v in (False, True):
        try:
            r = base64.b64decode(s, validate=v)
        except binascii.Error as e:
            r = f"binascii.Error: {e}"
        print(repr(s), v, r)
'SGVsbG8=' False b'Hello'
'SGVsbG8=' True b'Hello'
'SGVs!!bG8=' False b'Hello'
'SGVs!!bG8=' True binascii.Error: Only base64 data is allowed
'SGVsbG8=abc' False b'Hello'
'SGVsbG8=abc' True binascii.Error: Excess data after padding初期設定のままだと、「!!」が混ざった値も、「=」の後ろに余計な文字が付いた値も、エラーにならずに「Hello」になってしまいます。RFC 4648 の 3.3 節は、参照する仕様が特に認めていない限り、アルファベット以外の文字を含むデータは拒否しなければならない(MUST reject)としています。入力チェックが目的なら validate=True を付けて、エラーを binascii.Error で受け止めましょう。binascii.Error は ValueError の仲間なので、except ValueError でも受け止められます。
メール(MIME)の添付ファイルなどでは、Base64 を 76 文字ごとに改行する決まりがあります。encodebytes を使うと、76 文字ごとと最後に改行(\n)が入ります。0〜99 の 100 バイトで比べてみます。
import base64

data = bytes(range(100))
lines = base64.encodebytes(data)
print(lines)
print(base64.b64encode(data))
print(base64.b64decode(lines) == data)
b'AAECAwQFBgcICQoLDA0ODxAREhMUFRYXGBkaGxwdHh8gISIjJCUmJygpKissLS4vMDEyMzQ1Njc4\nOTo7PD0+P0BBQkNERUZHSElKS0xNTk9QUVJTVFVWV1hZWltcXV5fYGFiYw==\n'
b'AAECAwQFBgcICQoLDA0ODxAREhMUFRYXGBkaGxwdHh8gISIjJCUmJygpKissLS4vMDEyMzQ1Njc4OTo7PD0+P0BBQkNERUZHSElKS0xNTk9QUVJTVFVWV1hZWltcXV5fYGFiYw=='1 行目は 76 文字目の後ろと最後に \n が入っています。b64encode は改行を入れません。RFC 4648 の 3.1 節も、参照する仕様が求めない限り改行を入れてはいけないとしているので、API や JSON に入れるときは b64encode を使います。改行入りの値は、改行が捨てられるので b64decode(初期設定)でもそのまま戻せます(実行結果の 3 行目は True)。ただし validate=True を付けると、改行も不正な文字として扱われエラーになります。
小さな画像を HTML や CSS に直接書くときの「data:image/png;base64,…」という文字列(data URI)を作る例です。ファイルを read_bytes() で bytes のまま読み、種類(MIME タイプ)は標準ライブラリの mimetypes で拡張子から調べます。ここでは 1×1 ピクセルの赤い PNG 画像(69 バイト)を red.png として、sample.py と同じフォルダーに置いて試しました。
import base64
import mimetypes
from pathlib import Path

def to_data_uri(path: str) -> str:
    mime, _ = mimetypes.guess_type(path)
    if mime is None:
        mime = "application/octet-stream"
    b64 = base64.b64encode(Path(path).read_bytes()).decode("ascii")
    return f"data:{mime};base64,{b64}"

uri = to_data_uri("red.png")
print(uri)
print(f'<img src="{uri}" alt="赤い点">')
data:image/png;base64,iVBORw0KGgoAAAANSUhEUgAAAAEAAAABCAIAAACQd1PeAAAADElEQVR4nGP4z8AAAAMBAQDJ/pLvAAAAAElFTkSuQmCC
<img src="data:image/png;base64,iVBORw0KGgoAAAANSUhEUgAAAAEAAAABCAIAAACQd1PeAAAADElEQVR4nGP4z8AAAAMBAQDJ/pLvAAAAAElFTkSuQmCC" alt="赤い点">Base64 の部分は 92 文字で、元の 69 バイトの約 1.33 倍です。結果は画像ごとに変わるので、自分の画像で試すと違う文字列になります。PNG の Base64 は必ず「iVBORw0KGgo」で始まるので、見分けるときの目印になります。画像は open(path, "rb") のようにバイナリで読むこと(テキストモードで開かないこと)が大事です。ファイルの開き方は「Pythonのファイル読み書き」で説明しています。
逆に、受け取った data URI をファイルに保存するときは、「,」より前の部分を取り除いてからデコードします。
import base64
from pathlib import Path

uri = "data:image/png;base64,iVBORw0KGgoAAAANSUhEUgAAAAEAAAABCAIAAACQd1PeAAAADElEQVR4nGP4z8AAAAMBAQDJ/pLvAAAAAElFTkSuQmCC"
header, _, b64 = uri.partition(",")
print(header)
data = base64.b64decode(b64, validate=True)
print(data[:8])
Path("copy.png").write_bytes(data)
data:image/png;base64
b'\x89PNG\r\n\x1a\n'先頭の 8 バイトが PNG の目印(\x89PNG で始まる並び)になっていて、保存した copy.png は元の red.png とバイト単位で同じでした。「,」の前を残したまま validate=True でデコードすると、「:」「;」などが不正な文字としてエラーになります。
JWT(JSON Web Token)は「ヘッダー.ペイロード.署名」を「.」でつないだ文字列で、それぞれが URL-safe Base64 です。JWT の仕様(RFC 7515)では、末尾の「=」を省くことになっています。そのため、ここまでの「URL-safe」と「= を補う」の両方が必要です。次のトークンは説明用に作ったダミーで、署名の部分も本物ではありません。
import base64
import datetime
import json

token = "eyJhbGciOiJIUzI1NiIsInR5cCI6IkpXVCJ9.eyJzdWIiOiJ1c2VyMTIzIiwibmFtZSI6IkhhbmFrbyIsImV4cCI6MTc5ODcyOTIwMH0.dummy-signature"

def b64url_decode(s: str) -> bytes:
    s += "=" * (-len(s) % 4)
    return base64.urlsafe_b64decode(s)

header_b64, payload_b64, signature = token.split(".")
header = json.loads(b64url_decode(header_b64))
payload = json.loads(b64url_decode(payload_b64))
print(header)
print(payload)

jst = datetime.timezone(datetime.timedelta(hours=9))
print(datetime.datetime.fromtimestamp(payload["exp"], jst))
{'alg': 'HS256', 'typ': 'JWT'}
{'sub': 'user123', 'name': 'Hanako', 'exp': 1798729200}
2027-01-01 00:00:00+09:00このペイロードの部分は 67 文字で 4 の倍数ではないため、「=」を補わずに urlsafe_b64decode に渡すと「Incorrect padding」になります。json.loads は bytes も受け取れるので、デコード結果をそのまま渡しています(JSON の扱いは「PythonでJSONを扱う方法」を参照)。
注意したいのは、中身を読めることと、トークンが正しいことは別という点です。このコードは署名を確認していないので、ログインの判定などには使えません。署名の確認には専用のライブラリを使います。中身をさっと確かめたいだけなら、ブラウザで使える「JWTデコーダー」も使えます。
HTTP の Basic 認証では「ユーザー名:パスワード」を Base64 にしてヘッダーに入れます。ここで、bytes のまま f 文字列に入れてしまう間違いがよく起きます。
import base64

token = base64.b64encode(b"user:pass")
print(f"Authorization: Basic {token}")
print(f"Authorization: Basic {token.decode('ascii')}")
Authorization: Basic b'dXNlcjpwYXNz'
Authorization: Basic dXNlcjpwYXNz1 行目は「b’」と「’」まで文字列に入ってしまい、サーバーでは認証に失敗します。HTTP リクエストの送り方は「PythonでHTTPリクエストを送る方法」で説明しています。
Base64 にした文字列は読めないように見えますが、鍵もいらず、誰でも 1 行で元に戻せます。
import base64

hidden = base64.b64encode(b"password123")
print(hidden)
print(base64.b64decode(hidden))
b'cGFzc3dvcmQxMjM='
b'password123'RFC 4648 のセキュリティの節(12 章)も、Base64 などの符号化は読める文字を見えにくくするだけで、計算上の秘密性は何も与えないとしています。パスワードや API キーを Base64 にして設定ファイルやデータベースに置いても、守ったことにはなりません。パスワードの保存方法は「パスワードの安全な保存方法」で解説しています。
base64 モジュールには、Base64 の仲間の形式も入っています。使う場面は限られますが、名前を見かけたときのために「Hello」で比べておきます。
import base64

data = b"Hello"
print(base64.b64encode(data))
print(base64.b32encode(data))
print(base64.b16encode(data))
print(base64.b85encode(data))
b'SGVsbG8='
b'JBSWY3DP'
b'48656C6C6F'
b'NM&qnZv'同じ 1,024 バイトを変換すると、Base64 は 1,368 文字、Base32 は 1,640 文字、Base16 は 2,048 文字、Base85 は 1,280 文字でした。Base32 は英大文字と数字の 2〜7 だけを使うので、大文字・小文字を区別しない場所に向いています。Base85 は公式ドキュメントで「git 形式のバイナリの差分などで使われる」と紹介されています。
Base16 は 16 進数の表記と同じで、data.hex() の結果(48656c6c6f)を大文字にしたものです。b16decode は初期設定では小文字を受け付けず、b16decode("48656c6c6f") は「binascii.Error: Non-base16 digit found」になります。小文字も受け付けるには casefold=True を付けます。
| 症状・エラー | 原因 | 直し方 |
|---|---|---|
| TypeError: a bytes-like object is required, not ‘str’ | b64encode に str を渡した | .encode("utf-8") で bytes にしてから渡す |
結果に b'...' が付く | bytes のまま表示・連結している | .decode("ascii") で str にする |
| TypeError: Object of type bytes is not JSON serializable | bytes のまま JSON に入れた | .decode("ascii") で str にする |
| binascii.Error: Incorrect padding | 末尾の「=」が省かれている | "=" * (-len(s) % 4) を足す |
| number of data characters … cannot be 1 more than a multiple of 4 | 値が欠けている、または URL-safe の値を b64decode に渡した | 値を確認する。URL-safe なら urlsafe_b64decode を使う |
| UnicodeDecodeError | エンコードしたときと違う文字コードで戻した | 同じ文字コード(多くは UTF-8)で decode する |
| ゴミが混ざった値でもデコードできてしまう | validate=False(初期設定)は不正な文字を捨てる | validate=True を付ける |
3 バイトごとに 4 文字になるので、約 1.33 倍です(「=」を含めて、元のバイト数を 3 で割って切り上げた数 × 4 文字)。この記事の例では、69 バイトの PNG が 92 文字、1,024 バイトが 1,368 文字になりました。大きなファイルを Base64 で JSON に入れるとデータ量が増えるので、ファイルのアップロードは multipart 形式など別の方法も検討しましょう。
urlsafe_b64encode / urlsafe_b64decode を使い、省かれた「=」は補うvalidate=True。Base64 は暗号ではない