SQLのGROUP BYと集計関数|COUNT・SUM・AVG・HAVINGの使い方
hr
ENG LIFE BLOG
SQL のインデックス(索引)は、テーブルから行を探す時間を短くするための仕組みです。数十万行のテーブルでは、インデックスがあるかどうかで同じ SELECT の時間が何百倍も変わります。一方で「作ったのに使われない」「作りすぎて INSERT が遅くなった」というトラブルもよく起きます。
この記事では、50 万行の注文テーブルを実際に作り、CREATE INDEX の前後で EXPLAIN QUERY PLAN の表示と実行時間がどう変わるかを確かめます。複合インデックスの列の順番、インデックスが効かない書き方、インデックスの欠点、UNIQUE インデックスまで、実行結果つきで解説します。SELECT 文の基本は「SQL入門:SELECT文の基本」で解説しています。
分厚い技術書で「トランザクション」の説明を探すとき、1 ページ目から順に全部めくる人はいません。巻末の索引を開き、五十音順に並んだ言葉から「トランザクション……p.215」を見つけて、そのページへ直接飛びます。
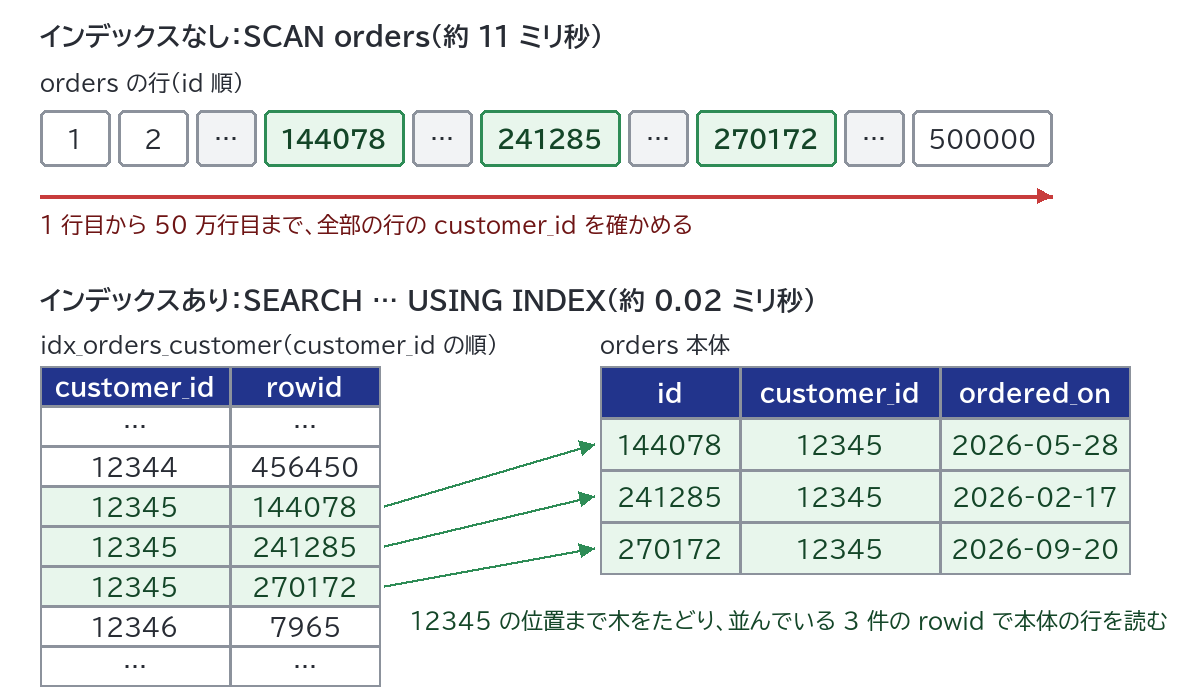
データベースのインデックスも同じです。インデックスがないと、データベースは条件に合う行を探すためにテーブルの行を最初から最後まで全部読みます(フルテーブルスキャン)。インデックスは「列の値」と「その行の場所」を、値の順に並べた別のデータです。値の順に並んでいるので、目的の値まで一気にたどり着けます。
| 本 | データベース |
|---|---|
| 本文のページ | テーブルの行 |
| 巻末の索引(言葉が五十音順) | インデックス(列の値が順番に並ぶ) |
| 索引に書かれたページ番号 | 行の場所(SQLite では rowid という行番号) |
| 1 ページ目から全部めくる | フルテーブルスキャン |
多くのデータベースは、インデックスを B-tree という形で保存します。SQLite のファイル形式の公式ドキュメントにも「スキーマの各インデックスに対して、データベースファイルに 1 つのインデックス B-tree がある」とあり、テーブル自体も B-tree で保存されています。
B-tree は、値の順に並んだデータを「目次の目次」のように階層にしたものです。上の階層で「12,000 番台はこっち」と枝分かれをたどっていくので、全部を読まなくても目的の値に着きます。SQLite の公式ドキュメント「Query Planning」では、インデックス(や rowid)で探す時間は「行数 N に比例するフルテーブルスキャンと違い、logN に比例する」と説明されています。行数が 1,000 倍になっても、探す手間は数段ぶん増えるだけ、というイメージです。インデックスで行番号(rowid)を見つけ、その rowid でテーブル本体の行を読む、という 2 段階で行を取り出します。
Python に標準で入っている SQLite(エスキューライト)を使います。次のコードを sql_index_practice.py という名前で保存してください。顧客(customers)10 万行と注文(orders)50 万行のテーブルをメモリー上に作り、入力した SQL を実行して、かかった時間も表示します。データは毎回同じものができ、終了すると消えます。
import random
import sqlite3
import time

random.seed(1)
# cached_statements=0:SQL の使い回しをやめ、EXPLAIN の結果が古くならないようにする
con = sqlite3.connect(":memory:", cached_statements=0)
con.executescript("""
CREATE TABLE customers (
  id    INTEGER PRIMARY KEY,
  email TEXT    NOT NULL,
  zip   TEXT    NOT NULL
);
CREATE TABLE orders (
  id          INTEGER PRIMARY KEY,
  customer_id INTEGER NOT NULL,
  status      TEXT    NOT NULL,
  ordered_on  TEXT    NOT NULL,
  amount      INTEGER NOT NULL
);
""")
con.executemany(
    "INSERT INTO customers VALUES (?, ?, ?)",
    ((i, f"user{i:06d}@example.com", f"{random.randint(1000000, 9999999)}")
     for i in range(1, 100001)),
)
statuses = ["shipped"] * 8 + ["pending", "cancelled"]
con.executemany(
    "INSERT INTO orders VALUES (?, ?, ?, ?, ?)",
    ((i, random.randint(1, 100000), random.choice(statuses),
      f"2026-{random.randint(1, 9):02d}-{random.randint(1, 28):02d}",
      random.randint(1, 500) * 100)
     for i in range(1, 500001)),
)
con.commit()

print("SQL を入力して Enter(終了は exit)")
while True:
    sql = input("sql> ").strip()
    if sql.lower() in ("exit", "quit"):
        break
    if not sql:
        continue
    try:
        start = time.perf_counter()
        cur = con.execute(sql)
        rows = cur.fetchall()
        ms = (time.perf_counter() - start) * 1000
    except sqlite3.Error as e:
        print("エラー:", e)
        continue
    if sql.upper().startswith("EXPLAIN QUERY PLAN"):
        for row in rows:
            print(row[3])
        continue
    if cur.description is None:
        print(f"(完了:{ms:.2f} ミリ秒)")
        continue
    print(" | ".join(d[0] for d in cur.description))
    for row in rows[:10]:
        print(" | ".join("NULL" if v is None else str(v) for v in row))
    if len(rows) > 10:
        print("…")
    print(f"({len(rows)} 行、{ms:.2f} ミリ秒)")
保存したフォルダーで次のコマンドを実行すると、数秒でデータができて「sql>」と表示されます。この記事の SQL を 1 行で入力して Enter を押してください(Python 3.12・SQLite 3.45 で確認しました)。
py sql_index_practice.py注文テーブルの先頭はこうなっています。customer_id が顧客の番号、ordered_on が注文日です。
SELECT * FROM orders LIMIT 3;id | customer_id | status | ordered_on | amount
1 | 48402 | cancelled | 2026-05-26 | 40200
2 | 39000 | shipped | 2026-01-06 | 43700
3 | 73200 | pending | 2026-06-26 | 9100表示される時間は実行のたびに少し変わり、PC によっても違います。この記事の数値は筆者の PC(Windows 11)の値です。
SQL の前に EXPLAIN QUERY PLAN を付けると、SQLite はその SQL を実行せずに「どうやって行を探すつもりか」(実行計画)を表示します。顧客番号 12345 の注文を探す SQL で試します。
EXPLAIN QUERY PLAN SELECT * FROM orders WHERE customer_id = 12345;SCAN orders「SCAN orders」は、orders テーブルを全部読むという意味です。実際に実行してみます。
SELECT * FROM orders WHERE customer_id = 12345;id | customer_id | status | ordered_on | amount
144078 | 12345 | shipped | 2026-05-28 | 29500
241285 | 12345 | pending | 2026-02-17 | 33500
270172 | 12345 | shipped | 2026-09-20 | 18800
(3 行、11.39 ミリ秒)欲しいのは 3 行だけなのに、50 万行を全部確かめているので約 11 ミリ秒かかりました。
インデックスは CREATE INDEX インデックス名 ON テーブル名(列名); で作ります。名前は何でもよいですが、「idx_テーブル名_列名」のようにすると後で分かりやすくなります。
CREATE INDEX idx_orders_customer ON orders(customer_id);作るときに 50 万行を並べ替えるので、少し時間がかかります(筆者の PC で約 130 ミリ秒)。もう一度実行計画を見ます。
EXPLAIN QUERY PLAN SELECT * FROM orders WHERE customer_id = 12345;SEARCH orders USING INDEX idx_orders_customer (customer_id=?)「SCAN」が「SEARCH … USING INDEX」に変わりました。SQLite の公式ドキュメントでは「SCAN はフルテーブルスキャン」「SEARCH はテーブルの一部の行だけを読む」と説明されています。括弧内の (customer_id=?) は、インデックスを「customer_id が ある値と等しい」という条件で使ったことを表します。同じ SELECT を実行すると、次のようになりました。
(3 行、0.02 ミリ秒)結果の 3 行は同じで、時間は 11.39 ミリ秒から 0.02 ミリ秒になりました。インデックスは結果を変えず、探し方だけを変えるものです。
idx_orders_customer だけがある状態で試した結果です。
| SQL の WHERE・ORDER BY | 表示 | 意味 |
|---|---|---|
| WHERE customer_id = 12345 | SEARCH orders USING INDEX idx_orders_customer (customer_id=?) | インデックスで一部の行だけ読む |
| WHERE status = ‘pending’ | SCAN orders | status にはインデックスがないので全部読む |
| ORDER BY amount LIMIT 5 | SCAN orders と USE TEMP B-TREE FOR ORDER BY の 2 行 | 並べ替えのために一時的なデータを作る |
SELECT COUNT(*) のように必要な列がすべてインデックスに入っているときは「USING COVERING INDEX」と表示され、テーブル本体を読みません。SQLite の公式ドキュメントには「EXPLAIN QUERY PLAN の出力は対話的なデバッグ用で、形式はリリースによって変わることがある」とあります(3.24.0 で大きく変わりました)。
要らなくなったインデックスは DROP INDEX で消します。テーブルのデータは消えません。
DROP INDEX idx_orders_customer;この後で同じ EXPLAIN QUERY PLAN を実行すると「SCAN orders」に戻ります。
練習用スクリプトの cached_statements=0 を外すと、DROP INDEX の後でも EXPLAIN QUERY PLAN が古い「SEARCH … USING INDEX」を表示しました。Python から実行計画を見るときは注意してください。
1 回の測定はばらつくので、別のスクリプトで「同じ検索を 20 回実行した中央値(真ん中の値)」を測りました。あわせて、50 万行を INSERT する時間とファイルの大きさも、インデックスの数を変えて比べています。次のコードを sql_index_bench.py として保存し、実行します(一時フォルダーにデータベースファイルを作り、終わると削除します)。
import os, random, sqlite3, statistics, tempfile, time

random.seed(1)
st = ["shipped"] * 8 + ["pending", "cancelled"]
rows = [(i, random.randint(1, 100000), random.choice(st),
         f"2026-{random.randint(1, 9):02d}-{random.randint(1, 28):02d}",
         random.randint(1, 500) * 100) for i in range(1, 500001)]
cases = {
    "インデックスなし": [],
    "インデックス 1 個": ["customer_id"],
    "インデックス 3 個": ["customer_id", "ordered_on", "status, amount"],
}
with tempfile.TemporaryDirectory() as tmp:
    for n, (label, cols) in enumerate(cases.items()):
        path = os.path.join(tmp, f"bench{n}.db")
        con = sqlite3.connect(path)
        con.execute("CREATE TABLE orders (id INTEGER PRIMARY KEY, customer_id INTEGER,"
                    " status TEXT, ordered_on TEXT, amount INTEGER)")
        for k, c in enumerate(cols):
            con.execute(f"CREATE INDEX i{k} ON orders({c})")
        t = time.perf_counter()
        con.executemany("INSERT INTO orders VALUES (?, ?, ?, ?, ?)", rows)
        con.commit()
        ins = time.perf_counter() - t
        ms = []
        for _ in range(20):
            t = time.perf_counter()
            con.execute("SELECT * FROM orders WHERE customer_id = 12345").fetchall()
            ms.append((time.perf_counter() - t) * 1000)
        con.close()
        mb = os.path.getsize(path) / 1024 / 1024
        print(f"{label}: INSERT 50万行 {ins:.2f} 秒 / 検索 {statistics.median(ms):.3f} ミリ秒 / ファイル {mb:.1f} MB")
py sql_index_bench.pyインデックスなし: INSERT 50万行 0.31 秒 / 検索 18.227 ミリ秒 / ファイル 16.4 MB
インデックス 1 個: INSERT 50万行 1.54 秒 / 検索 0.028 ミリ秒 / ファイル 22.6 MB
インデックス 3 個: INSERT 50万行 6.85 秒 / 検索 0.030 ミリ秒 / ファイル 43.6 MB筆者の PC で 3 回実行し、毎回ほぼ同じ値(検索はインデックスなしで 18.2〜18.6 ミリ秒、ありで 0.027〜0.030 ミリ秒)でした。まとめると次のとおりです。
| 検索(customer_id = 12345) | 50 万行の INSERT | ファイルの大きさ | |
|---|---|---|---|
| インデックスなし | 約 18 ミリ秒 | 0.31 秒 | 16.4 MB |
| インデックス 1 個 | 約 0.028 ミリ秒(約 650 分の 1) | 1.54 秒(約 5 倍) | 22.6 MB |
| インデックス 3 個 | 約 0.030 ミリ秒 | 6.85 秒(約 22 倍) | 43.6 MB(約 2.7 倍) |
検索は劇的に速くなる一方で、INSERT は遅くなり、ファイルは大きくなります。これがインデックスの欠点です(後の章で説明します)。
複数の列をまとめたインデックスを複合インデックスといいます。「顧客ごとに、ある日以降の注文」を探すことが多いなら、customer_id と ordered_on の 2 列で作ります(ここからは、前の章のインデックスを DROP INDEX した状態で試しています)。
CREATE INDEX idx_orders_cust_date ON orders(customer_id, ordered_on);複合インデックスは、電話帳が「名字→名前」の順に並んでいるのと同じで、まず customer_id の順に並び、customer_id が同じ行の中で ordered_on の順に並びます。そのため、先頭の列(customer_id)を条件に使わないと、インデックスで探せません。
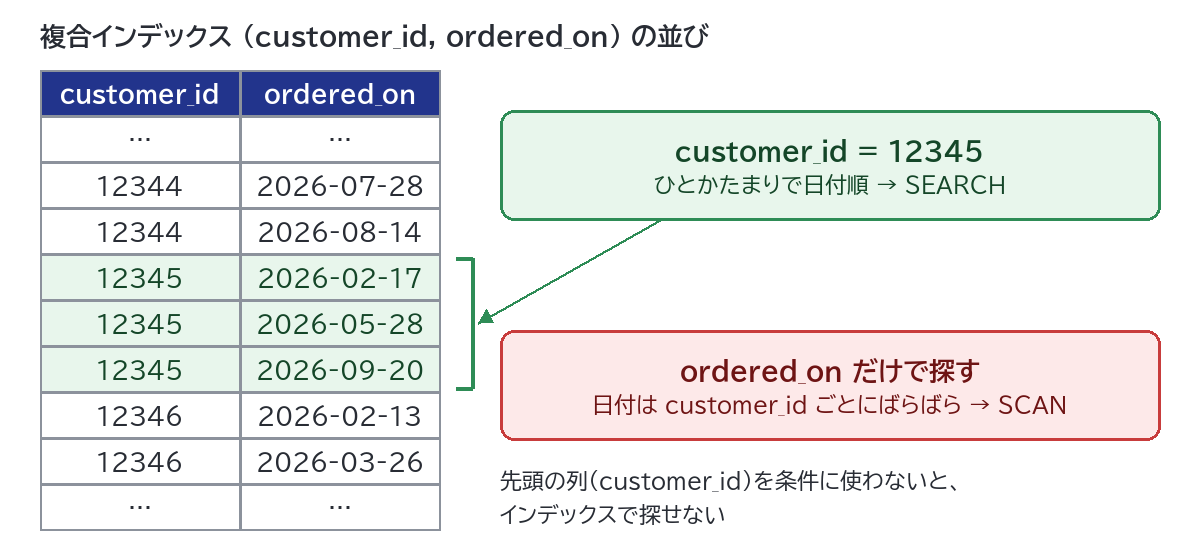
| WHERE | EXPLAIN QUERY PLAN の表示 |
|---|---|
| customer_id = 12345 AND ordered_on >= ‘2026-05-01’ | SEARCH orders USING INDEX idx_orders_cust_date (customer_id=? AND ordered_on>?) |
| customer_id = 12345 | SEARCH orders USING INDEX idx_orders_cust_date (customer_id=?) |
| ordered_on = ‘2026-05-28’ | SCAN orders |
| customer_id BETWEEN 12000 AND 12999 AND ordered_on = ‘2026-05-28’ | SEARCH orders USING INDEX idx_orders_cust_date (customer_id>? AND customer_id<?) |
ポイントは 3 つです。
SQLite の公式ドキュメント(The SQLite Query Optimizer Overview)でも「インデックスの先頭の列は = や IN で使う必要があり、使う列の一番右だけが不等号を使える」「使う列に抜けがあってはいけない」と説明されています。つまり、= で絞る列を先に、範囲で絞る列を後に並べるのが基本です。また、(customer_id, ordered_on) があれば、customer_id だけのインデックスは要りません(「Query Planning」にも、先頭部分が同じなら短いほうを消してよいとあります)。
インデックスがあっても、WHERE の書き方によっては使われません。ordered_on と customers.email にインデックスを作って確かめます。
CREATE INDEX idx_orders_date ON orders(ordered_on);
CREATE INDEX idx_customers_email ON customers(email);「2026 年 5 月の注文」を、注文日の先頭 7 文字で比べて書くと、インデックスは使われません。
EXPLAIN QUERY PLAN SELECT * FROM orders WHERE substr(ordered_on, 1, 7) = '2026-05';SCAN ordersインデックスに入っているのは ordered_on の値そのもので、substr(ordered_on, 1, 7) の値ではないからです。列には何もかけず、範囲で書き直します。
EXPLAIN QUERY PLAN SELECT * FROM orders WHERE ordered_on >= '2026-05-01' AND ordered_on < '2026-06-01';SEARCH orders USING INDEX idx_orders_date (ordered_on>? AND ordered_on<?)どちらも COUNT(*) は 55,507 件で同じ結果でしたが、時間は substr 版が 21.77 ミリ秒、範囲版が 0.95 ミリ秒でした。amount * 1.1 > 50000 のような計算や、lower(email) = '...' も同じく「SCAN」になりました。計算は列ではなく右側(定数の側)に寄せるのがコツです。
どうしても関数をかけた値で探したいときは、SQLite では 3.9.0 以降、式にインデックスを作れます。CREATE INDEX idx_customers_upper_email ON customers(upper(email)); を作ると、WHERE upper(email) = 'USER012345@EXAMPLE.COM' は SEARCH customers USING INDEX idx_customers_upper_email (<expr>=?) になりました。
「〜を含む」「〜で終わる」の LIKE は、インデックスでは探せません。索引で「〜で終わる言葉」を探せないのと同じです。
EXPLAIN QUERY PLAN SELECT * FROM customers WHERE email LIKE '%012345@example.com';SCAN customersここで注意したいのが、SQLite では前方一致の LIKE 'user0123%' も、普通のインデックスでは「SCAN customers」になったことです。SQLite の LIKE は既定で英字の大文字・小文字を区別しないため、公式ドキュメントでは、LIKE にインデックスが使われる条件の 1 つとして「列のインデックスが NOCASE(大文字・小文字を区別しない並べ方)で作られていること」が挙げられています。
CREATE INDEX idx_customers_email_nocase ON customers(email COLLATE NOCASE);このインデックスを作ると、LIKE 'user0123%' は SEARCH customers USING INDEX idx_customers_email_nocase (email>? AND email<?) になりました。LIKE '%0123%' は、このインデックスがあっても「SCAN」のままです。または、前方一致を email >= 'user0123' AND email < 'user0124' という範囲で書けば、普通のインデックスで SEARCH になりました。インデックスが使われる条件はデータベースごとに違うので、ほかのデータベースでも EXPLAIN で確かめてください。
customers.zip(郵便番号)は TEXT 型です。zip にインデックスを作って比べると、zip = '7326675'(文字列)も zip = 7326675(数値)も SEARCH customers USING INDEX idx_customers_zip (zip=?) になり、CAST(zip AS INTEGER) = 7326675 と zip + 0 = 7326675 は「SCAN customers」になりました。
SQLite は比べる前に値を列の型に合わせて変換する(公式ドキュメントの「型アフィニティ」の規則)ので、数値で比べてもインデックスが使われました。INTEGER 型の customer_id を customer_id = '12345' と文字列で比べても SEARCH でした。ただし、列の側を CAST や計算で変換すると、1 と同じ理由で使われません。
MySQL では事情が違います。MySQL の公式マニュアルには「文字列の列と数値を比べるとき、MySQL はその列のインデックスを使えない」とあり、SELECT * FROM tbl_name WHERE str_col=1; が例に挙がっています。’1’、’ 1’、’1a’ など、数値の 1 に変換される文字列がたくさんあるからです。SQLite で動いた SQL がほかのデータベースでも速いとは限らないので、値は列と同じ型で書く習慣を付けましょう。
計測の章で見たとおり、インデックスには代償があります。行を INSERT・UPDATE・DELETE するたびに、すべてのインデックスも並び順を保つように更新されるので、書き込みが遅くなり(3 個で INSERT が約 22 倍)、テーブルとは別のデータなので容量も増えます(16.4 MB が 43.6 MB)。検索に使わないインデックスや、先頭の列が同じで重複しているインデックスは、代償だけがかかるので消しましょう。
大量のデータを最初に入れるときは、インデックスなしで INSERT してから CREATE INDEX するほうが速くなることがあります。同じ 50 万行で試すと、「インデックス 3 個を先に作って INSERT」が 6.85 秒だったのに対し、「INSERT(0.31 秒)の後に 3 個を作る(0.55 秒)」は合計 0.86 秒でした(筆者の PC での値)。
また、条件に合う行がテーブルの大部分なら、インデックスを使っても速くなりません。SELECT * FROM orders WHERE ordered_on > '2026-01-01'(50 万行中 497,953 行が該当)は、インデックスを使う計画で約 500 ミリ秒、インデックスを使わせない書き方(列の前に + を付ける)の SCAN で約 400 ミリ秒と、むしろ SCAN のほうが速くなりました。インデックスが役立つのは「多くの行から少しだけ取り出す」検索です。
CREATE と INDEX の間に UNIQUE を書くと、検索を速くするだけでなく、同じ値の行を入れられなくなります。メールアドレスのように重複してはいけない列に使います(前の章の idx_customers_email を DROP INDEX してから作っています)。
CREATE UNIQUE INDEX idx_customers_email ON customers(email);INSERT INTO customers VALUES (100001, 'user000001@example.com', '1000001');エラー: UNIQUE constraint failed: customers.emailすでにある user000001@example.com は入れられませんでした。別のアドレスなら入ります。すでに重複した値がある列(orders.customer_id など)には、作ろうとしてもエラーになります。
テーブルを作るときに email TEXT UNIQUE と書いても、SQLite は自動で UNIQUE インデックス(sqlite_autoindex_users_1 のような名前)を作ります。また、SQLite の公式ドキュメントによると、UNIQUE インデックスでは NULL どうしは別の値として扱われ、NULL の行は何行でも入ります。実際に email が NULL の行を 2 行入れても、エラーになりませんでした。
EXPLAIN QUERY PLAN は SQLite の書き方です。MySQL と PostgreSQL では SQL の前に EXPLAIN を付けます。公式ドキュメントで確認できた範囲で、SCAN・SEARCH にあたる表示をまとめます(筆者は両方とも実機では試していません)。
| データベース | 書き方 | 全部読む | インデックスを使う |
|---|---|---|---|
| SQLite | EXPLAIN QUERY PLAN SELECT … | SCAN テーブル名 | SEARCH … USING INDEX |
| MySQL | EXPLAIN SELECT … | type 列が ALL | key 列に使うインデックス名(type は ref・range・const など) |
| PostgreSQL | EXPLAIN SELECT … | Seq Scan on テーブル名 | Index Scan using インデックス名 など |
MySQL の公式マニュアルでは、type が ALL は「フルテーブルスキャン」で、key 列が NULL なら使えるインデックスが見つからなかったことを表すと説明されています。PostgreSQL の EXPLAIN ANALYZE は SQL を実際に実行して時間を表示するので、UPDATE や DELETE に使うと本当にデータが変わります(公式ドキュメントには BEGIN と ROLLBACK で囲む例があります)。
要りません。SQLite の INTEGER PRIMARY KEY はテーブル自体がその順に並んでいるので、WHERE id = 5 は「SEARCH orders USING INTEGER PRIMARY KEY (rowid=?)」になりました。それ以外の PRIMARY KEY や UNIQUE 制約には、SQLite が自動でインデックスを作ります。
目安は、WHERE・JOIN の ON・ORDER BY によく出てきて、値で絞ると行がぐっと少なくなる列です。JOIN でつなぐ外部キーの列(この記事の customer_id)は代表例です。逆に、status のように値が 3 種類しかなく、1 つの値に大量の行が当たる列は、効果が小さくなりがちです。迷ったら、遅い SQL を EXPLAIN で見て「SCAN」になっているテーブルから考えます。
長い SQL の実行計画を読むときは、先に「SQL整形ツール」で WHERE や JOIN を改行して整えると、どの条件がどのテーブルにかかっているかを追いやすくなります。