Pythonのデコレーター入門|@の仕組みとfunctools.wrapsを実例で解説
hr
ENG LIFE BLOG
「フォルダーの中の .csv を全部読みたい」「ログファイルだけ集めたい」といったとき、Python では標準ライブラリの glob を使うと、*.csv のようなパターンでファイルを探せます。似た名前の fnmatch は、ファイルを探すのではなく「名前がパターンに合うか」を判定するモジュールです。
この記事では、Windows 11 の Python 3.12 で実際に動かした結果つきで、次のことを解説します。
*・?・[abc] の意味と glob.glob の基本** は recursive=True を付けないとサブフォルダーまで探さないこと[ を含む名前の探し方サンプルは、練習用の空のフォルダーに sample.py などの名前で保存し、PowerShell でそのフォルダーに移動してから実行してください。
py sample.pyどちらも、シェル(コマンドを打つ画面)でおなじみの * や ? を使った「ワイルドカード」のパターンを扱います。違いは、実際のフォルダーを見に行くかどうかです。
| モジュール | すること | 例 |
|---|---|---|
| glob | フォルダーの中を調べ、パターンに合うファイルのパスを返す | glob.glob(“data/*.csv”) → [‘data\\a.csv’, …] |
| fnmatch | 文字列がパターンに合うかを判定するだけ(ファイルは見ない) | fnmatch.fnmatch(“a.csv”, “*.csv”) → True |
| pathlib | Path.glob・rglob で glob と同じように探す。結果は Path | Path(“data”).glob(“*.csv”) |
この記事の例はすべて、次のスクリプトで作った practice フォルダーを使います。
from pathlib import Path

root = Path("practice")
files = [
    "a.txt", "b.txt", "c.txt", "readme.txt", "memo.md", ".secret.txt",
    "docs/guide.txt", "docs/sub/deep.txt",
    "logs/app1.log", "logs/app2.log", "logs/app10.log",
]
for name in files:
    p = root / name
    p.parent.mkdir(parents=True, exist_ok=True)
    p.write_text("x\n", encoding="utf-8")
print("作成しました:", len(files), "個")
practice
├── .secret.txt
├── a.txt
├── b.txt
├── c.txt
├── memo.md
├── readme.txt
├── docs
│ ├── guide.txt
│ └── sub
│ └── deep.txt
└── logs
├── app1.log
├── app10.log
└── app2.log.secret.txt のように . で始まる名前は「隠しファイル」として扱われることが多く、glob でも特別扱いされます(後で説明します)。Path の基本は「Pythonのpathlibの使い方」で解説しています。
| 記号 | 意味 | 例 |
|---|---|---|
| * | 0 文字以上の任意の文字列 | *.txt → a.txt、readme.txt |
| ? | 任意の 1 文字 | ?.txt → a.txt(readme.txt は不一致) |
| [abc] | a・b・c のどれか 1 文字 | [ab].txt → a.txt、b.txt |
| [0-9] | 0〜9 のどれか 1 文字(範囲) | app[0-9]*.log |
| [!abc] | a・b・c 以外の 1 文字 | app[!1]*.log → app2.log |
import glob

print(glob.glob("practice/*.txt"))
print(glob.glob("practice/?.txt"))
print(glob.glob("practice/[ab].txt"))
print(glob.glob("practice/logs/app?.log"))
print(glob.glob("practice/logs/app[0-9]*.log"))
print(glob.glob("practice/logs/app[!1]*.log"))
print(glob.glob("practice/*.csv"))
['practice\\a.txt', 'practice\\b.txt', 'practice\\c.txt', 'practice\\readme.txt']
['practice\\a.txt', 'practice\\b.txt', 'practice\\c.txt']
['practice\\a.txt', 'practice\\b.txt']
['practice/logs\\app1.log', 'practice/logs\\app2.log']
['practice/logs\\app1.log', 'practice/logs\\app10.log', 'practice/logs\\app2.log']
['practice/logs\\app2.log']
[][] で、エラーにはならないapp?.log は「app のあとに 1 文字」なので、2 文字の app10.log は入らない\\ は、リストの表示で \ が 2 つに見えているだけで、実際は 1 つ4 行目以降の practice/logs\\app1.log は、/ と \ が混ざっています。glob は「パターンに書いたフォルダー部分」はそのまま使い、見つけた名前を OS の区切り(Windows では \)でつなぐためです。Windows でもファイルは開けますが、表示をそろえたいときは os.path.join("practice", "logs", "app?.log") でパターンを作るか、後で紹介する pathlib を使うと、すべて practice\logs\app1.log の形になります。
* は 1 つのフォルダーの中の名前にしか一致せず、/ をまたぎません。いくつ下にあるか分からないファイルを探すには ** を使いますが、glob.glob では recursive=True を付けないと ** が働きません。
import glob

print("1:", glob.glob("practice/*.txt"))
print("2:", glob.glob("practice/*/*.txt"))
print("3:", glob.glob("practice/**/*.txt"))
print("4:", glob.glob("practice/**/*.txt", recursive=True))
1: ['practice\\a.txt', 'practice\\b.txt', 'practice\\c.txt', 'practice\\readme.txt']
2: ['practice\\docs\\guide.txt']
3: ['practice\\docs\\guide.txt']
4: ['practice\\a.txt', 'practice\\b.txt', 'practice\\c.txt', 'practice\\readme.txt', 'practice\\docs\\guide.txt', 'practice\\docs\\sub\\deep.txt']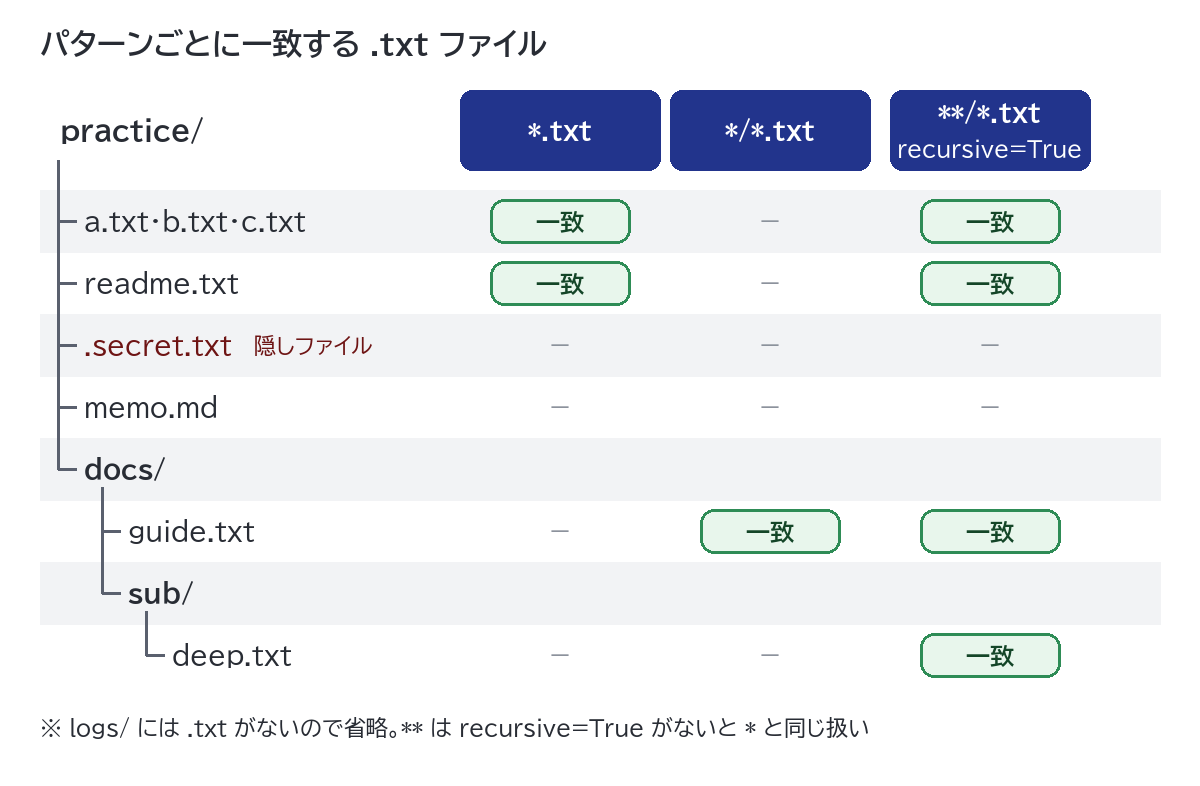
3 の結果が 2 とまったく同じになっているのがポイントです。recursive を付けないと ** はただの * と同じ扱いになり、「ちょうど 1 つ下のフォルダー」しか探しません。エラーも警告も出ないので、「深い場所のファイルが見つからない」ときはまず recursive=True を確かめてください。4 のとおり、** は「0 個以上のフォルダー」に一致するので、practice の直下のファイルも含まれます。
公式ドキュメントには「大きなフォルダーの木で ** を使うと、とても時間がかかることがある」と書かれています。C:/** のようにドライブ全体を探すのは避け、探す範囲をできるだけ絞りましょう。
上の 4 の結果は、直下のファイルが先で、docs の中があとになっていて、名前順ではありません。公式ドキュメントには「パスは特定の順番では返されない。順番が必要なら並べ替えること」「並ぶかどうかはファイルシステムによる」とあります。この PC(NTFS)では 1 つのフォルダーの中は名前順に見えましたが、別の OS やドライブで同じになるとは限りません。
import glob

print(sorted(glob.glob("practice/**/*.txt", recursive=True)))
['practice\\a.txt', 'practice\\b.txt', 'practice\\c.txt', 'practice\\docs\\guide.txt', 'practice\\docs\\sub\\deep.txt', 'practice\\readme.txt']「1 番目のファイルを使う」「処理の順番が結果に影響する」ときは、必ず sorted() を通してください。なお、文字列の並べ替えでは app10.log が app2.log より前に来ます(最初の例の 5 行目)。数字の大きさの順にしたいときは「Pythonのsortedとkey・lambdaで並べ替える」の key の使い方が参考になります。
ここまでの結果に .secret.txt が一度も出てこないことに気づいたでしょうか。glob.glob では、. で始まる名前には、. で始まるパターンでしか一致しません。Python 3.11 で追加された include_hidden=True を付けると、* でも一致するようになります。
import glob

print(glob.glob("practice/*.txt"))
print(glob.glob("practice/.*"))
print(glob.glob("practice/*.txt", include_hidden=True))
['practice\\a.txt', 'practice\\b.txt', 'practice\\c.txt', 'practice\\readme.txt']
['practice\\.secret.txt']
['practice\\.secret.txt', 'practice\\a.txt', 'practice\\b.txt', 'practice\\c.txt', 'practice\\readme.txt'].git や .env のような設定用のファイルを、うっかり処理の対象にしないための動きです。一方、後で説明する pathlib の Path.glob と fnmatch は、. で始まる名前を特別扱いしません。同じ *.txt でも結果が変わるので注意してください。
import glob

print(glob.glob("practice/*.TXT"))
print(glob.glob("practice/A.*"))
['practice\\a.txt', 'practice\\b.txt', 'practice\\c.txt', 'practice\\readme.txt']
['practice\\a.txt']Windows では *.TXT で a.txt が見つかり、結果には実際のファイル名(小文字)が入ります。glob が名前を比べるのに使う fnmatch.fnmatch は、比べる前に両方を os.path.normcase() で正規化し、Windows ではこれが小文字に変換するためです。Linux など(POSIX)の normcase は何も変えないので、大文字と小文字は区別されます。Windows で作ったスクリプトを Linux のサーバーで動かすと、見つかるファイルが減ることがある、と覚えておきましょう。
Windows でも区別したいときは、pathlib の Path.glob("*.TXT", case_sensitive=True)(Python 3.12 以降)を使うか、次の章の fnmatchcase で絞り込みます。
root_dir にフォルダーを渡すと、そこを基準に探し、結果もそのフォルダーからの相対パスになります。公式ドキュメントでは「glob を呼ぶ前にカレントディレクトリを変えるのと同じ効果」と説明されています(os.chdir で本当に移動するより安全です)。
import glob

print(glob.glob("**/*.log", root_dir="practice", recursive=True))
print(glob.glob("*.md", root_dir="practice"))
['logs\\app1.log', 'logs\\app10.log', 'logs\\app2.log']
['memo.md']glob.glob は見つけたパスを全部リストに入れてから返します。glob.iglob() は同じ結果を 1 件ずつ返す「イテレーター」で、全部をメモリーにためません。何万件もありそうなときや、最初に見つかった 1 件だけほしいときに向いています。
import glob

it = glob.iglob("practice/**/*.log", recursive=True)
print(type(it).__name__)
print(next(it))
for path in it:
    print(path)
print(list(it))
generator
practice\logs\app1.log
practice\logs\app10.log
practice\logs\app2.log
[]最後の [] のとおり、iglob の結果は一度読み終えると空になります。2 回使いたいときや並べ替えたいときは、glob.glob か sorted(glob.iglob(...)) でリストにします。仕組みは「Pythonのジェネレーター」で詳しく解説しています。
pathlib にも glob があり、結果が文字列ではなく Path で返るので、そのまま .name や .read_text() を使えます。
from pathlib import Path

root = Path("practice")
print(sorted(root.glob("*.txt")))
print(sorted(p.name for p in root.rglob("*.txt")))
print(sorted(p.name for p in root.glob("**/*.txt")))
print(sorted(root.glob("*.TXT", case_sensitive=True)))
p = next(root.glob("docs/*.txt"))
print(type(p).__name__, p.name, p.stem, p.parent)
[WindowsPath('practice/.secret.txt'), WindowsPath('practice/a.txt'), WindowsPath('practice/b.txt'), WindowsPath('practice/c.txt'), WindowsPath('practice/readme.txt')]
['.secret.txt', 'a.txt', 'b.txt', 'c.txt', 'deep.txt', 'guide.txt', 'readme.txt']
['.secret.txt', 'a.txt', 'b.txt', 'c.txt', 'deep.txt', 'guide.txt', 'readme.txt']
[]
WindowsPath guide.txt guide practice\docs| 項目 | glob.glob | Path.glob・rglob |
|---|---|---|
| 戻り値 | 文字列のリスト | Path を 1 件ずつ返す(ジェネレーター) |
| サブフォルダーまで | ** + recursive=True | ** だけでよい。rglob(“*.txt”) は glob(“**/*.txt”) と同じ |
| . で始まる名前 | * に一致しない(include_hidden=True で一致) | * に一致する |
| 大文字・小文字 | OS に従う | OS に従う。case_sensitive で指定可(3.12 以降) |
| 順番 | 決まっていない | 決まっていない |
1 行目の結果に .secret.txt が入っているのが、glob.glob との大きな違いです。隠しファイルを除きたいときは if not p.name.startswith(".") で外します。見つけたファイルをそのまま読み書きするなら pathlib のほうが短く書けます。
fnmatch はファイルを探さず、手元にある文字列をパターンと比べます。os.walk で集めた名前や、ZIP の中の名前、API から受け取ったファイル名の一覧などを絞り込むときに使います。
import fnmatch

print(fnmatch.fnmatch("report.TXT", "*.txt"))
print(fnmatch.fnmatchcase("report.TXT", "*.txt"))
print(fnmatch.fnmatch(".secret.txt", "*.txt"))
print(fnmatch.fnmatch("logs/app1.log", "*.log"))

names = ["main.py", "test_main.py", "README.md", "test_util.py", "setup.cfg"]
print(fnmatch.filter(names, "test_*.py"))
print([n for n in names if not fnmatch.fnmatch(n, "*.py")])
True
False
True
True
['test_main.py', 'test_util.py']
['README.md', 'setup.cfg']| 関数 | すること |
|---|---|
| fnmatch(name, pat) | 合えば True。両方を os.path.normcase で正規化してから比べる(Windows では大文字・小文字を区別しない) |
| fnmatchcase(name, pat) | どの OS でも大文字・小文字を区別して比べる |
| filter(names, pat) | 合う名前だけのリストを返す |
| filterfalse(names, pat) | 合わない名前だけを返す(Python 3.14 で追加。3.12 では上のコードのように内包表記で書く) |
1 行目の True は Windows での結果です。Linux など(POSIX)では os.path.normcase が何も変えないため、fnmatch.fnmatch("report.TXT", "*.txt") は False になります。どの OS でも同じ結果にしたいときは fnmatchcase を使いましょう。また、3 行目・4 行目のとおり fnmatch は . で始まる名前も、/ をまたぐ名前も * に一致させます。公式ドキュメントにも「区切りの / と、先頭のピリオドはこのモジュールでは特別ではない」とあり、glob.glob とは動きが違います。
shutil.copytree の shutil.ignore_patterns("*.pyc") もこの fnmatch のパターンを使っています(「Pythonのshutilの使い方」参照)。
フォルダー名やファイル名に [ ] * ? が入っていると、それがパターンの記号として解釈されます。report[2026] というフォルダーで試します。
import glob
from pathlib import Path

d = Path("report[2026]")
d.mkdir(exist_ok=True)
(d / "sales.csv").write_text("x\n", encoding="utf-8")
(d / "stock.csv").write_text("x\n", encoding="utf-8")

print(glob.glob("report[2026]/*.csv"))
print(glob.escape("report[2026]"))
print(glob.glob(glob.escape("report[2026]") + "/*.csv"))
print(glob.glob("*.csv", root_dir="report[2026]"))
print(sorted(Path("report[2026]").glob("*.csv")))
[]
report[[]2026]
['report[2026]\\sales.csv', 'report[2026]\\stock.csv']
['sales.csv', 'stock.csv']
[WindowsPath('report[2026]/sales.csv'), WindowsPath('report[2026]/stock.csv')]1 行目が空なのは、[2026] が「2・0・6 のどれか 1 文字」と解釈され、report2 などのフォルダーを探したためです。glob.escape() は [・*・? を [[] のように角かっこで囲み、「ただの文字」として扱わせます(] は単独なら記号にならないので、そのまま残ります)。ユーザーが入力したフォルダー名や、日付入りのフォルダー名をパターンに埋め込むときは、パターンにしない部分を必ず escape すると覚えておきましょう。
root_dir に渡したフォルダー名と、Path(“…”) の部分はパターンとして解釈されないので、escape なしでも見つかります。
ワイルドカードと正規表現は、同じ記号でも意味が違います。正規表現の * は「直前の文字のくり返し」で、. が「任意の 1 文字」です。fnmatch.translate() で、ワイルドカードを正規表現に変換して比べてみます。
import fnmatch
import re

print(fnmatch.translate("*.txt"))
print(fnmatch.translate("app?.log"))
print(fnmatch.translate("[!a]*"))
print(bool(re.fullmatch(r"app\d+\.log", "app10.log")))
print(fnmatch.fnmatch("app10.log", "app?.log"))
(?s:.*\.txt)\Z
(?s:app.\.log)\Z
(?s:[^a].*)\Z
True
False| 意味 | ワイルドカード | 正規表現 |
|---|---|---|
| 任意の文字列 | * | .* |
| 任意の 1 文字 | ? | . |
| ドットそのもの | . | \. |
| 〜以外の 1 文字 | [!a] | [^a] |
| 数字が 1 文字以上 | 書けない | \d+ |
| A または B | 書けない({a,b} も使えない) | (A|B) |
「app のあとに数字がいくつか」のような細かい条件はワイルドカードでは書けないので、glob で大まかに集めてから re で絞り込みます。正規表現の記号は「正規表現の基本」と「Pythonの正規表現入門」で解説しています。
なお、Python 3.13 では glob.translate() が追加されました。fnmatch.translate と違って / の区切りを意識し、* が / をまたがない正規表現を作ります(recursive・include_hidden も指定できます)。この記事で使った 3.12 にはないので、紹介だけにとどめます。
import shutil
from pathlib import Path

src = Path("practice")
dst = Path("backup")
dst.mkdir(exist_ok=True)

for p in sorted(src.rglob("*.txt")):
    if p.name.startswith("."):
        continue
    target = dst / p.relative_to(src)
    target.parent.mkdir(parents=True, exist_ok=True)
    shutil.copy2(p, target)
    print(p, "->", target)
practice\a.txt -> backup\a.txt
practice\b.txt -> backup\b.txt
practice\c.txt -> backup\c.txt
practice\docs\guide.txt -> backup\docs\guide.txt
practice\docs\sub\deep.txt -> backup\docs\sub\deep.txt
practice\readme.txt -> backup\readme.txtrelative_to(src) で practice からの相対パスを取り出し、backup の下に同じ構成を作っています。移動や削除をする処理に書き換えるときは、先にこのように print だけで対象を確かめてから実行してください。ZIP にまとめたいときは「Pythonのzipfileの使い方」が参考になります。
| 症状 | 原因 | 直し方 |
|---|---|---|
| サブフォルダーのファイルが見つからない | ** を書いたが recursive=True がない | glob.glob(…, recursive=True) か Path.rglob |
| .env や .gitignore が見つからない | glob.glob の * は . で始まる名前に一致しない | include_hidden=True(3.11 以降)か “.*” のパターン |
| 結果が空の [] なのにエラーにならない | フォルダー名の打ち間違い・カレントディレクトリの違い | 空なら止める処理を入れる。print(os.getcwd()) で場所を確かめる |
| [ ] 入りの名前が見つからない | [ ] がパターンの記号になった | glob.escape() でパターンにしない部分を囲む |
| *.{txt,md} が何にも一致しない | { } は glob の記号ではない | パターンを分けて探すか、suffix で絞る |
glob が見るのは名前だけです。名前で集めたあと、os.path.getmtime() や Path.stat().st_size で絞り込みます。コマンドラインで日時やサイズを条件に探すなら、Linux・Git Bash の find コマンドが得意です(「findコマンドの使い方」参照)。